
Citation Gap Analizi: Rakibinizi Kaynak Gösteren Siteleri Bulup PR Hedefine Çevirmek
Yapay zeka cevaplarında rakibinizi kaynak gösteren üçüncü taraf domainleri çıkarmak, erişilebilirlik ve etkiye göre sıralamak ve 6502 sayılı Kanun ile Wikipedia kurallarına uygun bir PR ve iş birliği hedef listesine çevirmek için sekiz adımlık rehber.
💡Kısa Özet
Citation gap analizi, AI cevaplarında rakibinizi destekleyen üçüncü taraf siteleri bulup sizin eksik olduğunuz kaynakları PR hedefine çevirir. University of Toronto'ya göre AI arama, ABD tüketici elektroniği sorgularında kaynaklarının %92,1'ini earned medyadan seçiyor. Sheltron'un 9 Ağustos 2026 taramasında 16 AI Overview 93 kaynak gösterdi; 'en iyi geo ajansı' cevabının ilk beş kaynağından ikisi yayın sitesiydi.
Ana Çıkarımlar
- •Citation gap analizi, içerik açığı analizinin bir katman altıdır: rakibin göründüğü sorguları değil, o cevabı besleyen üçüncü taraf domainleri çıkarır ve çıktısı bir PR ve iş birliği hedef listesidir.
- •University of Toronto'nun 1.000 promptluk çalışmasında AI arama, ABD otomotiv sorgularında kaynaklarının %81,9'unu earned medyadan seçti; Google'ın klasik sonuçlarında bu oran %45,1'di.
- •Ahrefs'in 75.000 markalık analizinde marka web bahsi AI Overviews görünürlüğüyle 0,664, backlink sayısı yalnız 0,218 korelasyon gösterdi.
- •Sheltron'un 9 Ağustos 2026 taramasında 16 AI Overview 93 kaynak listeledi; 'geo vs seo' sorgusunda organik 5. sıra, AI Overview kaynağı olmaya yetmedi.
- •SparkToro'ya göre aynı soru 100 kez sorulduğunda iki cevabın aynı marka listesini verme olasılığı 100'de 1'in altında; gap sorguları farklı günlerde en az üç kez çalıştırılmalı.
- •Gemini grounding kaynakları çoğu zaman vertexaisearch yönlendirme adresiyle döner; yönlendirme çözülmeden domain sayımı yanıltır.
- •Ücretli liste yerleşimi 6502 sayılı Kanun'un 61. maddesi gereği açıkça reklam olarak etiketlenmeli, link rel="sponsored" ile işaretlenmelidir.
Citation gap analizi, yapay zeka cevaplarında rakibinizi kaynak gösteren ya da ondan bahseden üçüncü taraf siteleri bulup sizin yer almadığınız kaynakları bir PR ve iş birliği hedef listesine çeviren yöntemdir. Bu katmanın neden önemli olduğunu tek bir rakam özetliyor: University of Toronto'nun 1.000 promptluk çalışmasında AI arama, ABD tüketici elektroniği sorgularında kaynaklarının %92,1'ini markaların kendi sitelerinden değil, üçüncü taraf (earned) yayınlardan seçti (Chen ve ark., 2025).
Rakibiniz bir yapay zeka cevabında öneriliyorsa, bunun sebebi çoğu zaman rakibin sitesi değil; onu anan bir liste yazısı, bir haber, bir forum başlığı ya da bir dizin kaydıdır. Bu rehber o kaynakları sistematik biçimde çıkarmayı, erişilebilirlik ve etkiye göre sıralamayı ve ortaya çıkan listeyi kurallara uygun bir outreach planına dönüştürmeyi adım adım anlatıyor. Örnekler Sheltron'un 9 Ağustos 2026 tarihli Google AI Overviews taramasından, araç adımları ise ücretsiz araçlarımızın yayın tarihi itibarıyla çalışma biçimine dayanıyor.
Citation gap analizi nedir ve içerik açığı analizinden farkı ne?
Citation gap analizi, belirli bir sorguda yapay zeka cevabının rakibinizi hangi domainlere dayanarak önerdiğini çıkarır ve bu domainlerden sizin eksik olduklarınızı listeler. İçerik açığı analizi rakibin görünür olduğu sorguları bulur; citation gap bir katman aşağı iner ve o cevabı besleyen kaynak siteleri, yani ulaşmanız gereken yayınları gösterir.
İki analiz birbirinin alternatifi değil, ardışık iki adımdır. İçerik açığı analizi size "rakibim 'en iyi X' sorusunda görünüyor, ben görünmüyorum" bilgisini verir. Bu bilgiyle yeni bir sayfa yazabilirsiniz; ancak yapay zeka o sorguda sizin sayfanızdan çok başkalarının sizin hakkınızda yazdıklarına bakıyorsa yeni sayfa tek başına yetmez. Citation gap analizi tam bu noktada devreye girer: aynı cevabın altındaki kaynak listesini açar, rakibin adını taşıyan üçüncü taraf sayfaları bulur ve her birinin sizin için ulaşılabilir bir hedef olup olmadığını sorar.
Kavramın genel çerçevesi için GEO nedir sayfamıza, yapay zeka motorlarının neden bazı siteleri sürekli kaynak gösterdiğine dair arka plan için ise citation gravity yazımıza bakabilirsiniz.
| Boyut | İçerik açığı analizi | Citation gap analizi |
|---|---|---|
| Cevapladığı soru | Rakip hangi sorgularda görünüyor, ben hangilerinde yokum? | Rakibi o sorguda hangi siteler destekliyor, ben hangilerinde yokum? |
| Ham veri | Sorgu listesi, sıralama ve atıf durumu | AI cevaplarının kaynak URL'leri ve domainleri |
| Analiz birimi | Sorgu | Kaynak domain |
| Tipik çıktı | Yazılacak ya da güncellenecek sayfa listesi | PR, iş birliği ve profil hedef listesi |
| İşin sahibi | İçerik ve SEO ekibi | PR, iletişim ve iş geliştirme |
| Başarı ölçüsü | Sorgu bazında görünürlük | Hedef domainde marka bahsi ve sorgu bazında görünme sıklığı |
Tablonun son satırı işin doğasını özetliyor: citation gap analizinin başarısı sizin sitenizde değil, başkalarının sitesinde ölçülür. Bu yüzden çıktısı bir içerik takvimi değil, bir ilişki listesidir.
AI cevapları rakibi neden kendi sitesinden çok üçüncü taraf kaynaklarla öneriyor?
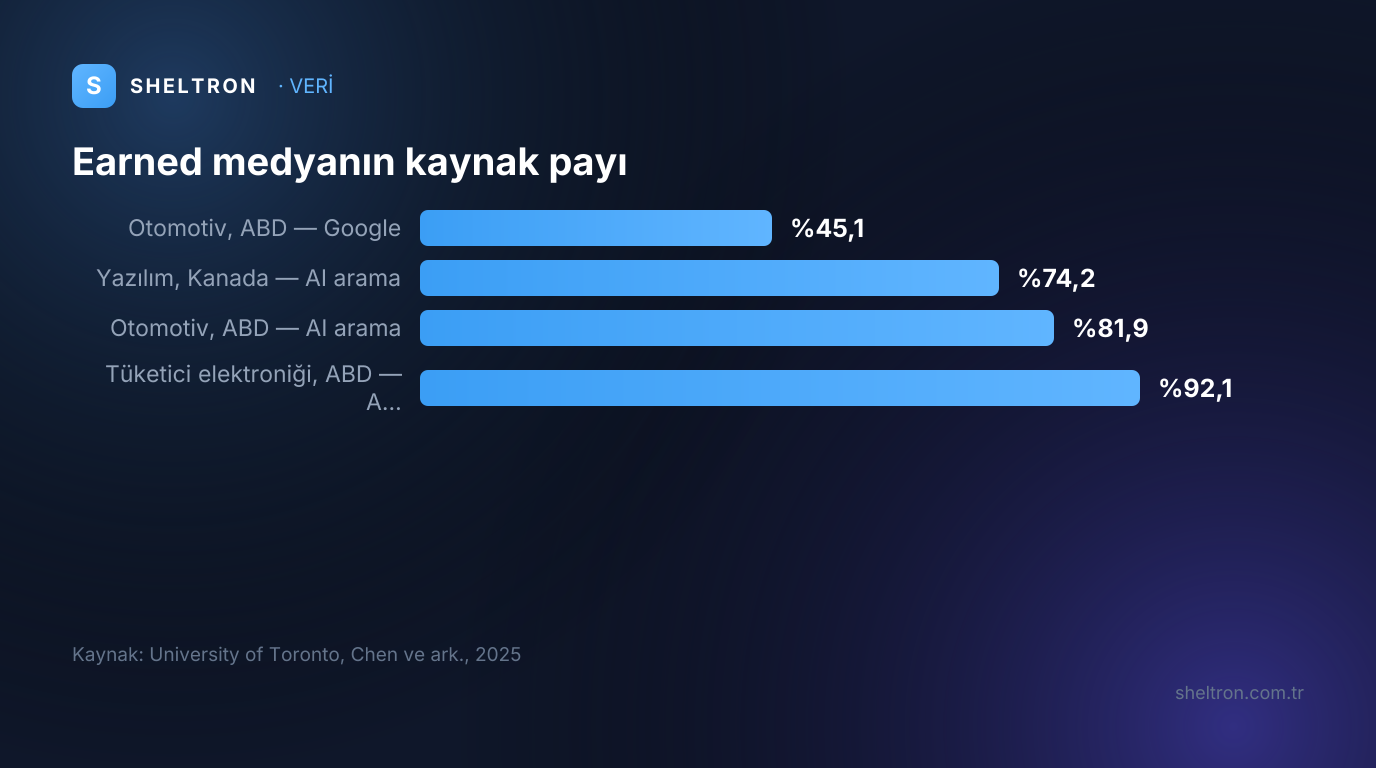
Üretken arama motorları kaynak seçerken markanın kendisi hakkında söylediklerinden çok, başkalarının o marka hakkında yazdıklarına ağırlık veriyor. University of Toronto çalışmasında AI arama, ABD otomotiv sorgularında kaynaklarının %81,9'unu earned medyadan seçti; aynı sorgularda Google'ın klasik sonuçlarında bu oran %45,1'de kaldı.
Chen, Wang, Chen ve Koudas'ın Eylül 2025'te yayımlanan çalışması, ABD ve Kanada'da 10 kategoride 1.000 tüketici sıralama promptunu inceledi. Yazarlar, AI aramanın marka sitesi ve sosyal içerik yerine üçüncü taraf, otoriter kaynaklara "sistematik ve ezici" bir yönelim gösterdiğini raporluyor. Oran kategoriye göre değişiyor: Kanada'daki yazılım sorgularında AI aramanın kaynaklarının %74,2'si earned, %25,8'i marka sitesiydi; sosyal içerik payı ise sıfırdı. Çalışma, ürün odaklı sorgularda Google sonuçlarıyla AI cevaplarının görece az örtüştüğünü de not ediyor. Başka bir deyişle, organikte iyi sıralanmanız AI cevabının kaynak listesinde yer alacağınız anlamına gelmiyor.
Platformların tercih ettiği kaynak tipi de farklı. Profound'un Ağustos 2024 ile Haziran 2025 arasındaki 680 milyon atıfı kapsayan analizi bu farkı iki ayrı ölçüyle veriyor: platformun tüm atıfları içindeki genel pay ve en çok atıf alan ilk 10 kaynak içindeki pay. Bu iki ölçü karıştırılmamalı; ilk 10 içindeki pay genel atıf hacmini göstermez.
| Platform | Öne çıkan kaynak | Tüm atıflar içindeki pay | En çok atıf alan ilk 10 kaynak içindeki pay |
|---|---|---|---|
| ChatGPT | Wikipedia | %7,8 | %47,9 |
| Perplexity | %6,6 | %46,7 | |
| Google AI Overviews | %2,2 | %21,0 |
Kaynak: Profound, AI Platform Citation Patterns, 2025.
Pratik sonuç açık: ChatGPT'de rakibi destekleyen kaynak bir ansiklopedi maddesi, Perplexity'de bir forum başlığı olabilir; tek platformdan çıkarılan hedef listesi eksik kalır. Ahrefs'in 75.000 markalık analizi de aynı yöne işaret ediyor. Marka web bahsi AI Overviews görünürlüğüyle 0,664, backlink sayısı ise yalnız 0,218 korelasyon gösterdi ve markaların %26'sı AI Overviews'ta hiç anılmadı (Ahrefs, 2025). Marka bahsinin neden bağlantıdan daha güçlü bir sinyal olduğunu marka bahsi rehberimizde ayrıntılı ele aldık. Citation gap analizi ise o marka bahsini hangi sitelerden almanız gerektiğini veriye dayanarak seçmenizi sağlar.
Sheltron'un AI Overviews verisi citation gap'i nasıl gösteriyor?
Sheltron'un 9 Ağustos 2026'da taradığı 20 marka dışı sorgunun 16'sında AI Overview çıktı ve sitemiz bunların 6'sında kaynak gösterildi. Bu 16 AI Overview toplam 93 kaynak listeledi; her birinin ilk beş kaynağı ise 49 farklı domaine dağılıyordu. Kaybedilen sorguların kaynak listeleri, citation gap'in iki katmanını da açıkça gösteriyor.
Aşağıdaki tabloda, Google Search Console'da gösterim aldığımız sorgulardan seçtiğimiz dört açık örneği ve kontrol grubu olarak kaynak gösterildiğimiz bir sorgu yer alıyor. Domainler, AI Overview'un listelediği ilk beş kaynaktır.
| Sorgu | AI Overview'un ilk beş kaynağı | Organik sıramız | AI Overview kaynağı mıyız? | Açığın tipi |
|---|---|---|---|---|
| en iyi geo ajansı | crabsmedia.com, partner ajans sitesi*, t24.com.tr, metafor.com, teknotalk.com | 18 | Hayır | Haber sitesi ve teknoloji yayını |
| geo vs seo | semrush.com, zeo.org, ofgmedya.com, digitalmarketinginstitute.com, linkedin.com | 5 | Hayır | Global otorite, Türk ajans blogları ve profesyonel ağ |
| geo ne demek | limasollunaci.com, roipublic.com, upgraphics.com.tr, tr.wikipedia.org, tureng.com | 22 | Hayır | Ansiklopedi ve sözlük |
| yapay zeka arama optimizasyonu faydaları nelerdir? | developers.google.com, bulutistan.com, seoptimer.com, ttrbilisim.com, metafor.com | 19 | Hayır | Ajans ve SEO blogları (1 resmi doküman) |
| geo danışmanlığı | sheltron.com.tr, analyticahouse.com, protan.com.tr, kentmedia.com.tr, alisdijital.com | 2 | Evet | Kontrol grubu |
* Ekosistem partnerimiz olan ajansın sitesi. Ajans niyetli sorguların partnere yönelmesi bilinçli bir tercih olduğu için bu kaynak açık olarak sayılmadı.
Tablodan dört ders çıkıyor. Birincisi, "en iyi geo ajansı" cevabının ilk beş kaynağından ikisi ajans değil, yayın: t24.com.tr bir haber sitesi, teknotalk.com bir teknoloji yayını. Bu açık, sitemize yeni bir sayfa ekleyerek değil, o yayınlarda anılarak kapanır; citation gap analizinin üçüncü taraf katmanı tam olarak budur.
İkincisi, organik sıra kaynak olmayı garanti etmiyor. 9 Ağustos 2026'da "geo vs seo" sorgusunda organik olarak 5. sıradaydık; AI Overview ise kaynaklarını Semrush gibi global otoritelerden, iki Türk ajans blogundan ve LinkedIn'den seçti. Google'ın AI özellikleri dokümanı, AI Overviews ve AI Mode'un alt konulara bölünmüş çok sayıda ilişkili arama yapan "query fan-out" tekniğini kullanabileceğini söylüyor. Rakibi destekleyen kaynak, sizin hedef sorgunuzda değil bir alt sorguda sıralanıyor olabilir. Kaynak seçimindeki bu mekanizmayı AI Overview kaynak gösterme rehberimizde ayrıca ele aldık.
Üçüncüsü, her açık bir PR hedefi değildir. "geo ne demek" sorgusunun kaynakları sözlük ve ansiklopedi; bu tür açıklar içerik biçimiyle, örneğin net bir tanım bloğuyla kapanır. "Yapay zeka arama optimizasyonu faydaları nelerdir?" sorgusunda da resmi dokümanın (developers.google.com) editörüne ulaşılamaz; ancak aynı listedeki ajans, hosting ve SEO aracı blogları ulaşılabilir hedeftir.
Dördüncüsü, aynı domain birden çok sorguda tekrar ediyor. 9 Ağustos 2026 taramasında metafor.com 16 AI Overview'un 5'inde, ttrbilisim.com 4'ünde ilk beş kaynak arasındaydı; ikisi de kaybettiğimiz "yapay zeka arama optimizasyonu faydaları nelerdir?" sorgusunun listesinde yer alıyor. Aşağıda Adım 5'te anlatılan etki ölçüsünün kendi verimizdeki karşılığı budur: birden çok sorguda tekrar eden domain, hedef listesinde üst sıraya çıkar.
Türkçe sorgularda hangi kaynak tiplerinin öne çıktığına dair genel tablo için Türkçe sorgularda LLM kaynakları yazımıza, ölçüm yöntemimizin ayrıntısı için GEO ölçüm rehberimize bakabilirsiniz.
Gap sorgularını rakip karşılaştırma aracıyla nasıl bulursunuz?
İlk iş, rakibin atıf aldığı ama sizin almadığınız sorguları bulmaktır. Sheltron Rakip Karşılaştırma aracına kendi domaininizi ve bir ya da iki rakibi, satın alma niyetli en fazla beş sorguyla girin; araç her sorguyu web aramalı bir modelle (Amazon Nova web araması) çalıştırır ve hangi domainin hangi sorguda kaynak gösterildiğini bir matriste verir.
Adım 1: Sorgu setini kurun
Güvenilir bir analiz için 20-30 sorguluk bir set yeterli bir başlangıçtır. Seti üç kaynaktan besleyin:
- Search Console: Gösterim aldığınız ticari niyetli sorgular. Bunlar pazarın gerçekten sorduğu ifadelerdir.
- Karar kalıpları: "en iyi X", "X alternatifleri", "X mi Y mi", "X yorumları" gibi, yapay zekanın marka listelediği sorular.
- Satış görüşmeleri: Müşterinin teklif aşamasında sorduğu ve rakibin adını andığı sorular.
Tanım sorgularını ("X nedir") sete ekleyebilirsiniz, ancak yukarıdaki tablonun gösterdiği gibi bu sorguların kaynakları çoğunlukla sözlük ve ansiklopedi olur; PR hedefi üretmezler.
Adım 2: Gap sorgularını işaretleyin
Rakip Karşılaştırma aracı iki ya da üç domaini en fazla beş serbest sorguyla karşılaştırır. Her sorgu bir kez çalışır ve tüm domainler aynı cevaptan değerlendirilir. Çıktıda bahsedilme oranına göre sıralama ve domain × sorgu atıf matrisi yer alır. Rakibin atıf aldığı, sizin almadığınız her satır bir gap sorgusudur. Otuz sorguluk bir set beşerli altı çalıştırma demektir; araç IP başına günde iki karşılaştırmaya izin verdiği için bu set üç güne yayılır.
Araç, karşılaştırılan domainlerin hiçbiri atıf almadığında cevapta kaynak gösterilen diğer domainlerin ilk üçünü adıyla, kalanların sayısını ise toplu olarak gösterir. Bu liste başlı başına bir sinyaldir: o sorgu sizin ya da rakibinizin değil, üçüncü taraf sitelerin elindedir ve doğrudan citation gap listesine girer.
Tek çalıştırmaya güvenmeyin. SparkToro ile Gumshoe'nun 12 prompt ve 2.961 çalıştırmalık testine göre ChatGPT ya da Google'ın yapay zekasına aynı soru 100 kez sorulduğunda iki cevabın aynı marka listesini verme olasılığı 100'de 1'in altında (SparkToro, 2026). Bu yüzden aynı seti farklı günlerde en az üç kez çalıştırın ve rakibin kaç çalıştırmada göründüğünü sayın. Günlük sınır nedeniyle otuz sorguluk bir setin üç tekrarı Rakip Karşılaştırma aracında en az dokuz gün sürer; ölçüm takvimini buna göre kurun. Tekrar sayısının ve payda seçiminin mantığını AI share of voice metodolojisi yazımızda, rakip analizinin genel çerçevesini ise AI görünürlük rakip analizi rehberimizde bulabilirsiniz.
Rakibi destekleyen kaynak domainleri nasıl çıkarıp sınıflandırırsınız?
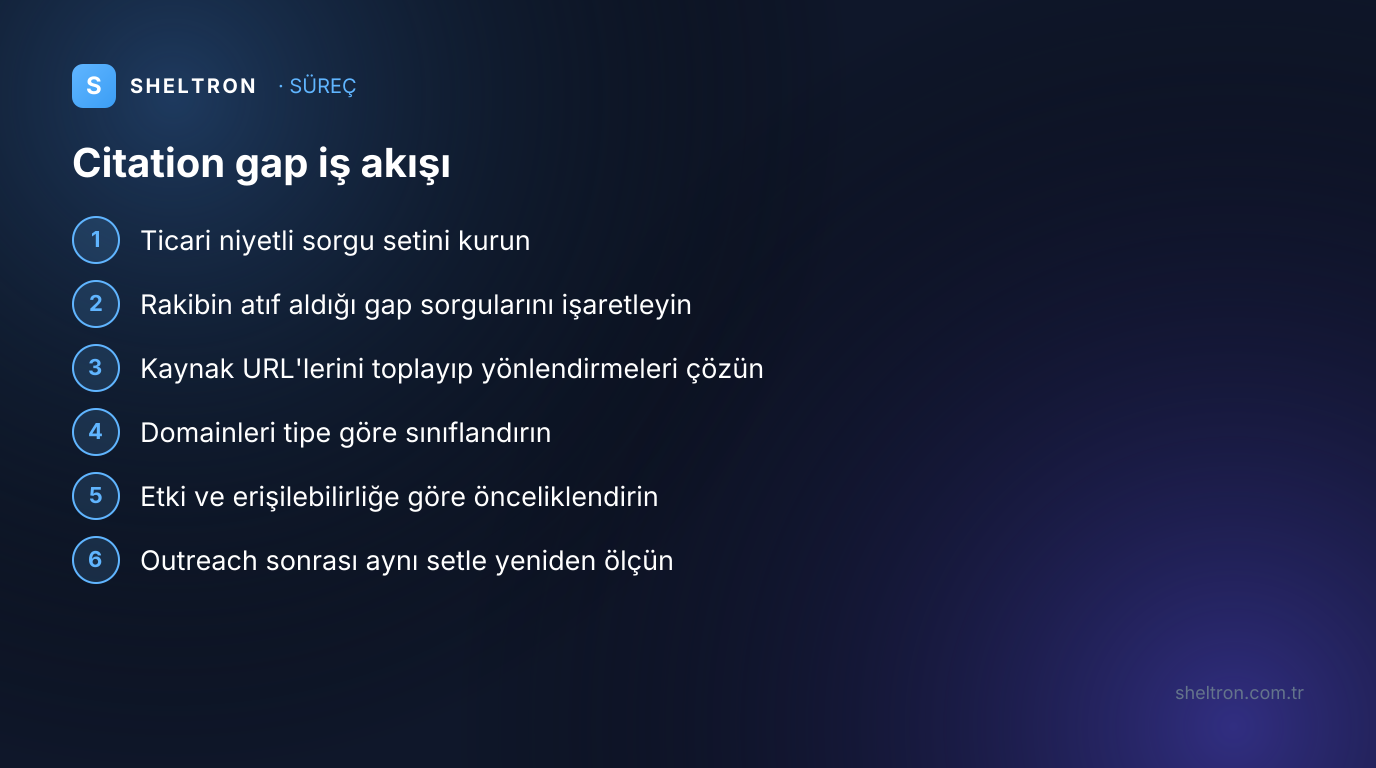
Gap sorgularını spot-check aracında rakibin domainiyle çalıştırın ya da ChatGPT, Perplexity ve Google'da elle sorun; her cevabın kaynak URL'lerini kaydedip domaine indirgeyin ve her domaine bir kaynak tipi atayın. Kaynakları Gemini API ile topluyorsanız, dönen yönlendirme adreslerini çözmeden yapılan domain sayımı yanıltıcı sonuç verir.
Adım 3: Kaynak listesini toplayın
AI Görünürlük Spot Check aracı bir domain için beş şablon sorgu çalıştırır; bunların arasında "Türkiye'de en iyi {Marka} alternatifleri" ve "{Marka} müşteri yorumları ve deneyimi" gibi kalıplar vardır. Sonuç ekranı her sorguda girilen domainin kaynak gösterilip gösterilmediğini ve beş sorgu boyunca en sık kaynak gösterilen beş domaini listeler. Citation gap için püf nokta şudur: araca kendi domaininizi değil, rakibin domainini girin. Böylece rakibin alternatifleri ve yorumları sorulduğunda web aramalı modelin en çok hangi üçüncü taraf sitelere dayandığını görürsünüz. Aracın ayrıntılı kullanımını spot-check iş akışı yazımızda anlattık.
Aracın iki sınırını bilerek kullanın. Spot-check'e özel sorgu girilmez; kendi gap sorgularınızı ChatGPT ve Perplexity'de elle çalıştırıp kaynak listelerini kaydetmeniz gerekir. Ayrıca aracın "en çok atıf alan rakipler" özeti Facebook, Twitter, Instagram, LinkedIn, YouTube, Wikipedia, Wikidata, Reddit ve Medium alan adlarını toplamdan çıkarır; bu eleme yalnız ana alan adlarına uygulanır, tr.wikipedia.org gibi alt alan adları ve x.com toplamda kalır. Profound verisinin gösterdiği gibi bu platformlar kaynak listelerinde ağırlıklıdır; onları elle çalıştırdığınız sorguların kaynak listelerinden okuyun.
Kendi atıf raporlarınız bu işi yapmaz. Bing Webmaster Tools'un Şubat 2026'da önizlemeye açılan AI Performance raporu toplam atıf ve grounding sorgularını yalnız doğrulanmış kendi siteniz için gösterir. Rakibin kaynaklarını görmenin yolu, sorguyu dışarıdan çalıştırıp kaynak listesini toplamaktır.
Yönlendirme adresini çözün
Gemini API'nin Google Search grounding dokümanı, akışı şöyle tarif ediyor: model aramaya gerek olup olmadığına karar verir, gerekiyorsa bir ya da birden çok sorgu üretip çalıştırır ve sonuçları sentezler. API referansına göre generateContent yanıtındaki groundingMetadata alanında modelin attığı sorgular webSearchQueries, kaynaklar ise groundingChunks altında web.uri ve web.title olarak döner. webSearchQueries alanı, rakibin hangi alt sorgu üzerinden bulunduğunu gösterdiği için ayrıca kaydedilmeye değer.
Tuzak web.uri alanındadır: bu adres çoğu zaman gerçek kaynak yerine bir vertexaisearch.cloud.google.com yönlendirmesidir. 9 Ağustos 2026 tarihli LLM atıf ölçümümüzde Gemini kayıtlarında bu adres 9 kez kaynak domain olarak görünüyordu. Gemini API'yi kendiniz kullanıyorsanız yönlendirmeyi bir HEAD isteğiyle çözebilirsiniz:
// Yönlendirmeyi takip edip gerçek kaynak URL'sine ulaş
const res = await fetch(uri, { method: "HEAD", redirect: "follow" })
const gercekUrl = res.url || uri
Adım 4: Domainleri sınıflandırın
URL'leri domaine indirdikten sonra her birine tek bir tip atayın. Önerdiğimiz yedi tip şunlardır:
- Rakip sitesi: Rakibin kendi sayfası. Açık kapatılmaz, yalnız izlenir.
- Haber ve yayın: Gazete, sektör dergisi, teknoloji yayını.
- Liste ve karşılaştırma yazısı: "En iyi 10 X" türü editoryal içerik.
- Dizin ve inceleme platformu: Firma rehberleri, yazılım ve hizmet inceleme siteleri.
- Forum ve kullanıcı içeriği: Reddit, Ekşi Sözlük, LinkedIn gönderileri, soru-cevap siteleri.
- Ansiklopedi ve sözlük: Wikipedia, çeviri sözlükleri.
- Resmi kurum ve doküman: Devlet siteleri, platformların kendi dokümantasyonu.
Kaynak domainleri erişilebilirlik ve etkiye göre nasıl önceliklendirirsiniz?
Her domaini iki eksende puanlayın: etki, yani kaç gap sorgusunda, kaç platformda ve kaç çalıştırmada göründüğü; erişilebilirlik, yani iletişim yolu, katkı politikası ve ücretli yerleşim gerekip gerekmediği. İki eksende de yüksek çıkan domainler ilk 60 günün hedef listesini oluşturur; yalnız birinde yüksek çıkanlar sonraki dalgaya kalır.
Adım 5: Etkiyi hesaplayın
Etkiyi üç sayıyla ölçün: domainin göründüğü gap sorgusu sayısı, göründüğü platform sayısı ve toplam çalıştırmaların kaçında göründüğü. Üç gap sorgusunda, iki platformda ve çalıştırmaların çoğunda görünen bir liste yazısı, tek bir cevapta bir kez görülmüş bir haberden daha değerli bir hedeftir. Varyans yüksek olduğu için tek çalıştırmada görülen domainleri hedef listesine değil, ayrı bir izleme listesine alın.
Adım 6: Erişilebilirliği puanlayın
Erişilebilirlik için dört soru yeterli: Editöre ya da yazara ulaşmanın açık bir yolu var mı? Yayının konuk yazı, uzman görüşü ya da düzeltme politikası var mı? Yerleşim ücretli mi, ücretliyse etiketleniyor mu? Yayın, yapay zeka arama botlarına açık mı? Son soru ChatGPT açısından önemli: OpenAI'ın tarayıcı dokümanına göre OAI-SearchBot, sitelerin ChatGPT'nin arama özelliklerinde gösterilmesi için kullanılıyor. Bu botu engelleyen bir yayında yer almak ChatGPT tarafında daha az değer üretir; hedef yayının robots.txt dosyasını AI bot kontrol aracıyla kontrol edebilirsiniz.
Kaynak tipine göre erişim yolu ve dikkat edilecek kural değişir:
| Kaynak tipi | Tipik erişim yolu | Dikkat edilecek kural |
|---|---|---|
| Haber ve yayın | Özgün veri ya da uzman görüşüyle pitch | Ücretli içerik açıkça "reklam" olarak etiketlenir |
| Liste ve karşılaştırma yazısı | Güncelleme ya da düzeltme talebi, kanıtla birlikte | Ücretli yerleşimde etiket ve rel="sponsored" |
| Dizin ve inceleme platformu | Profil açmak, bilgileri tamamlamak | Çalışanların yorum yazması açıklama gerektirir |
| Forum ve kullanıcı içeriği | Şeffaf katılım, kimliği açık uzman cevabı | Şirketle bağ her mesajda açık olmalı |
| Ansiklopedi ve sözlük | Tartışma sayfasında öneri | Çıkar çatışması beyanı, doğrudan düzenleme yok |
| Resmi kurum ve doküman | Doğrudan erişim yok | İçeriğinizde bu kaynaklara atıf verin |
Hedef listesini paylaşılabilir bir tabloda tutun. Aşağıdaki sütunlar, analizden outreach'e ve yeniden ölçüme kadar aynı dosyayla çalışmanızı sağlar:
| Sütun | Ne yazılır |
|---|---|
| Kaynak domain | Yönlendirmesi çözülmüş, www'suz alan adı |
| Kaynak tipi | Yedi tipten biri |
| Gap sorguları | Domainin göründüğü sorguların listesi |
| Platformlar | Gemini, ChatGPT, Perplexity, Google AI Overviews |
| Frekans | Görüldüğü çalıştırma / toplam çalıştırma |
| Rakip nasıl geçiyor | Liste sırası, alıntı, marka adı ya da link |
| Erişim yolu | Editör, yazar, profil formu, tartışma sayfası |
| Ücret ve etiket | Ücretsiz, ücretli ve etiketli, belirsiz |
| Öncelik | Yüksek, orta, düşük |
| Aksiyon ve sorumlu | Pitch, güncelleme talebi, profil; kimin işi olduğu |
| Yeniden ölçüm tarihi | Outreach'ten 30-60 gün sonrası |
Liste yazılarına, forumlara ve Wikipedia'ya girmenin kuralları neler?
Ücretli bir liste yerleşimi Türkiye'de açıkça "reklam" olarak belirtilmek zorundadır: 6502 sayılı Kanun'un 61. maddesi, reklam olduğu belirtilmeden yazı ve haberlerde marka tanıtımını örtülü reklam sayar ve yasaklar. Wikipedia'da ise şirketinizle ilgili maddeyi doğrudan düzenlemek yerine tartışma sayfasında öneri yapmanız beklenir.
Adım 7: Kanalı kurallara göre seçin
6502 sayılı Tüketicinin Korunması Hakkında Kanun, reklam olduğu açıkça belirtilmeden yazı, haber, yayın ve programlarda mal veya hizmetlere ilişkin isim, marka ya da logonun tanıtıcı biçimde yer almasını örtülü reklam olarak tanımlıyor ve her türlü iletişim aracında yasaklıyor. Citation gap listesindeki bir liste yazısına ücret karşılığı girmeyi düşünüyorsanız, etiket pazarlık konusu değildir.
Aynı yerleşimin link tarafı Google'ın kurallarına tabidir. Google'ın spam politikaları, ücretli linklerin rel="sponsored" ya da rel="nofollow" ile işaretlenmesi hâlinde ihlal sayılmadığını belirtiyor. Aynı politika, üçüncü taraf içeriğin bir sitede esas olarak o sitenin sıralama gücünden yararlanmak için yayımlandığı durumları "site itibarı istismarı" olarak ele alıyor. Bu nedenle otoriter bir yayının alt klasörüne o yayınla ilgisi olmayan ücretli içerik yerleştirmek, citation gap'i kapatmanın değil yeni bir risk üretmenin yoludur.
ABD merkezli yayınlarda FTC'nin Endorsement Guides açıklamaları geçerlidir: maddi bağlantı açık ve belirgin biçimde duyurulmalıdır ve bir inceleme sitesinde yorum yazan çalışanın bu bağı açıklaması gerekir. Forumlarda da aynı ilke işler: Reddit ya da Ekşi Sözlük'te şirket çalışanı olduğunu gizleyerek ürün övmek örtülü reklam riski doğurur ve ortaya çıktığında markaya kazandırdığından fazlasını kaybettirir.
Wikipedia'da kural daha da nettir. Türkçe Vikipedi'nin çıkar çatışması yönergesi, bağlantılı olduğunuz maddeleri açıklama yapmadan düzenlemeyi kesinlikle önermiyor; ilişkinizi ifşa etmenizi ve değişiklik önerilerini tartışma sayfasına bırakmanızı istiyor. İngilizce Wikipedia'nın ücretli katkı açıklama politikası da ücretli editörlerin kimin için çalıştığını açıklamasını şart koşuyor.
Kurallara uygun en verimli kanal çoğu zaman haber ve yayınlardır: gazeteciye özgün bir veri seti ya da isim verilerek alıntılanabilecek bir uzman görüşü sunmak hem etiket sorununu ortadan kaldırır hem de kalıcı bir marka bahsi üretir. Türk medyasında bu tür bir pitch akışının nasıl kurulacağını HARO sonrası Türkçe PR stratejisi yazımızda ayrıntılı anlattık. Bu bölüm genel bilgilendirme amaçlıdır ve hukuki tavsiye yerine geçmez.
Outreach sonrası citation gap'in kapandığını nasıl ölçersiniz?
Aynı sorgu setini aynı platformlarda ve aynı çalıştırma sayısıyla 30-60 gün sonra yeniden ölçün. Başarı, tek bir cevapta görünmek değil; hedef domainde markanızın anılması ve çok sayıda çalıştırmada sizin görünme sıklığınızın artmasıdır. Ölçüm koşulları değişirse iki sonuç arasındaki fark yöntemden de kaynaklanabilir.
Adım 8: Üç soruyla yeniden ölçün
SparkToro araştırması, marka listeleri bu kadar değişkenken birçok çalıştırmada görünme sıklığının (visibility %) makul bir metrik olduğunu söylüyor. Yeniden ölçümde bu metriği üç soruya bağlayın:
- Hedef domainde markanız anıldı mı? Yayımlanan haber, güncellenen liste ya da açılan profil. Marka bahislerinin takibi için marka takibi aracını kullanabilirsiniz.
- O domain gap sorgularında hâlâ kaynak mı? Yapay zeka kaynak listesini değiştirmiş olabilir; markanızın anıldığı yayın artık o cevapta kullanılmıyorsa, kazanç sınırlı kalır.
- Sizin görünme sıklığınız değişti mi? İlk ölçümdekiyle aynı sayıda çalıştırmada sizin kaç kez kaynak gösterildiğiniz.
Kendi atıflarınız için Bing Webmaster Tools'un AI Performance raporunu da tabloya ekleyin; toplam atıf ve grounding sorgularındaki değişim, Copilot tarafında dışarıdan ölçümü tamamlar.
Ölçüm kapsamını doğru raporlayın
Sonuçları raporlarken ölçüm kapsamını açıkça yazın. Sheltron'un ücretsiz araçları sorguları tek bir web aramalı model (Amazon Nova web araması) üzerinden ölçer; kullanılan model araç sayfasındaki yöntem notunda yazar ve raporunuza bu adı da eklemelisiniz. ChatGPT ve Perplexity kaynak listeleri için elle çalıştırma ya da ücretli çok platformlu araçlar gerekir. Ahrefs Brand Radar bunlardan biri; Ahrefs'in kendi beyanına göre araç aylık yüz milyonlarca promptu kapsıyor. Hangi aracı seçerseniz seçin, ilk ölçüm ile yeniden ölçümün aynı platform, aynı sorgu ve aynı çalıştırma sayısıyla yapılması şarttır.
Bu disiplini kendimize de uyguluyoruz. Sheltron'un 9 Ağustos 2026 tarihli backlink profilinde 444 backlink'in %78'i kendi ekosistemimizden geliyordu; 29 ana referring domain içinde bağımsız site sayısı yalnız 8'di. Yukarıdaki tabloda kaybedilen sorguların kaynak listeleri, kendi hedef listemiz için de doğal aday; playbook'umuzdaki hedef, bağımsız referring domain sayısını 8'den 20'nin üzerine çıkarmak. Yapay zeka motorlarının atıf mekanizmasına dair araştırma özetlerini First Citation üzerinden, GEO kavramlarının daha geniş arka planını ise The GEO Authority yayınlarından takip edebilirsiniz.
Rakibinizin hangi yayınlarda anıldığını ve sizin hangi kaynak listelerinde eksik kaldığınızı birlikte çıkarmak isterseniz Sheltron hızlı değerlendirme formunu doldurun; ilk gap sorgularınızı ve ulaşılabilir hedef domainleri birlikte belirleyelim.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Citation Gap Analizi: Rakibinizi Kaynak Gösteren Siteleri Bulup PR Hedefine Çevirmek
- TL;DR
- Citation gap analizi, AI cevaplarında rakibinizi destekleyen üçüncü taraf siteleri bulup sizin eksik olduğunuz kaynakları PR hedefine çevirir. University of Toronto'ya göre AI arama, ABD tüketici elektroniği sorgularında kaynaklarının %92,1'ini earned medyadan seçiyor. Sheltron'un 9 Ağustos 2026 taramasında 16 AI Overview 93 kaynak gösterdi; 'en iyi geo ajansı' cevabının ilk beş kaynağından ikisi yayın sitesiydi.
- Ana Çıkarımlar (7)
- Citation gap analizi, içerik açığı analizinin bir katman altıdır: rakibin göründüğü sorguları değil, o cevabı besleyen üçüncü taraf domainleri çıkarır ve çıktısı bir PR ve iş birliği hedef listesidir.
- University of Toronto'nun 1.000 promptluk çalışmasında AI arama, ABD otomotiv sorgularında kaynaklarının %81,9'unu earned medyadan seçti; Google'ın klasik sonuçlarında bu oran %45,1'di.
- Ahrefs'in 75.000 markalık analizinde marka web bahsi AI Overviews görünürlüğüyle 0,664, backlink sayısı yalnız 0,218 korelasyon gösterdi.
- Sheltron'un 9 Ağustos 2026 taramasında 16 AI Overview 93 kaynak listeledi; 'geo vs seo' sorgusunda organik 5. sıra, AI Overview kaynağı olmaya yetmedi.
- SparkToro'ya göre aynı soru 100 kez sorulduğunda iki cevabın aynı marka listesini verme olasılığı 100'de 1'in altında; gap sorguları farklı günlerde en az üç kez çalıştırılmalı.
- Gemini grounding kaynakları çoğu zaman vertexaisearch yönlendirme adresiyle döner; yönlendirme çözülmeden domain sayımı yanıltır.
- Ücretli liste yerleşimi 6502 sayılı Kanun'un 61. maddesi gereği açıkça reklam olarak etiketlenmeli, link rel="sponsored" ile işaretlenmelidir.
- Kaynaklı Veriler
- %92,1 — ABD tüketici elektroniği sorgularında AI aramanın kaynaklarında earned (üçüncü taraf) medyanın payı (University of Toronto — Chen, Wang, Chen, Koudas, Generative Engine Optimization: How to Dominate AI Search, 2025)
- %81,9 — ABD otomotiv sorgularında AI aramanın earned medya payı; Google'ın klasik sonuçlarında %45,1 (University of Toronto — Chen ve ark., 2025)
- %74,2 — Kanada yazılım sorgularında AI aramanın earned medya payı; marka sitesi %25,8, sosyal içerik %0 (University of Toronto — Chen ve ark., 2025)
- 680 milyon — Profound'un Ağustos 2024–Haziran 2025 arasında analiz ettiği yapay zeka atfı sayısı (Profound — AI Platform Citation Patterns, 2025)
- %47,9 — ChatGPT'nin en çok atıf verdiği ilk 10 kaynak içinde Wikipedia'nın payı (genel atıf hacmi değil) (Profound — AI Platform Citation Patterns, 2025)
- %46,7 — Perplexity'nin ilk 10 kaynağı içinde Reddit'in payı; Google AI Overviews'ta %21,0 (Profound — AI Platform Citation Patterns, 2025)
- 0,664 — marka web bahsinin AI Overviews marka görünürlüğüyle Spearman korelasyonu; backlink sayısı için 0,218 (Ahrefs — AI Overview Brand Visibility (75.000 marka), 2025)
- %26 — AI Overviews'ta hiç bahsi geçmeyen marka oranı (Ahrefs — AI Overview Brand Visibility, 2025)
- 100'de 1'den az — ChatGPT ya da Google'ın yapay zekasına aynı soru 100 kez sorulduğunda iki cevabın aynı marka listesini verme olasılığı (2.961 çalıştırma) (SparkToro ve Gumshoe, 2026)
- 16 — Sheltron'un 9 Ağustos 2026'da taradığı 20 marka dışı sorgudan AI Overview çıkanların sayısı; sheltron.com.tr 6'sında kaynak (Sheltron ölçümü (AI Overviews kapsama taraması, 9 Ağustos 2026), 2026)
- 93 — 16 AI Overview'un listelediği toplam kaynak sayısı; her birinin ilk beş kaynağı 49 farklı domaine dağılıyor (Sheltron ölçümü (AI Overviews kapsama taraması, 9 Ağustos 2026), 2026)
- 8 — Sheltron'un 29 ana referring domaini içindeki bağımsız site sayısı; 444 backlink'in %78'i ekosistem kaynaklı (Sheltron ölçümü (backlink profili, DataForSEO, 9 Ağustos 2026), 2026)
- Arama Niyetleri
- citation gap analizi
- atıf açığı analizi
- rakibimi ai hangi kaynaklardan öneriyor
- ai kaynak domain analizi
- ai cevabında rakibi destekleyen siteler
- ai atıf kaynaklarına girme
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz