
ChatGPT Ne Zaman Web Araması Yapar? 15 Türkçe Soruda Arama Tetikleme ve Eğitim Verisine Kalan Cevaplar
ChatGPT'nin web aramasını hangi durumlarda başlattığını OpenAI'ın resmî dokümanları ve 15 Türkçe sorguluk ölçümle açıklıyor; aramasız cevapların eğitim verisinden nasıl üretildiğini ve içerik stratejisinin iki niyete göre nasıl ayrılacağını gösteriyor.
💡Kısa Özet
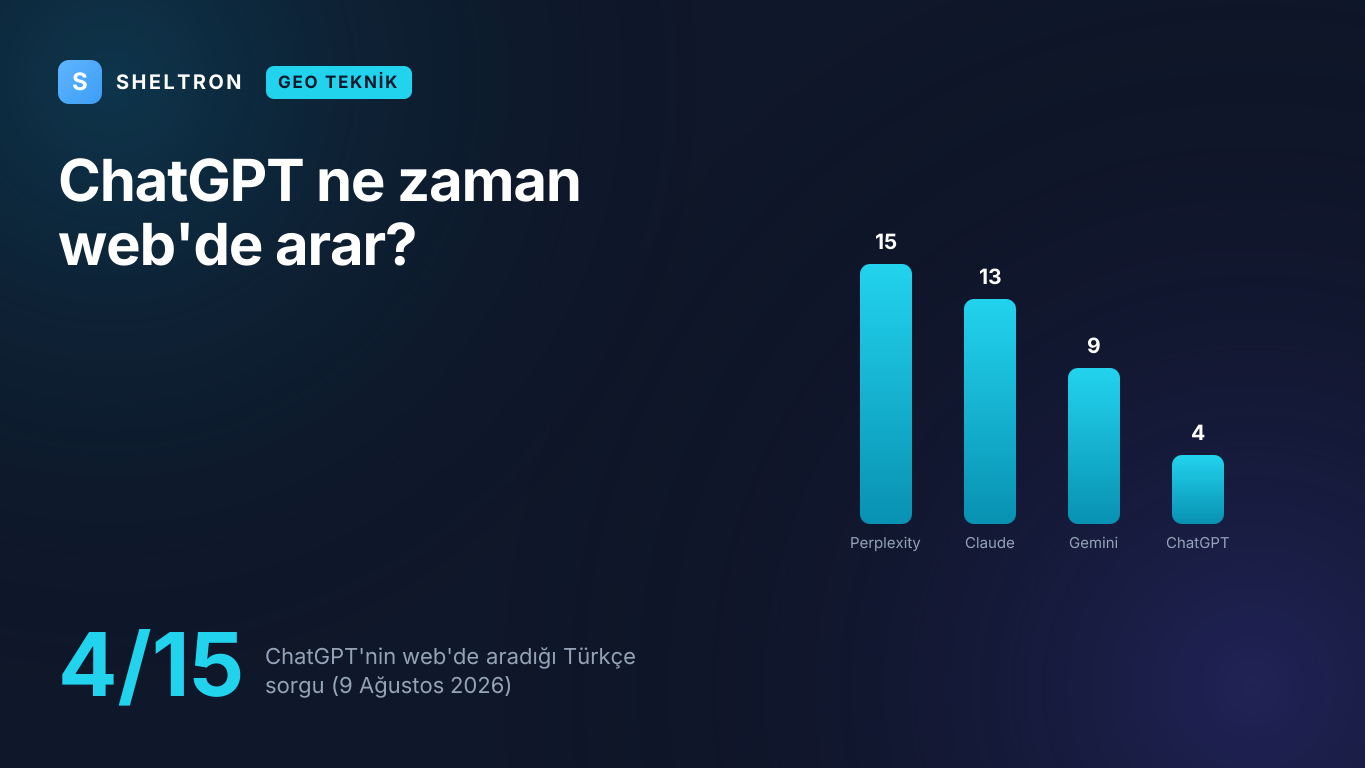
ChatGPT her soruda web'de aramaz; soru güncel bilgiden fayda görecekse arar. 9 Ağustos 2026 ölçümümüzde o4-mini, arama izni açıkken 15 Türkçe sorgunun 4'ünde web'e çıktı; Perplexity 15, Claude 13, Gemini 9 sorguda aradı. Aramasız 'GEO nedir' cevabı GEO'yu 'Coğrafi Hedefleme' diye tanımladı. Nectiv'de genel arama oranı %31, yerel sorgularda %59.
Ana Çıkarımlar
- •9 Ağustos 2026 ölçümünde ChatGPT (o4-mini, API, arama zorlanmadan) 15 Türkçe sorgunun 4'ünde web'de aradı; Perplexity 15, Claude 13, Gemini 9 sorguda aradı.
- •Dört platformun hiçbiri arama yapmadığı soruda kaynak listelemedi; ChatGPT'nin aradığı 4 sorgunun 4'ünde kaynak vardı, sheltron.com.tr yalnız 1'inde kaynak gösterildi.
- •Aramasız 'GEO nedir' cevabında ChatGPT GEO'yu 'Coğrafi Hedefleme' diye tanımladı; aynı soruda arama yapan 3 platform Generative Engine Optimization dedi.
- •OpenAI'ın resmî metinlerinde 4 tetikleyici var: güncel bilgi, anlık veri, yerellik ve elle seçim; marka adı tetikleyicisi yazılı değil.
- •o4-mini'nin bilgi kesim tarihi 1 Haziran 2024; bu tarihten sonra kurulan bir marka modelin aramasız cevabında yer alamaz.
- •Arama oranı ölçüme göre değişir: Nectiv %31 (yerel %59), Semrush Şubat 2026'da %34,5, Graphite varlık karşılaştırmada %58.
- •Graphite'a göre doğal olarak arama yapılmayan prompt'larda aramayı zorlamak marka görünürlüğünü ortalama 20,3 puan saptırıyor; grounding oranı ayrı raporlanmalı.
ChatGPT her soruda web'de arama yapmaz. OpenAI'ın yardım sayfasına göre model, soru güncel bilgiden fayda görecekse arar. Aramadığında cevap modelin eğitim verisinden öğrendiklerinden gelir. Sheltron'un 9 Ağustos 2026 ölçümünde ChatGPT (o4-mini, API) arama izni açıkken 15 Türkçe sorgunun yalnız 4'ünde web'e çıktı. Nectiv'in 8.500'den fazla prompt'luk çalışmasında bu oran %31.
Bu ayrım görünürlük açısından belirleyicidir. Arama yapılan cevapta siteniz kaynak olarak seçilebilir. Arama yapılmayan cevapta ise model, eğitim sırasında öğrendiklerini yazar; markanız o bellekte yoksa atıf alamazsınız, hatta faaliyet alanınız yanlış tanımlanabilir. Ölçümümüzde aramasız "GEO nedir" cevabı, GEO'yu "Coğrafi Hedefleme" olarak açıkladı.
ChatGPT her soruda web'de arama yapar mı?
Hayır. ChatGPT web aramasını her soruda değil, sorunun güncel bilgiden fayda göreceğine karar verdiğinde yapar. OpenAI bunu resmî yardım sayfasında böyle tanımlar; kullanıcıya aramayı elle başlatma seçeneği de sunar. Ölçümümüzde o4-mini, arama izni açıkken 15 Türkçe sorgunun 11'ini hiç web'e çıkmadan cevapladı.
OpenAI'ın Ekim 2024'teki ChatGPT search duyurusu da aynı ilkeyi koyar: ChatGPT, ne sorduğunuza bakarak web'de arayıp aramayacağını kendisi seçer; isterseniz arama simgesine tıklayarak aramayı elle başlatırsınız. Güncel arayüzde bu seçim araçlar menüsündeki Search seçeneğiyle ya da mesaj kutusuna "/" yazılarak yapılır.
API tarafında karar daha görünürdür. OpenAI'ın web search aracı rehberine göre tool_choice: "auto" ayarında arama isteğe bağlıdır; model gerekli görürse arar. tool_choice: "required" ise aramayı her istekte zorunlu kılar. Akıl yürüten (reasoning) modellerde model, bir kez aradıktan sonra aramaya devam edip etmeyeceğine de kendisi karar verir.
Bu mantık yalnız OpenAI'a özgü değildir. Anthropic'in web search dokümanı, Claude'un ne zaman arayacağına isteme bakarak kendisinin karar verdiğini yazar; Google'ın Gemini dokümanı da modelin istemi analiz edip Google Araması'nın cevabı iyileştirip iyileştirmeyeceğine karar verdiğini belirtir. Platformlar arasındaki fark, kararın hangi eşikte verildiğindedir.
Web araması tetikleme, bir dil modelinin soruyu cevaplamadan önce dış kaynağa başvurup başvurmayacağına verdiği karardır; arama yapılmayan cevapta kaynak listesi oluşmaz.
Tüketici tarafında aramanın ne sıklıkla devreye girdiğine dair dış çalışmaların genel ortalamaları %31 ile %34,5 arasında. Nectiv'in 9 sektörde 8.500'den fazla prompt'u incelediği çalışmada ChatGPT isteklerin %31'inde en az bir arama yaptı. Semrush'ın ABD tıklama akışı verisine göre arama yapılan sorgu payı 2024 sonunda %46'ydı, Şubat 2026'da %34,5'e indi; dönem içinde ölçülen değerler %15 ile %66,3 arasında dalgalandı. Bu verilere göre doğal kullanımda soruların çoğu web'e hiç çıkmadan cevaplanıyor.
Aramadığında cevap nereden gelir: parametrik bellek nedir?
Parametrik bellek, modelin eğitim sırasında ağırlıklarına (parametrelerine) işlenen bilgidir. Arama yapılmayan cevap canlı bir sayfadan değil, bu ağırlıklardan üretilir. OpenAI, modellerin eğitim verisinin kopyasını saklamadığını, eğitimle parametrelerin ayarlandığını belirtir. Aynı sayfaya göre aynı soru, farklı denemelerde farklı cevaplar alabilir; bu yüzden aramasız cevap tek koşuda değerlendirilmemelidir.
OpenAI'ın modellerin nasıl geliştirildiğini anlatan sayfasına göre eğitim verisi üç kaynaktan gelir: internette herkese açık bilgiler, üçüncü taraflardan lisanslanan içerikler ve kullanıcılar, insan eğiticiler ile araştırmacıların sağladığı veriler. Bu verinin bir bitiş tarihi vardır. OpenAI'ın model sayfasına göre ölçümde kullandığımız o4-mini'nin bilgi kesim tarihi 1 Haziran 2024.
Bunun pratik sonucu nettir. 2025'te kurulan Sheltron, o4-mini'nin belleğinde yer alamaz; bu modelin cevabında görünmesinin tek yolu web aramasıdır. Aynı durum, o4-mini açısından 2024 ortasından sonra kurulan her marka, açılan her şube ve yaygınlaşan her kavram için geçerlidir.
Bir marka, kullanılan modelin bilgi kesim tarihinden sonra kurulduysa ChatGPT'nin aramasız cevabında yer alamaz; görünmenin tek yolu web aramasıdır.
Kesim tarihinden önce var olan markalar için de bellek güvenilir değildir. Mallen ve arkadaşlarının ACL 2023'te yayımlanan çalışması, 14.000 soruluk PopQA veri kümesiyle 10 modeli test etti ve dil modellerinin az bilinen olgusal bilgide zorlandığını, model büyütmenin bu uzun kuyruktaki ezberi belirgin biçimde iyileştirmediğini gösterdi. Aynı çalışma, dış kaynağa yalnız gerektiğinde başvuran uyarlamalı bir yaklaşım önerir. Türkiye'deki bir KOBİ ya da yeni bir hizmet kategorisi, küresel eğitim verisinde çoğu zaman bu uzun kuyrukta yer alır.
Aramanın doğruluğa etkisi OpenAI'ın kendi ölçümlerinde de görülür. OpenAI'ın SimpleQA makalesinde (2024) GPT-4o aramasız olarak soruların %38,2'sini, GPT-4o-mini ise %8,6'sını doğru cevapladı. OpenAI'ın Mart 2025'teki ajan araçları duyurusunda aynı ailenin arama yapan önizleme sürümleri aynı testte %90 ve %88 aldı. Bu rakamlar farklı zamanlarda ve farklı model sürümlerinde raporlandı; yine de aramasız ve aramalı cevap arasındaki mesafeyi göstermeye yeter.
OpenAI hangi durumlarda aramayı tetiklediğini söylüyor?
OpenAI'ın resmî metinlerinde dört tetikleyici açıkça geçer: güncel bilgi ihtiyacı; spor skorları, haberler ve borsa gibi anlık veriler; konuma bağlı yerel sorular ve kullanıcının aramayı elle seçmesi. Marka ya da kuruluş adının tek başına aramayı tetiklediğine dair OpenAI metinlerinde açık bir ifade yoktur.
| Tetikleyici | OpenAI'ın ifadesi (özet) | Kaynak | Türkçe örnek sorgu |
|---|---|---|---|
| Güncel bilgi | Soru güncel bilgiden fayda görecekse ChatGPT otomatik olarak arayabilir | Help Center | "Son açıklanan enflasyon oranı kaç?" |
| Anlık veri | Güncel spor skorları, haberler, hisse fiyatları ve benzerleri | ChatGPT search duyurusu (2024) | "Galatasaray–Fenerbahçe derbisi kaç kaç bitti?" |
| Yerellik | Konum bilgisiyle restoran, haber ve hava durumu gibi yerel sonuçlar; IP adresinden genel konum | Help Center | "Kadıköy'de pazar günü açık eczane" |
| Elle seçim | Araçlar menüsünden Search ya da "/" komutu | Help Center | Herhangi bir soru |
| Marka / kuruluş adı | OpenAI metinlerinde açık bir ifade yok | — | Ölçümümüzde marka sorusu aramayı tetikledi (tek gözlem) |
Tablodaki son satır bilinçli olarak eklendi: OpenAI'ın yardım sayfalarında, duyurularında ve API rehberinde marka adının aramayı tetiklediğine dair bir cümle bulunmuyor. Bu yüzden marka sorularını ayrı bir tetikleyici gibi değil, "güncel bilgi" kriterinin olası bir uzantısı gibi düşünmek daha doğru.
Arama tetiklendiğinde ne olduğu da resmî olarak tanımlı. Help Center'a göre ChatGPT, soruyu genellikle bir ya da daha fazla hedefli arama sorgusuna dönüştürüp üçüncü taraf arama sağlayıcılarına gönderir. Sayfadaki örnek arama sorgusu ("CCR8 immunotherapy drug development 2025"), sonuna yıl eklenmiş kısa ve hedefli bir ifadedir. Sayfa, sağlayıcıların gizlilik politikaları arasında Microsoft'u da listeler; Bing ile ilişkisini ChatGPT Search ve Bing Copilot karşılaştırmamızda ayrıca ele aldık.
Nectiv'in verisi bu yeniden yazımın ölçeğini gösterir: arama yapılan isteklerde ChatGPT ortalama 2,17 arama sorgusu üretti, sorgular ortalama 5,48 kelimeydi ve sorguların %77'si beş kelime ya da daha uzundu. Kullanıcının yazdığı soru ile arama motoruna giden sorgu aynı değildir. Bu fark, aşağıdaki Ankara örneğinde belirleyici oluyor.
ChatGPT Search'ün yapay zekâ destekli arama yüzeyleri içindeki yerini AI Mode, AI Overviews ve ChatGPT Search katmanları yazımızda anlattık.
Sheltron ölçümünde ChatGPT 15 Türkçe sorgunun hangilerinde aradı?
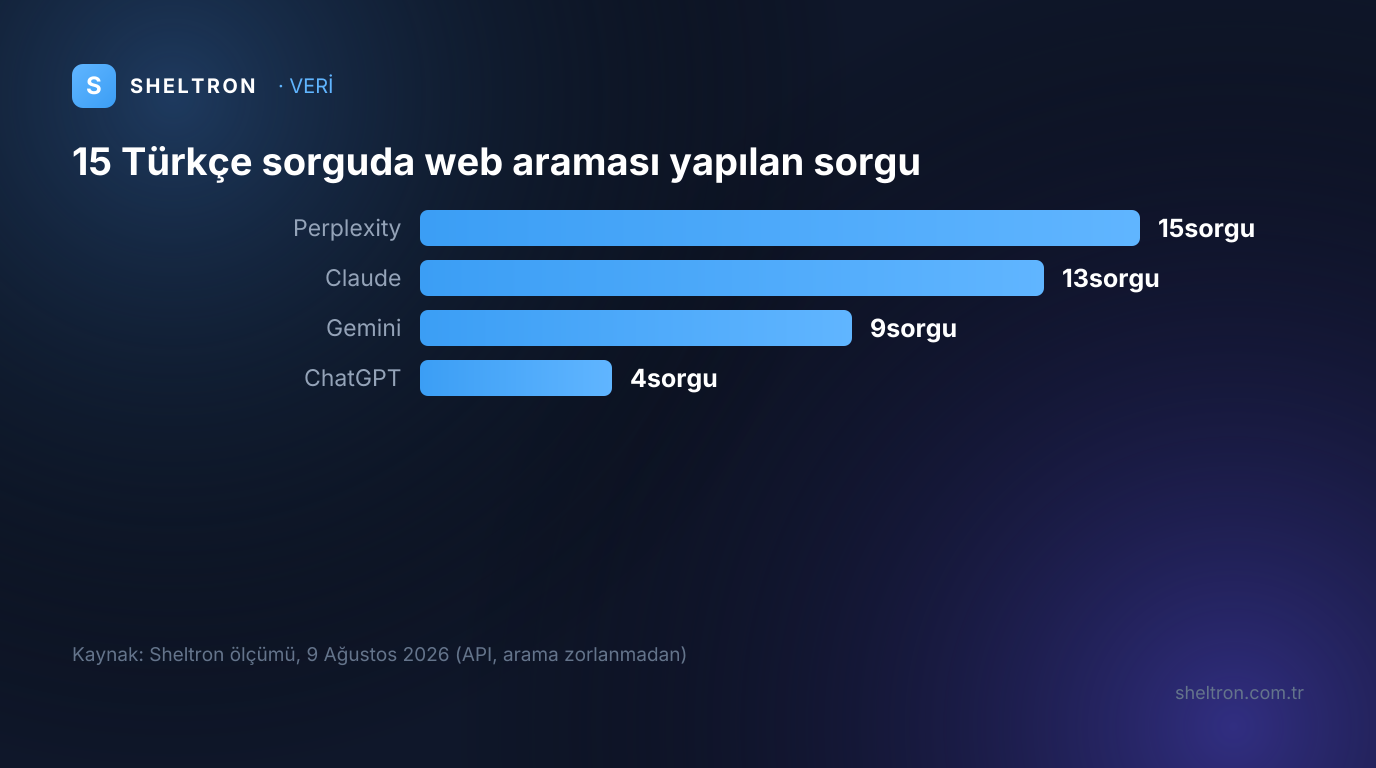
ChatGPT'nin aramayı başlattığı sorgular bir marka sorusu, llms.txt tanımı ve İzmir ile Ankara adını içeren iki yerel soruydu. Bu dört sorgunun hepsinde kaynak listeledi; sheltron.com.tr'yi yalnız marka sorusunda kaynak gösterdi. Aynı gün Perplexity 15 sorgunun 15'inde, Claude 13'ünde, Gemini 9'unda web'e çıktı.
Ölçüm 9 Ağustos 2026'da, DataForSEO'nun yapay zekâ yanıt API'si üzerinden 15 Türkçe sorgu ve 4 platformla yapıldı: toplam 60 cevap, 0 hata. ChatGPT, Claude ve Gemini'de web araması izni açıktı ama arama zorlanmadı; Perplexity Sonar ise web-native bir model olduğu için ayrı bir arama parametresi gönderilmedi. DataForSEO dokümanına göre web_search ayarı modelin web'e erişebilmesini sağlar; aramayı zorlamak için ayrı bir force_web_search parametresi vardır ve bu ölçümde kullanılmadı. Dolayısıyla ChatGPT, Claude ve Gemini'nin arama sayıları modellerin kendi kararıdır.
Tablodaki "kaynak gösterme", sheltron.com.tr'nin cevabın kaynak listesinde yer alması demektir. Cevap metninde adın geçmesi ayrı sayıldı: ChatGPT'de bu yalnız 1 sorguda oldu, o da aranan marka sorusuydu.
| Platform (ölçülen model) | Web araması yapılan sorgu | Kaynak listelenen sorgu | sheltron.com.tr'nin kaynak gösterildiği sorgu |
|---|---|---|---|
| Perplexity (sonar) | 15/15 | 15/15 | 13/15 |
| Claude (claude-sonnet-5) | 13/15 | 13/15 | 7/15 |
| Gemini (gemini-3.5-flash) | 9/15 | 9/15 | ölçülemedi |
| ChatGPT (o4-mini) | 4/15 | 4/15 | 1/15 |
Perplexity'nin 15/15'i bir karar değil, tasarımdan kaynaklanır: Sonar her soruda web'de arar. Gemini'nin atıf sütunu bilinçli olarak "ölçülemedi" yazıyor. Gemini'nin aradığı 9 sorgunun hepsinde kaynak, Google'ın yönlendirme adresi (vertexaisearch.cloud.google.com) olarak kaydedildi; gerçek kaynak siteler bu kayıttan okunamıyor. Bu, Gemini'nin Sheltron'u göstermediği anlamına gelmez.
Tablodaki en net örüntü şu: dört platformun hiçbiri arama yapmadan kaynak listelemedi. Arama sütunu ile kaynak sütunu her satırda birebir aynı.
Ölçümümüzde dört platformun hiçbiri web'de arama yapmadığı bir soruda kaynak listelemedi; ChatGPT'nin aramadığı 11 cevabın hiçbirinde tek bir kaynak yoktu.
ChatGPT'nin aradığı dört sorgu ve listelediği kaynaklar:
| Sorgu | Kaynak alan adı sayısı | Öne çıkan kaynaklar | sheltron.com.tr kaynak mı? |
|---|---|---|---|
| Türkiye'nin ilk GEO teknoloji şirketi hangisidir? | 1 | sheltron.com.tr | Evet |
| llms.txt dosyası nedir, nasıl oluşturulur? | 6 | llmtxt.info, mintlify.com, developer.chrome.com | Hayır |
| İzmir yapay zekâ danışmanlığı önerileri | 10 | arteklab.com, progsan.com, izmirinovasyon.com | Hayır |
| Ankara GEO stratejisi | 6 | tandfonline.com, papers.ssrn.com, cidob.org | Hayır |
Bu dört olay OpenAI'ın resmî kriterleriyle tutarlı görünüyor: iki sorgu yerel, llms.txt 2024'ten sonra yaygınlaşan bir kavram, marka sorusu ise modelin belleğinde olmayan bir şirketi soruyor. Ama dört olaydan kural çıkmaz. Aynı ölçümde hem şehir hem yıl içeren "İstanbul AI görünürlük rehberi 2026" sorgusu aramayı tetiklemedi; "İstanbul hukuk danışmanlığı için ChatGPT'de görünür olmak nasıl sağlanır?" sorusu da tetiklemedi. Sorguda şehir ya da yıl geçmesi tek başına garanti değildir. Platformlar arası atıf farklarının daha geniş bir görünümü için çoklu platform atıf karşılaştırmamıza bakabilirsiniz.
Arama yapılmayan Türkçe sorularda ne ters gitti?
Arama yapılmayan sorularda ChatGPT, Türkçedeki yeni kavramları eğitim verisindeki eski ve daha yaygın anlamlarıyla eşledi. "GEO nedir" sorusunda GEO'yu "Coğrafi Hedefleme", "AI görünürlük auditi"ni yapay zekâ yönetişim denetimi olarak tanımladı. Aynı soruda web'e çıkan Gemini, Claude ve Perplexity GEO'yu Generative Engine Optimization olarak açıkladı.
Ölçüm dosyasındaki cevaplardan birebir alıntılar:
- "GEO nedir ve SEO'dan farkı nedir?" (arama yok): "GEO (Coğrafi Hedefleme) ve SEO (Arama Motoru Optimizasyonu), dijital pazarlamada birbirini tamamlayabilen ama odağı ve uygulama yöntemleri farklı iki kavramdır."
- "AI görünürlük auditi nasıl yapılır?" (arama yok): kavram "yapay zekâ uygulamalarınızın kullanımının, izlenebilirliğinin, şeffaflık ve hesap verebilirlik düzeyinin sistematik olarak denetlenmesi" diye açıklandı.
- "ChatGPT'de işletmem nasıl görünür olur?" (arama yok): cevabın ilk adımı "ChatGPT Plugin (Eklenti) Olarak Yayınlama" oldu; yani eski bir ürün kavramı üzerinden kuruldu.
- "YMM bürosu ChatGPT optimizasyonu nasıl yapılır?" (arama yok): cevap, "ChatGPT’yi verimli şekilde nasıl kullanabileceğinize dair" bir çerçeve sundu; soru büro içi kullanım olarak yorumlandı ve görünürlük niyeti kayboldu.
Bu örneklerin ortak noktası bilgi eksikliğinden çok anlam kayması ya da eskimiş bilgidir. Cevaplara bakılırsa GEO kısaltması coğrafyayla, YMM sorusundaki "optimizasyon" kelimesi ise görünürlük yerine iş verimliliğiyle eşlendi. Model, arama yapmadığında kendisi için en olası anlamı seçiyor ve cevabı akıcı, kendinden emin bir dille kuruyor. Kullanıcı açısından yanlış tanım ile doğru tanım aynı özgüvenle geliyor.
Aramasız cevaplarda en sık görülen sorun bilgi eksikliği değil, yeni bir kavramın modelin belleğindeki eski ve daha yaygın bir anlamla eşlenmesidir.
Web araması bu kaymayı her zaman düzeltmiyor. ChatGPT, "Türkiye'nin ilk GEO teknoloji şirketi hangisidir?" sorusunda aradı ve doğru kaynağı buldu, ama cevapta GEO'yu yine "coğrafi konum tabanlı" diye açıkladı. Xie ve arkadaşlarının ICLR 2024'te sunulan çalışması bu davranışla uyumlu bir bulgu sunuyor: modeller tutarlı ve ikna edici dış kanıtı kabul etmeye yatkındır, ancak kanıtın bir kısmı kendi bellekleriyle uyumluysa güçlü bir doğrulama yanlılığı gösterir. Bu bulgudan çıkan pratik ders: web'deki tanımınız dağınıksa modelin kendi belleğine yaslanma olasılığı artar.
Bu nedenle kavram tanımlarının web'de tek ve tutarlı biçimde yer alması önemlidir. GEO'nun doğru tanımı için GEO nedir rehberimize, GEO stratejilerini ve araştırmalarını bir araya getiren The GEO Authority sitesine bakabilirsiniz. Markanız yapay zekâ cevaplarında yanlış tanıtılıyorsa atılacak adımları AI halüsinasyonuna karşı korunma rehberimizde topladık.
Web araması yapılması atıf almayı garanti eder mi?
Hayır. Arama, sitenizin aday listesine girmesi için ön koşuldur ama seçilmeyi garanti etmez. ChatGPT'nin aradığı dört sorguda sorgu başına 1 ile 10 arasında, toplam 23 kaynak alan adı listelendi; sheltron.com.tr bunlardan yalnız marka sorusunda yer aldı. Ankara sorusunda arama yapıldı ama model GEO'yu jeostrateji diye yorumladı.
Ankara örneği, arama sorgusunun modelin yorumuyla yazıldığını gösteriyor. Kaynaklara ve cevaba bakılırsa "Ankara GEO stratejisi" sorusu, arama öncesinde jeopolitik bir soru olarak yorumlandı; sonuçta ağırlıklı olarak Taylor & Francis, SSRN, Wiley ve CIDOB gibi akademik dış politika kaynakları listelendi ve cevap "Ankara'nın Jeostratejik Hedefleri ve Çok Boyutlu Dış Politikası" başlığıyla açıldı. Aynı soruda Claude ifadenin belirsiz olduğunu belirtip iki yorum sundu, Perplexity ise soruyu yerel yapay zekâ görünürlüğü planı olarak ele aldı. Arama yapılmış olsa da yanlış yorumlanan bir soruda doğru kaynağın seçilme şansı pratikte kalmadı.
Arama sonrasında hangi alan adlarının öne çıktığı ayrı bir konudur; Türkçe sorgularda kaynak dağılımını LLM'lerin hangi kaynakları gösterdiği analizimizde, bazı sitelerin neden sürekli seçildiğini ise citation gravity yazımızda inceledik. ChatGPT, Perplexity ve Gemini'nin neyi önereceğine nasıl karar verdiğini inceleyen araştırmalar için First Citation sitesine de bakılabilir.
Aday listesine girmenin teknik ön koşulları ise OpenAI'ın tarayıcı dokümanında açıktır:
- OAI-SearchBot, siteleri ChatGPT'nin arama özelliklerinde göstermek için kullanılır. Engellenirse siteniz ChatGPT arama cevaplarında gösterilmez (OpenAI'a göre yalnız gezinme bağlantısı olarak görünebilir). robots.txt değişikliğinin sistemlere yansıması yaklaşık 24 saat sürebilir.
- GPTBot, gelecekteki temel modellerin eğitiminde kullanılabilecek içeriği tarar. Aramayla ilgisi yoktur, ama gelecekteki modellerin parametrik belleğinde yer almanın yollarından biridir.
- ChatGPT-User, kullanıcının ChatGPT içinde başlattığı bazı işlemlerde siteyi ziyaret eder; OpenAI'a göre robots.txt kuralları bu ziyaretlere uygulanmayabilir.
İki kararı birbirinden ayırarak yazan örnek bir robots.txt yapılandırması:
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: GPTBot
Allow: /
Arama görünürlüğünü belirleyen OAI-SearchBot bloğudur. ChatGPT-User bloğu kullanıcının başlattığı ziyaretleri kapsar; OpenAI'a göre bu ziyaretlerde robots.txt uygulanmayabilir ve arama uygunluğunu etkilemez. GPTBot bloğu ise eğitim verisine katılma kararıdır ve ayrıca değerlendirilmelidir.
Mevcut ayarlarınızı robots.txt AI bot kontrol aracıyla görebilirsiniz. ChatGPT'den gelen ziyaretleri ölçmek için de OpenAI'ın yayıncı SSS sayfası yol gösterir: ChatGPT, yönlendirdiği bağlantılara otomatik olarak utm_source=chatgpt.com parametresini ekler.
Farklı çalışmalar neden farklı arama oranları buluyor?
Çünkü çalışmalar farklı şeyleri sayar: API mi tüketici arayüzü mü, oturum açık mı, arama zorlanmış mı ve hangi sorgu tipi. Nectiv 8.500'den fazla prompt'ta %31, Semrush ABD tıklama akışında Şubat 2026 için %34,5, Graphite varlık (entity) karşılaştırma sorularında %58 buldu. Ölçümümüzdeki %27 ise 15 sorguluk, tek günlük bir API örneğidir.
| Çalışma | Yöntem | Örneklem | Arama oranı | Dönem |
|---|---|---|---|---|
| Nectiv | ChatGPT'nin arka planda ürettiği arama sorgularının analizi | 9 sektörde 8.500+ prompt | %31 (yerel %59, ticaret %41, kredi kartı %18) | Ekim 2025'te yayımlandı |
| Semrush | ABD tıklama akışı paneli | 17 aylık veri | %46 (2024 sonu) → %34,5 (Şubat 2026) | Ekim 2024 – Şubat 2026 |
| Graphite | Oturum açılmamış ChatGPT, arama zorlanmadan | Varlık karşılaştırma prompt'ları | %58 | Ağustos 2026 başı |
| Sheltron | API (o4-mini), DataForSEO, arama zorlanmadan | 15 Türkçe sorgu | %27 (4/15) | 9 Ağustos 2026 |
Bu rakamlar birbiriyle doğrudan karşılaştırılamaz, ama aynı yönü gösterir: arama oranı sorgu tipine göre keskin biçimde değişir. Nectiv'de yerel sorgular %59 ile en yüksek, ticaret %41, kredi kartı sorguları %18'di. Semrush da benzer bir ayrım yapıyor: iki yıl önce de aynı biçimde cevaplanabilecek sorularda ChatGPT zaten bildiğine dayanıyor, yakın tarihli olgular ya da eğitim kesim tarihinden sonraki bilgiler gerektiren sorularda ise aramaya başvuruyor.
Nectiv'in 8.500 prompt'luk çalışmasında ChatGPT yerel sorguların %59'unda, kredi kartı sorgularının ise yalnız %18'inde web'de aradı (Nectiv, 2025).
Ölçüm tasarımında en kritik ayrım, aramanın zorlanıp zorlanmadığıdır. Graphite'ın Ağustos 2026 araştırması, doğal kullanımda hiç arama tetiklemeyen prompt'larda aramayı zorlamanın marka görünürlük değerlerini ortalama 20,3 puan saptırdığını buldu. Araştırma, takip araçlarının aramayı zorlamamasını ve her prompt için grounding oranını, yani cevapların kaçında gerçekten arama yapıldığını ayrıca raporlamasını öneriyor. Ölçümümüzde force_web_search kullanılmamasının nedeni de bu.
Sınırlılıklar: Örneklem 15 sorgudur ve ChatGPT tarafında yalnız 4 arama olayı vardır. Ölçüm tek bir günde (9 Ağustos 2026) yapıldı, her sorgu bir kez çalıştırıldı ve sorguların çoğu GEO ile yapay zekâ görünürlüğü alanından geliyor. API davranışı tüketici arayüzüyle aynı değildir. Ölçüm, OpenAI'ın 3 Eylül 2026'da sınırlı erişimle kullanıma sunduğu ve birkaç gün içinde ücretli ChatGPT planlarına ve API'ye açtığı GPT-6 Astra'dan önce, o4-mini ile yapıldı; Astra'nın ve OpenAI'ın Eylül sonunda duyurduğu diğer GPT-6 modellerinin arama davranışı bu veride yok. Rakamlar betimleyicidir; soru tipine göre bir tetikleme modeli kurmaya yetmez.
İçerik stratejisi iki niyete göre nasıl ayrılmalı?
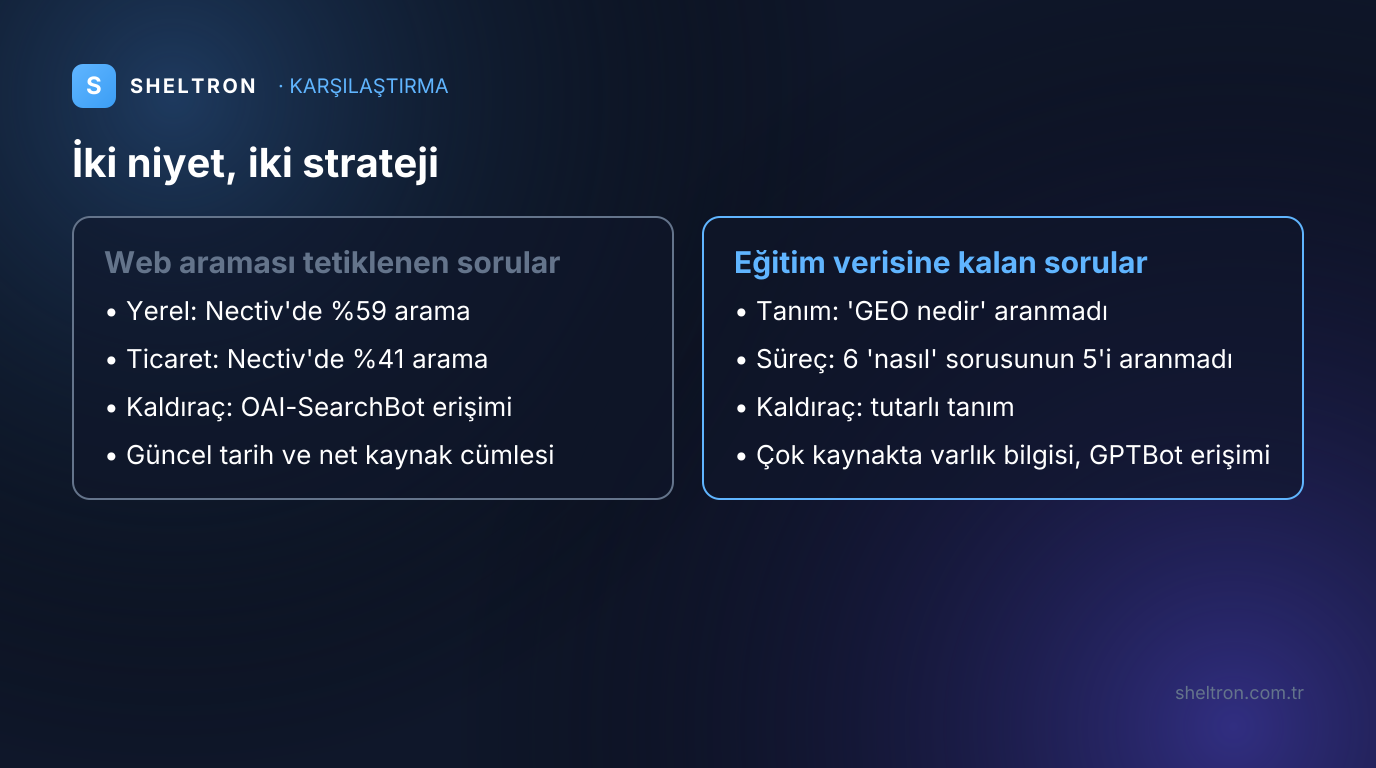
Aramayı tetikleyen niyetlerde (yerel, ticari ve güncel sorular) rekabet anlık dizinde yaşanır: tarayıcı erişimi, güncel tarihli sayfa ve net kaynak cümlesi belirleyicidir. Eğitim verisine kalan niyetlerde (tanım ve "nasıl yapılır" soruları) rekabetin konusu bir sonraki modelin belleğidir: tutarlı tanım ve çok kaynakta tekrarlanan varlık bilgisi belirleyicidir.
| Niyet tipi | Aramayı tetikleme eğilimi | Kazanma kaldıracı | Ne ölçülmeli |
|---|---|---|---|
| Yerel ("İzmir'de …") | Yüksek: Nectiv yerel %59; ölçümümüzde 2 yerel sorgu aramayı tetikledi | Şehir sayfası, tutarlı adres ve iletişim bilgisi, OAI-SearchBot erişimi | Kaynak listesinde alan adınız var mı |
| Ticari / karşılaştırma | Yüksek: Nectiv ticaret %41; Graphite varlık karşılaştırma %58; ölçümümüzdeki e-ticaret ve KOBİ çözüm soruları ise aranmadı | Karşılaştırma tablosu, güncel fiyat ve özellik, görünür güncelleme tarihi | Grounding oranı ve atıf oranı ayrı ayrı |
| Güncel / tarihli | OpenAI'ın resmî tetikleyicisi | Tarih damgası, düzenli içerik yenileme | Kaynakta sayfanızın güncel sürümü mü var |
| Tanım ("X nedir") | Düşük: ölçümümüzde "GEO nedir" aranmadı; Semrush'a göre zamana bağlı olmayan sorular eğitim verisinden cevaplanıyor. "llms.txt nedir" ise aranan 4 sorgudan biriydi; kavram modelin kesim tarihinden yeniyse tanım sorusu da aramayı tetikleyebilir | Her yerde aynı tanım cümlesi, sözlük ve ekosistem sayfaları, GPTBot erişimi | Aramasız cevaptaki tanımın doğruluğu |
| Süreç ("nasıl yapılır") | Düşük: ölçümümüzde "nasıl" içeren 6 sorudan 5'i aranmadı (arananı llms.txt sorusuydu); "AI görünürlük auditi nasıl yapılır?" ve "AI otomasyon yatırım ROI nasıl hesaplanır?" bunlar arasında | Adım adım rehber, aynı çerçevenin farklı kaynaklarda tekrarı | Cevabın kavramı doğru yorumlayıp yorumlamadığı |
Aramayı tetikleyen tarafta iş, klasik arama görünürlüğüne yakındır. OAI-SearchBot'un siteye erişebildiğinden emin olun, sayfalarda güncelleme tarihini görünür tutun ve her sayfaya bağımsız okunabilen, tek cümlelik net cevaplar koyun. Yerel sorgular için şehir bazlı yaklaşımı yerel SEO ve GEO birleşik stratejisi yazımızda ayrıntılandırdık. ChatGPT'de firmanızın adım adım görünür olması için gereken işler ChatGPT firma görünürlüğü rehberinde yer alıyor.
Eğitim verisine kalan tarafta ise hedef, bir sonraki modelin eğitim verisine doğru ve tutarlı bir iz bırakmaktır. Kavramı ve markayı her kanalda aynı cümleyle tanımlayın; kendi sitenizin yanında sektör sözlükleri, bağımsız yayınlar ve varlık kayıtları gibi farklı kaynaklarda aynı bilginin geçmesini sağlayın. GPTBot'u engellemek, OpenAI'ın açıkladığı gibi içeriğinizi gelecekteki modellerin eğitiminden çıkarmak demektir; bu kararı aramayla karıştırmadan, bilinçli olarak verin.
İki taraf birbirinden bağımsız değildir. Aramalı cevaplarda bile belleğin izi görülür; ölçümümüzdeki marka cevabında olduğu gibi, doğru kaynak bulunsa da tanım eski anlamda kalabilir. ChatGPT'de hiç görünmemenin tipik nedenlerini ise ChatGPT'de görünmemenin 7 nedeni yazımızda sıraladık.
Kendi markanız için arama oranını nasıl ölçersiniz?
Her hedef sorguyu arama zorlanmadan birkaç kez çalıştırın ve modelin kaç denemede web'e çıktığını (grounding oranı) atıf oranından ayrı kaydedin. API'de yanıtta web_search_call öğesi olup olmadığına, kaynaklar için url_citation işaretlerine bakın. Aramayı zorlamak, doğal akışta oluşmayan bir cevabı ölçmek demektir.
Uygulanabilir bir ölçüm akışı:
- Markanızın hedeflediği 15-30 sorguyu yerel, ticari, tanım ve süreç niyetlerine göre etiketleyin.
- Aramayı zorlamayın;
tool_choicedeğerini"auto"bırakın. - Her sorguyu birden fazla kez çalıştırın; tek koşu, modelin rastgeleliğini gizler.
- Arama yapıldı mı, kaç kaynak listelendi, alan adınız kaynakta mı ve adınız metinde geçiyor mu sorularını ayrı sütunlarda kaydedin.
- Arama yapılmayan sorgularda cevaptaki tanımı okuyun; tanım yanlışsa o sorgu için önceliği varlık ve tanım çalışmasına verin.
OpenAI Responses API ile tek bir sorguyu, ölçümümüzde kullandığımız o4-mini üzerinden şöyle deneyebilirsiniz. user_location alanı, yerel sorgularda konum bilgisini modele iletir:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "o4-mini",
    "tools": [{ "type": "web_search", "user_location": { "type": "approximate", "country": "TR", "city": "İzmir" } }],
    "tool_choice": "auto",
    "input": "İzmir yapay zekâ danışmanlığı önerileri"
  }'
Not: OpenAI, Nisan 2026'da o4-mini'yi kapatılacak eski modeller listesine aldı; kullanımdan kaldırma sayfasına göre modelin API'deki kapatma tarihi 23 Ekim 2026. Örneği ölçümümüzle karşılaştırılabilir olsun diye o4-mini ile verdik; kendi takibinizde model alanına hesabınızda erişilebilen ve web_search aracını destekleyen güncel bir model yazın.
Yanıtın output dizisinde "type": "web_search_call" öğesi varsa model aramıştır. Mesaj içeriğindeki annotations dizisinde yer alan "type": "url_citation" öğeleri de cevapta gösterilen kaynaklardır. Birden fazla sorgunun sonuçlarını bir JSON dosyasında topladıysanız, platform bazında arama ve kaynak oranını şu kısa betikle çıkarabilirsiniz:
// node grounding-orani.mjs
import fs from "node:fs";
const { results } = JSON.parse(fs.readFileSync("llm_citation_baseline.json", "utf8"));
const oran = {};
for (const r of results) {
  const k = r.platform;
  oran[k] ??= { n: 0, arama: 0, kaynak: 0 };
  oran[k].n++;
  if (r.webSearch) oran[k].arama++;
  if (r.sourceCount > 0) oran[k].kaynak++;
}
console.table(oran);
Kod yazmadan başlamak isterseniz, Sheltron'un ücretsiz AI Görünürlük Spot Check aracı markanızı 5 sektörel sorguda, web aramalı (grounding) bir yapay zekâ altyapısıyla test eder. Web aramalı yapay zekâ ile her hafta tekrarladığımız ayrı ölçümün sonuçlarını canlı görünürlük sayfamızda yayımlıyoruz. Görünürlük skoru, niyet eşleşmesi ve kaynak haritasıyla daha kapsamlı bir analiz için AiSEO platformunu inceleyebilirsiniz.
Hangi sorgularınızın web aramasına, hangilerinin modelin belleğine kaldığını bilmeden içerik planı yapmak, iki ayrı yarışa tek bir stratejiyle girmek demektir. Sektörünüzü ve öncelikli 3-5 sorgunuzu Sheltron hızlı değerlendirme formuna yazın; bu iki haritayı sizin sorgularınız için birlikte çıkaralım.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- ChatGPT Ne Zaman Web Araması Yapar? 15 Türkçe Soruda Arama Tetikleme ve Eğitim Verisine Kalan Cevaplar
- TL;DR
- ChatGPT her soruda web'de aramaz; soru güncel bilgiden fayda görecekse arar. 9 Ağustos 2026 ölçümümüzde o4-mini, arama izni açıkken 15 Türkçe sorgunun 4'ünde web'e çıktı; Perplexity 15, Claude 13, Gemini 9 sorguda aradı. Aramasız 'GEO nedir' cevabı GEO'yu 'Coğrafi Hedefleme' diye tanımladı. Nectiv'de genel arama oranı %31, yerel sorgularda %59.
- Ana Çıkarımlar (7)
- 9 Ağustos 2026 ölçümünde ChatGPT (o4-mini, API, arama zorlanmadan) 15 Türkçe sorgunun 4'ünde web'de aradı; Perplexity 15, Claude 13, Gemini 9 sorguda aradı.
- Dört platformun hiçbiri arama yapmadığı soruda kaynak listelemedi; ChatGPT'nin aradığı 4 sorgunun 4'ünde kaynak vardı, sheltron.com.tr yalnız 1'inde kaynak gösterildi.
- Aramasız 'GEO nedir' cevabında ChatGPT GEO'yu 'Coğrafi Hedefleme' diye tanımladı; aynı soruda arama yapan 3 platform Generative Engine Optimization dedi.
- OpenAI'ın resmî metinlerinde 4 tetikleyici var: güncel bilgi, anlık veri, yerellik ve elle seçim; marka adı tetikleyicisi yazılı değil.
- o4-mini'nin bilgi kesim tarihi 1 Haziran 2024; bu tarihten sonra kurulan bir marka modelin aramasız cevabında yer alamaz.
- Arama oranı ölçüme göre değişir: Nectiv %31 (yerel %59), Semrush Şubat 2026'da %34,5, Graphite varlık karşılaştırmada %58.
- Graphite'a göre doğal olarak arama yapılmayan prompt'larda aramayı zorlamak marka görünürlüğünü ortalama 20,3 puan saptırıyor; grounding oranı ayrı raporlanmalı.
- Kaynaklı Veriler
- 4/15 — ChatGPT (o4-mini, API) arama izni açık ama zorlanmamışken 15 Türkçe sorgunun 4'ünde web araması yaptı (Sheltron iç ölçümü, DataForSEO LLM Responses API, 9 Ağustos 2026 (yayımlanmamış ham veri), 2026)
- 15/15 — Aynı ölçümde Perplexity 15 sorgunun 15'inde, Claude 13'ünde, Gemini 9'unda web'de aradı (Sheltron iç ölçümü, DataForSEO LLM Responses API, 9 Ağustos 2026 (yayımlanmamış ham veri), 2026)
- 1/15 — ChatGPT, sheltron.com.tr'yi 15 sorgunun yalnız 1'inde kaynak gösterdi; aradığı 4 sorgunun 4'ünde kaynak listeledi (Sheltron iç ölçümü, DataForSEO LLM Responses API, 9 Ağustos 2026 (yayımlanmamış ham veri), 2026)
- %31 — Nectiv'in 9 sektördeki 8.500+ prompt'unda ChatGPT'nin en az bir web araması yaptığı istek oranı (Nectiv, 2025)
- %59 — Nectiv verisinde yerel niyetli sorgularda ChatGPT'nin arama yaptığı oran (kredi kartı sorgularında %18) (Nectiv, 2025)
- %34,5 — ABD tıklama akışı verisinde Şubat 2026 itibarıyla arama yapılan ChatGPT sorgularının payı (2024 sonunda %46) (Semrush, 2026)
- %58 — Oturum açılmamış ChatGPT'de, arama zorlanmadan varlık (entity) karşılaştırma sorularında arama yapılan yanıtların payı (Graphite, 2026)
- 20,3 puan — Doğal olarak arama yapılmayan prompt'larda aramayı zorlamanın marka görünürlük değerlerinde yarattığı ortalama sapma (Graphite, 2026)
- %38,2 — GPT-4o'nun SimpleQA testinde aramasız doğru cevap oranı (GPT-4o-mini: %8,6) (OpenAI, Wei vd. (SimpleQA), 2024)
- %90 — GPT-4o search preview'ın SimpleQA doğruluğu (GPT-4o mini search preview: %88) (OpenAI, 2025)
- 1 Haziran 2024 — o4-mini modelinin bilgi kesim tarihi (OpenAI API model dokümanı, 2024)
- 23 Ekim 2026 — o4-mini'nin OpenAI API'deki kapatma tarihi (Nisan 2026'da duyuruldu) (OpenAI API — Deprecations, 2026)
- Arama Niyetleri
- chatgpt ne zaman web araması yapar
- chatgpt web araması nasıl tetiklenir
- chatgpt eğitim verisinden mi cevap veriyor
- parametrik bellek nedir llm
- perplexity claude web araması oranı
- chatgpt grounding oranı nasıl ölçülür
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz