
Yapay Zekâ Markanızı Başka Bir Firmayla Karıştırıyorsa: Entity Ayrıştırma Nasıl Yapılır?
Yapay zekânın marka adını aynı adlı başka bir varlığa bağlamasının üç mekanizmasını (parametrik bellek, Knowledge Graph ve Wikidata eşleşmesi, retrieval) ayırıyor; her biri için teşhis testi, disambiguatingDescription ve sameAs ile ayrıştırma adımlarını gösteriyor.
💡Kısa Özet
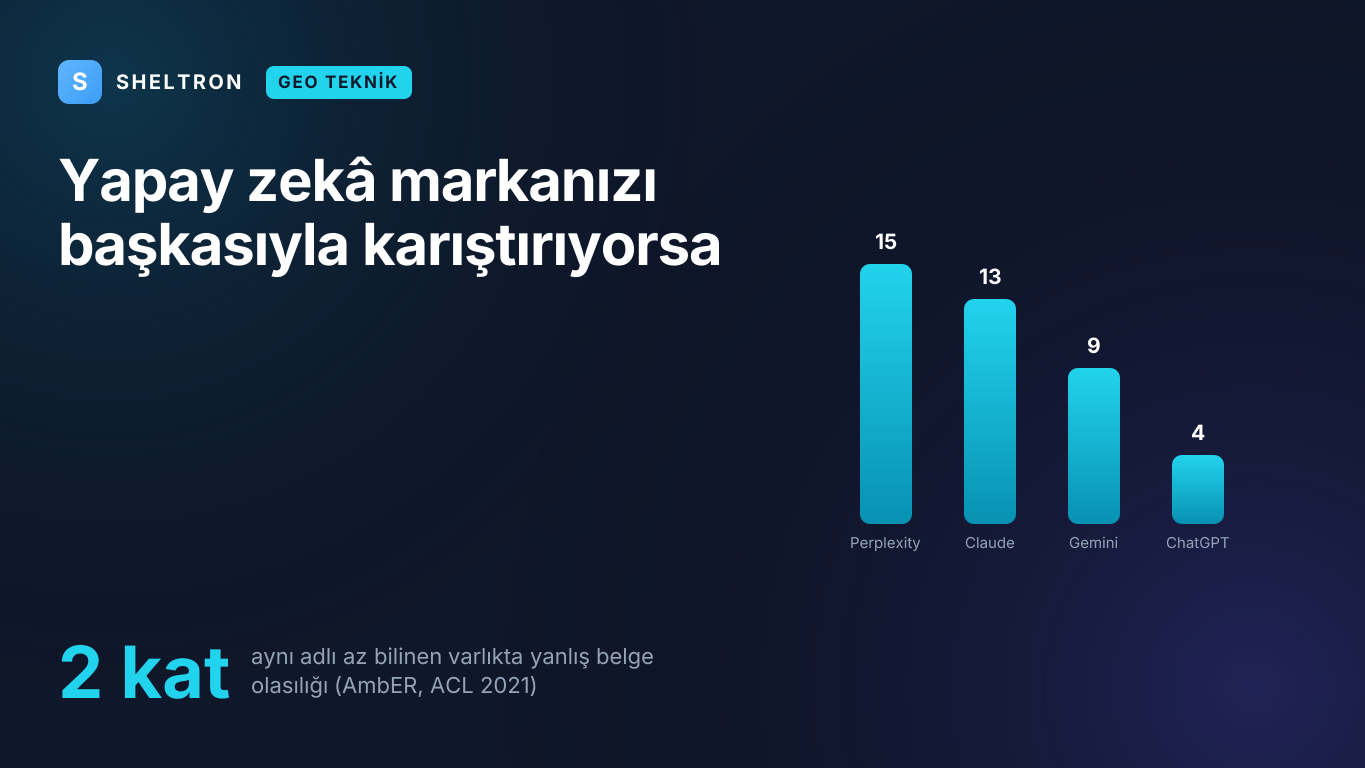
Yapay zekâ bir marka adını, o adı taşıyan en bilinen varlıkla eşleştirir. AmbER çalışmasına göre aynı adlı varlıklardan daha az bilineni sorulduğunda yanlış belge getirme olasılığı 2 kat. Ağustos 2026 ölçümümüzde Knowledge Graph'ta 'sheltron' sorgusu tek sonuç verdi: Schiltron (skor 211). ChatGPT 15 sorgunun 4'ünde web'de aradı, aramadığı bir cevapta GEO'yu 'Coğrafi Hedefleme' diye açtı.
Ana Çıkarımlar
- •Marka adı karışıklığı üç ayrı yerde doğar: modelin parametrik belleği, Knowledge Graph/Wikidata eşleşmesi ve web aramasındaki retrieval; her birinin teşhisi ve müdahalesi farklıdır.
- •AmbER (ACL 2021): aynı adı paylaşan iki varlıktan daha az bilineni sorulduğunda arama sistemlerinin yanlış belge getirme olasılığı 2 kat yüksek.
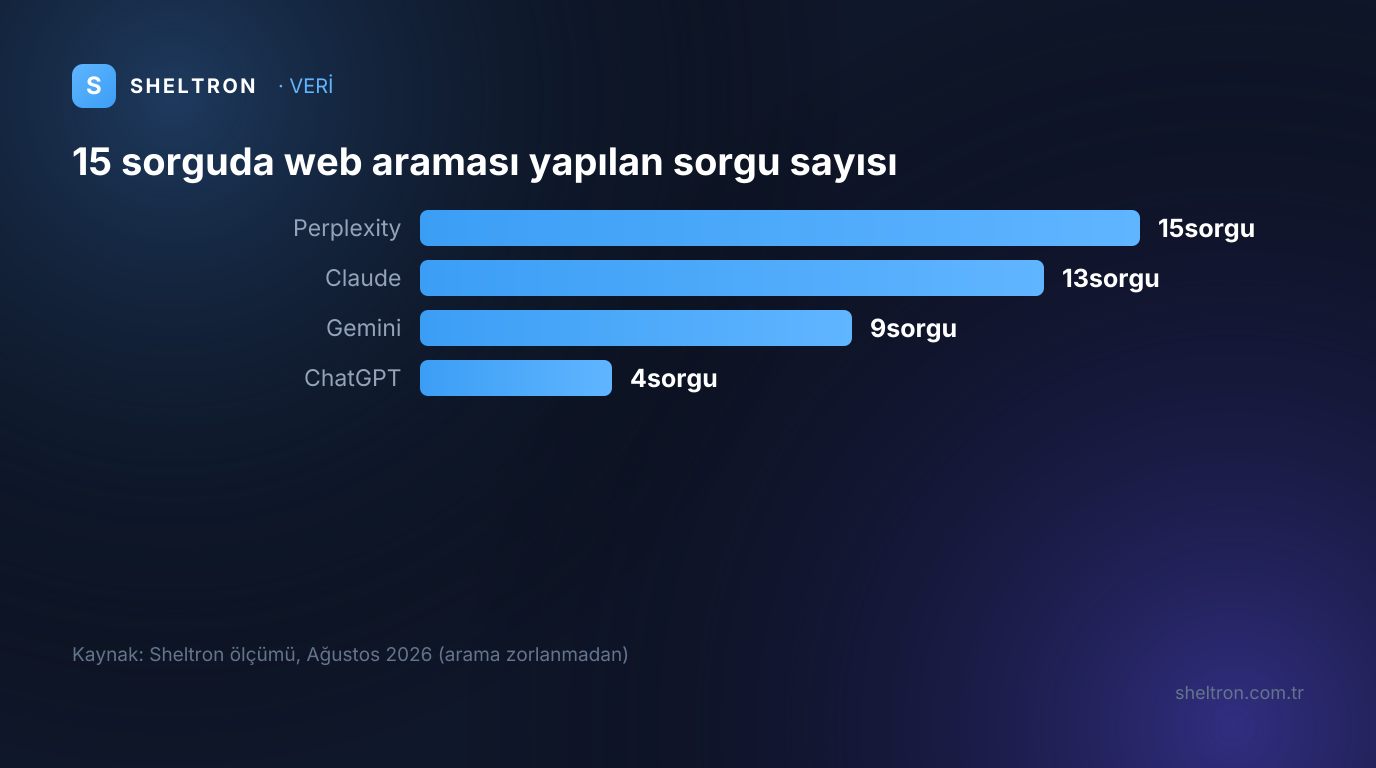
- •Ağustos 2026 ölçümünde ChatGPT (o4-mini) 15 sorgunun yalnız 4'ünde web araması yaptı; aramadığı bir cevapta GEO'yu 'Coğrafi Hedefleme' diye açtı.
- •Ağustos 2026'da Knowledge Graph Search API'de 'sheltron' sorgusu tek sonuç verdi: Schiltron (skor 211); Eylül 2026 itibarıyla Wikidata'da aynı etiketli tek öğe 14 sitelink'li bir piyade düzeni.
- •Teşhis için aynı soru üç koşulda sorulur: aramasız, aramalı ve bağlam kelimeli; karışıklığın hangi testte kaybolduğu kaynağını gösterir.
- •Wikidata'da iki öğe aynı etiket ve aynı açıklamaya birlikte sahip olamaz; açıklama 2-12 kelime, tanıtım dili içermeyen bir tür-sektör-konum tanımı olmalı.
- •Organization şemasında disambiguatingDescription ve sameAs, sayfanın görünür metniyle aynı anlamı taşımalı; sonuç süresi için garanti yoktur.
Yapay zekâ markanızı başka bir firmayla karıştırıyorsa sorun çoğu zaman bir uydurma değil, bir kimlik eşleşmesidir: sistem adınızı, aynı adı taşıyan daha bilinen bir varlığa bağlar. ACL 2021'de yayımlanan AmbER çalışmasına göre aynı adı paylaşan iki varlıktan daha az bilineni sorulduğunda, arama sistemlerinin yanlış belge getirme olasılığı 2 kat yüksektir. Sheltron'un Ağustos 2026 ölçümünde Google Knowledge Graph Search API'de "sheltron" sorgusu tek bir sonuç döndürdü: ortaçağ piyade düzeni Schiltron (skor 211). Şirketin kendisi grafikte yoktu.
Bu tür bir karışıklığı çözmek için önce nerede doğduğunu bilmek gerekir. Aşağıda karışıklığın üç ayrı kaynağını (modelin belleği, bilgi grafikleri ve web araması) birbirinden ayırıyor, her biri için bir teşhis testi ve müdahale öneriyoruz. Örneklerin tamamı kendi markamız üzerinde yaptığımız tarihli ölçümlerden geliyor; amaç bir başarı hikâyesi anlatmak değil, teşhisin nasıl yapıldığını göstermek. Markanız hakkında yanlış bilgi yayılıyorsa ve kriz yönetimi gerekiyorsa yapay zekâ halüsinasyonu rehberimiz daha uygun başlangıç noktasıdır. Bu yazı, adınızın yanlış varlığa bağlanması sorununa odaklanıyor.
Yapay zekâ markanızı başka bir firmayla neden karıştırır?
Yapay zekâ bir marka adını, o adı taşıyan en bilinen varlıkla eşleştirme eğilimindedir. Karışıklık üç ayrı yerde doğar: modelin eğitimden gelen belleğinde, Google Knowledge Graph ve Wikidata gibi bilgi grafiklerinde ve web aramasında getirilen kaynaklarda. Her birinin belirtisi, teşhis yöntemi ve çözümü farklıdır.
Sorunun kökünde, arama sistemlerinin bir adı kelime dizisi olarak değil, belirli bir varlığa işaret eden bir kimlik olarak okuması yatar. Google, Knowledge Graph'ı 2012'de tanıtırken bu değişimi "things, not strings" (dizgeler değil, şeyler) diye özetlemişti. Aynı yazıdaki örnekte "Taj Mahal" sorgusu bir anıta, Grammy ödüllü bir müzisyene ya da Atlantic City'deki bir kumarhaneye işaret edebiliyordu. Grafik lansman sırasında 500 milyondan fazla nesne ve 3,5 milyardan fazla olgu içeriyordu. Bu rakamlar 2012'ye aittir; ancak mantık aynı kaldı: sistem her adı bir varlığa bağlamak zorundadır ve belirsizlikte genellikle en güçlü adayı seçer.
Üstelik belirsizlik nadir bir durum değildir. EMNLP 2020'de yayımlanan AmbigQA çalışması, açık alan sorularından oluşan NQ-open veri setindeki soruların %50'den fazlasının bir tür belirsizlik içerdiğini gösterdi. Belirsizliğin kaynaklarından biri, doğrudan varlık referanslarıdır. Çalışmanın AmbigNQ veri seti 14.042 sorudan oluşuyor.
Markalar için bu belirsizlik üç tipik biçimde görülür:
- Aynı adlı firma: Başka ülkede ya da başka sektörde aynı adı taşıyan, daha eski ve daha çok bahsedilen bir şirket.
- Aynı adlı kavram veya nesne: Bir oyun karakteri, tarihî bir terim ya da ürün adı gibi şirket dışı bir varlık.
- Kısaltma çakışması: Markanın ya da faaliyet alanının kısaltması, başka bir alanda çok daha yaygın bir anlama sahiptir.
Bu durum halüsinasyondan farklıdır. Halüsinasyonda model var olmayan bir bilgi uydurur. Entity karışıklığında ise bilgiler çoğu zaman doğrudur, yalnızca başka bir varlığa aittir. Kasıtlı yanlış bilgi yayma ise ayrı bir konudur; onu negatif GEO yazımızda ele aldık. Entity karışıklığında karşınızda bir saldırgan yoktur, yalnızca grafikte ve web'de sizden daha görünür bir isim benzeri vardır.
Entity ayrıştırma (entity disambiguation) nedir?
Entity ayrıştırma, aynı adı ya da kısaltmayı taşıyan birden fazla varlık arasından metinde kastedilen doğru varlığı seçme işlemidir. Arama motorları ve dil modelleri için bu, bir dizgenin bir şirkete mi, bir oyun yeteneğine mi yoksa tarihî bir askerî düzene mi işaret ettiğine karar vermek anlamına gelir.
Bu kararı veren sistemler iki tür ipucu kullanır: adın kendisi ve adın yanında duran ayırt edici bilgi. Adlar benzersiz olmak zorunda değildir. Wikidata'nın etiket yönergesi etiketi "öğenin en yaygın bilinen adı" olarak tanımlar ve farklı öğelerin aynı etiketi taşıyabileceğini kabul eder. Ayrımı yapan alan açıklamadır ve Wikidata'nın açıklama yönergesi bunu tek bir kuralla sabitler: Wikidata'da iki öğe aynı etiketi taşıyabilir ama aynı etiketi ve aynı açıklamayı birlikte taşıyamaz. Ayrıştırmanın asıl işini bu nedenle açıklama alanı yapar.
Web sayfalarındaki yapılandırılmış veride bu işlevin karşılığı Schema.org'daki disambiguatingDescription alanıdır. Schema.org, Eylül 2026 itibarıyla geçerli V30.1 sürümünde bu alanı "bir öğeyi diğer benzer öğelerden ayırmak için kullanılan kısa açıklama" olarak tanımlar ve description alanının alt özelliği sayar. Tanımın yanındaki not da önemlidir: açıklamanın ayrıştırmada işe yaraması için diğer alanlardaki bilgiye, özellikle ada ihtiyaç duyulabilir. Yani ayırt edici açıklama tek başına değil, adla birlikte okunur.
| Kavram | Ne işe yarar | Nerede bulunur |
|---|---|---|
| Etiket (label) / name | Varlığın en yaygın adı; benzersiz olmak zorunda değil | Wikidata etiketi, Schema.org name |
| Açıklama (description) | Varlığın ne olduğunu kısa biçimde söyler | Wikidata açıklaması, Schema.org description |
| Ayırt edici açıklama | Aynı adlı varlıklardan ayırır | Schema.org disambiguatingDescription |
| Takma ad (alias) / alternateName | Ad varyantlarının aynı varlığa bağlanmasını sağlar | Wikidata takma adları, Schema.org alternateName |
| sameAs | Kimliği kesin gösteren dış sayfalara bağlar | Schema.org sameAs |
Bu kavramların Türkçe karşılıklarını GEO terimleri sözlüğümüzde bulabilirsiniz. Kavramları eğitim formatında çalışmak isteyen ekipler için GEO Akademi de iyi bir kaynaktır.
Birinci mekanizma: Model web'e bakmadığında baskın anlamı seçer
Model web araması yapmadan cevap verdiğinde yalnız eğitim verisinden öğrendiklerine dayanır ve bir ad ya da kısaltma için en sık gördüğü anlamı seçer. Az bilinen markalar bu bellekte zayıf temsil edildiği için ad, daha yaygın bir kavrama ya da daha bilinen bir firmaya kayar.
Akademik literatür bu eğilimi açıkça ölçmüştür. PopQA çalışması (Mallen vd., ACL 2023) 10 modeli ve 4 bilgi destekleme yöntemini 14 bin soru üzerinde test etti. Bulgular üç noktada toplanıyor: dil modelleri az bilinen varlıklarla ilgili olgularda zorlanıyor, model büyütmek bu uzun kuyruktaki bilgiyi belirgin biçimde iyileştirmiyor ve bilgi getirme (retrieval) ile desteklenen küçük modeller kendilerinden çok daha büyük modelleri geride bırakıyor.
Modelin aramaya ne zaman başvuracağı da sizin kontrolünüzde değildir. OpenAI'ın web araması dokümanı bunu açıkça yazar: model, girdinin içeriğine göre web'de arama yapıp yapmamaya kendisi karar verir. Arama yapılmayan her cevapta markanız, modelin belleğindeki baskın anlamla yarışır.
Sheltron'un Ağustos 2026 ölçümünde 15 hedef sorgu dört platformda arama zorlanmadan soruldu. ChatGPT (o4-mini) 15 sorgunun yalnız 4'ünde web araması yaptı; Gemini 9, Claude 13, Perplexity ise 15 sorgunun hepsinde aradı. Aramasız cevaplarda kısaltma karışıklığı doğrudan görüldü:
- "GEO nedir ve SEO'dan farkı nedir?" sorusuna o4-mini, "GEO (Coğrafi Hedefleme) ve SEO…" diye başlayan bir cevap verdi. Aynı soruda arama yapan Gemini ve Claude, GEO'yu Generative Engine Optimization olarak açtı.
- "AI görünürlük auditi nasıl yapılır?" sorusunu o4-mini, yapay zekâ uygulamalarının şeffaflık ve hesap verebilirlik denetimi olarak yorumladı.
- Ağustos 2026 ölçüm notlarımıza göre ChatGPT, web araması yapmadığı bir cevapta "Türkiye'nin ilk GEO şirketi" olarak GIS Turkey adını verdi; model GEO'yu coğrafya olarak okumuştu.
Aynı ölçümde ChatGPT'nin sitemize atıf oranı 1/15 (%7) iken Perplexity'de 13/15 (%87) oldu. Aradaki fark, arama sıklığıyla tutarlıdır.
Bu mekanizmanın müdahale sınırı nettir: modelin parametrik belleğini site sahibi doğrudan değiştiremez. Yapılabilecek iki şey vardır. Birincisi, markanın ve alanının ayırt edici tanımını web'de tutarlı ve yoğun hâle getirmektir; bu, gelecekte eğitilecek modellerin göreceği veriyi etkiler. İkincisi, aramayı tetikleyen sorgu tiplerinde güçlü olmaktır. ChatGPT yüzeyine özgü adımlar için ChatGPT'de markanızı gösterme rehberimize bakabilirsiniz.
İkinci mekanizma: Bilgi grafiğinde adınız başka bir varlığa ait olabilir
Google Knowledge Graph ve Wikidata gibi bilgi grafiklerinde markanızla aynı etiketi taşıyan güçlü bir öğe varsa, sistemler adınızı o öğeye bağlar. Sizin öğeniz hiç yoksa eşleşme, var olan tek adaya gider. Bu durumda sorun içerikte değil, grafikteki boşluktadır; sitenizdeki metni ne kadar iyileştirirseniz iyileştirin, eşleşme kendiliğinden düzelmez.
Bu katmanı dışarıdan görmenin en doğrudan yolu Google'ın Knowledge Graph Search API hizmetidir. API salt okunurdur, eşleşen varlıkları tek tek döndürür (grafiğin tamamını değil) ve her sonuç için bir resultScore verir. Google, API'nin üretim açısından kritik bir hizmet olarak kullanılmaya uygun olmadığını belirtir; teşhis aracı olarak ise yeterlidir.
Ağustos 2026 ölçümümüzde bu API'ye "sheltron" sorgusu gönderdiğimizde tek sonuç geldi: Schiltron, yani ortaçağda kullanılan bir piyade düzeni (skor 211). Şirket varlığı Knowledge Graph'ta yoktu. Eylül 2026'da Wikidata API'sinde aynı adla yaptığımız aramada da tek sonuç çıktı: Q1754114. Öğenin İngilizce etiketi markamızın adıyla birebir aynı, açıklaması ise "Infantry formation" (piyade düzeni). Almanca ve Fransızca etiketi "Schiltron", İngilizce takma adları arasında "shiltron" ve "sceld-trome" var ve öğe 14 dildeki Wikipedia maddesine bağlı. Eylül 2026 itibarıyla şirket için ayrı bir Wikidata öğesi bulunmuyor ve Türkçe Wikipedia'da bu adla yapılan arama 0 sonuç veriyor. Knowledge Graph sonucunun Ağustos 2026'dan sonra değişip değişmediğini ölçmedik; bu nedenle güncel durumu bilinmiyor.
Bilgi grafiğinin ağırlığı yalnız Google araması için geçerli değildir. Profound'un atıf analizine göre Ağustos 2024–Haziran 2025 arasındaki 680 milyon atıfta, ChatGPT'nin en çok atıf verdiği ilk 10 kaynak içinde Wikipedia'nın payı %47,9 oldu. Wikipedia maddeleri Wikidata öğeleriyle bağlantılı olduğundan, bu iki kaynakta baskın olan anlam yapay zekâ cevaplarına da taşınabilir. Türkçe sorgularda hangi kaynakların öne çıktığını Türkçe LLM kaynak analizimizde ayrıca inceledik.
Google'ın bilgi paneli yardım sayfası, panellerin web'deki çeşitli kaynaklardan otomatik üretildiğini ve varlığın paneli sahiplenip değişiklik önerebileceğini belirtir. Ne var ki sahiplenilecek bir panel, yalnız grafikte markanıza ait bir varlık oluştuğunda ortaya çıkar. Grafikte yalnız aynı adlı başka bir varlık varsa ilk iş, kendi varlığınızın tanınması için gereken kanıtı üretmektir.
Üçüncü mekanizma: Arama sorguyu yanlış bağlamda çalıştırabilir
Model web'de arasa bile arama sorgusunu kendi yorumuyla kurar ve adın popüler anlamına ait belgeleri getirebilir. Bu durumda cevap kaynaklıdır, bağlantılar gerçektir ama anlatılan konu ya da varlık yanlıştır. Karışıklık modelin belleğinde değil, bilgi getirme (retrieval) aşamasında, yani hangi belgelerin seçildiği noktada doğar.
AmbER çalışması bu aşamadaki yanlılığı doğrudan ölçtü. Aynı adı paylaşan varlık çiftleri üzerinde yapılan testlerde bilgi getirme sistemleri popülerlik yanlılığı gösterdi: daha az bilinen varlık sorulduğunda yanlış belge getirme olasılığı iki katına çıktı. Pratikte bu, web'deki bahislerin çoğu başka bir anlama aitse, arama sonuçlarının da o anlama kayacağı anlamına gelir.
Ağustos 2026'daki web bahis taramamızda markamızın adı 1.799 kez geçiyordu. Bu bahislerin çoğu Final Fantasy XIV oyunundaki aynı adlı yetenekten, ABD'li bir imalatçıdan ve Hindistan'daki bir emlak şirketinden geliyordu. Türkiye'den tek bağımsız bahis bir teknoloji sitesindeki liste yazısıydı. Böyle bir havuzda arama sistemi, sorguya bağlam eklenmedikçe başka varlıkları getirmeye yatkındır.
Aynı ölçümde belirsiz bir sorgu olan "Ankara GEO stratejisi", dört platformda dört farklı yoruma yol açtı. Dört platform da web'de aradı:
| Platform (model) | Cevabın yorumu | Getirilen kaynaklardan örnekler |
|---|---|---|
| ChatGPT (o4-mini) | GEO'yu jeostrateji olarak okudu: "Ankara'nın Jeostratejik Hedefleri ve Çok Boyutlu Dış Politikası" | tandfonline.com, papers.ssrn.com, cidob.org, kalkinmakutuphanesi.gov.tr |
| Gemini (gemini-3.5-flash) | İfadenin "iki temel alanda" farklı anlamı olduğunu söyleyip ikisini de açtı | Yalnız Google'ın yönlendirme adresi (vertexaisearch.cloud.google.com); asıl kaynaklar kayıtta görünmüyor |
| Claude (claude-sonnet-5) | Sorunun belirsiz olduğunu açıkça belirtip iki yorumu ayırdı | onuroztr.com, dijitalkafa.com, digitalpals.com |
| Perplexity (sonar) | İfadeyi, markanın yapay zekâ yanıtlarında Ankara ile ilişkilendirilmesini hedefleyen konum temelli bir görünürlük planı olarak yorumladı; Sheltron'a atıf verdi | sheltron.com.tr, geo-builder.com, dergipark.org.tr |
Daha ince bir örnek, iki mekanizmanın birlikte çalıştığını gösteriyor. ChatGPT, web araması yaptığı "Türkiye'nin ilk GEO teknoloji şirketi hangisidir?" sorusunda doğru kaynağı buldu ve hakkımızda sayfamıza atıf verdi. Buna rağmen GEO'yu yine "coğrafi konum tabanlı" diye açtı. Doğru kaynağı bulmak, doğru varlığı anlatmayı garanti etmez: kısaltmanın baskın anlamı, kaynaklı bir cevaba bile sızabilir.
Bu mekanizmada asıl kaldıraç, üçüncü taraf bahislerin sizi doğru bağlamla birlikte anmasıdır. Bahislerin sayısı kadar hangi bağlamda geçtikleri de önemlidir; bu konuyu marka bahsi ve AI görünürlüğü yazımızda ayrıntılı ele aldık.
Karışıklığın hangi mekanizmadan geldiğini nasıl teşhis edersiniz?
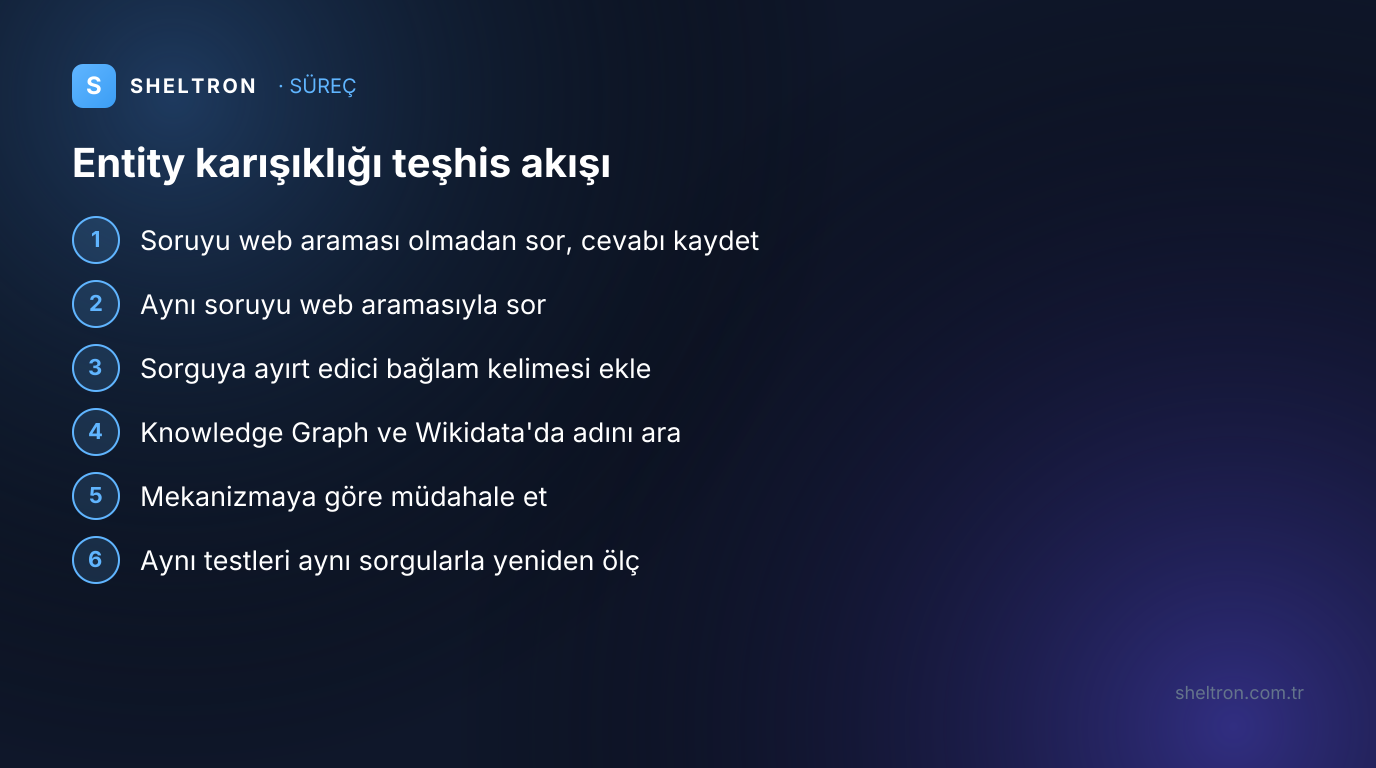
Aynı soruyu üç koşulda sorun: web araması kapalıyken, web araması açıkken ve sorguya ayırt edici bir bağlam kelimesi ekleyerek. Ardından Knowledge Graph Search API ve Wikidata aramasıyla adınızın hangi varlığa bağlandığına bakın. Karışıklığın hangi testte kaybolduğu kaynağını gösterir; müdahaleyi de bu sonuca göre seçersiniz.
| Mekanizma | Tipik belirti | Teşhis testi | Öncelikli müdahale |
|---|---|---|---|
| Parametrik bellek | Kaynaksız cevapta adınız veya kısaltmanız başka anlamla açılıyor | Aramasız cevap yanlış, aramalı cevap doğru | Web'de tutarlı ayırt edici tanım; aramayı tetikleyen sorgularda güçlü içerik |
| Bilgi grafiği | Knowledge Graph veya Wikidata aramasında adınız başka bir öğeye çıkıyor | Knowledge Graph Search API ve Wikidata arama çağrısı | Kendi öğeniz, ayırt edici açıklama, sameAs bağlantıları |
| Bilgi getirme | Aramalı cevap kaynaklı ama kaynaklar başka konuya ait | Aramalı cevap yanlış, bağlam kelimeli sorgu doğru | Kısaltmayı açma, bağlamlı üçüncü taraf bahisleri, sayfanın ilk cümlesinde net tanım |
Bilgi grafiği testleri için iki basit çağrı yeterlidir. İlki Knowledge Graph'ta adınızın hangi varlıklara eşleştiğini gösterir ve bir Google Cloud API anahtarı gerektirir. İkincisi Wikidata'da aynı etiketi ya da takma adı taşıyan öğeleri listeler ve herkese açıktır:
curl "https://kgsearch.googleapis.com/v1/entities:search?query=MARKA&languages=tr&limit=5&key=API_KEY"
curl "https://www.wikidata.org/w/api.php?action=wbsearchentities&search=MARKA&language=tr&format=json&limit=20"
İlk yanıtta her sonucun adına, türüne (@type), açıklamasına ve resultScore değerine bakın. İkinci yanıtta her öğenin etiketini, açıklamasını ve eşleşmenin etiketten mi takma addan mı geldiğini (match.type) kontrol edin.
Arama tarafında Google Search Console da ipucu verir. 12 aylık verimizde yalın "sheltron" sorgusu 1.220 gösterim ve 167 tıklama aldı, ortalama pozisyonu 3,6 oldu. Ayırt edici bir kelime içeren "sheltron teknoloji" sorgusu ise 39 gösterimde 20 tıklama aldı ve ortalama pozisyonu 1,28 oldu. Aynı dönemde "shelltron", "shiltron" ve "shelron" gibi yazım varyantları da birkaç gösterim aldı. Bu bir korelasyondur, nedensellik kanıtı değildir; ancak yalın adın daha kalabalık bir sonuç sayfasıyla yarıştığını düşündürür.
Kod yazmadan başlamak isterseniz Sheltron'un ücretsiz AI Görünürlük Spot Check aracı markanızı 5 sektörel sorguda tek seferlik test eder ve cevabın sizi hangi bağlamda andığını görmenizi sağlar. Marka takibi aracı ise 5 özelleştirilmiş sorgudaki bahis oranını haftalık olarak izler; müdahale öncesi ve sonrasını karşılaştırırken bu zaman serisi işe yarar.
Sayfada ve şemada ayırt edici tanım nasıl yazılır?
Ayırt edici tanım, markanın türünü, sektörünü ve konumunu tek cümlede söyleyen ve adla birlikte okunduğunda başka hiçbir varlığa uymayan cümledir. Bu cümle önce sayfanın görünür metninde, ardından Organization şemasındaki description ve disambiguatingDescription alanlarında aynı anlamla yer almalıdır. Şemadaki ifadenin sayfada karşılığı yoksa, işaretleme Google'ın yapılandırılmış veri yönergeleriyle çelişir.
Sayfa tarafında dört kural işe yarar:
- İlk cümlede tür, sektör ve konum: "X, İstanbul merkezli bir yapay zekâ görünürlüğü yazılım şirketidir" gibi bir cümle, adı tek başına bırakmaz.
- Kısaltmayı ilk geçtiği yerde açın: Faaliyet alanınızın kısaltması başka bir anlamda daha yaygınsa ilk kullanımda açılımını yazın. Örneğin GEO'yu ilk geçtiği yerde Generative Engine Optimization (üretken motor optimizasyonu) olarak açmak, "coğrafi hedefleme" okumasını baştan keser.
- Ad varyantlarını sabitleyin: Ticari ad, resmî unvan ve kısa ad her yerde aynı biçimde yazılmalıdır.
- Olumsuzlamayı ölçülü kullanın: "X adlı oyunla ilgisi yoktur" cümlesi isteğe bağlıdır; asıl işi tür, sektör ve konum bilgisi yapar.
Şema tarafında Google'ın Organization yapılandırılmış veri dokümanı, ana sayfaya eklenen Organization işaretlemesinin kurumunuzu arama sonuçlarında diğerlerinden ayırmaya yardımcı olduğunu belirtir. Önerilen alanlar arasında name, alternateName, legalName, url, logo, description ve sameAs var; vatID, taxID, leiCode ve duns gibi tanımlayıcılar da ayrıştırmayı güçlendirir. Aşağıdaki örnek kurgusal bir şirket içindir:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://ornek.com.tr/#organization",
  "name": "Örnek Teknoloji A.Ş.",
  "alternateName": "Örnek",
  "legalName": "Örnek Teknoloji Anonim Şirketi",
  "url": "https://ornek.com.tr/",
  "description": "Örnek, işletmelerin yapay zekâ platformlarındaki görünürlüğünü ölçen bir yazılım şirketidir.",
  "disambiguatingDescription": "İstanbul merkezli yapay zekâ görünürlüğü yazılım şirketi; aynı adı taşıyan lojistik firmasıyla bağlantısı yoktur.",
  "sameAs": [
    "https://www.linkedin.com/company/ornek",
    "https://www.crunchbase.com/organization/ornek"
  ]
}
Şirketinizin bir Wikidata öğesi varsa, öğenin adresini de sameAs listesine ekleyin; olmayan bir öğeye bağlantı vermeyin. Google'ın yapılandırılmış veri yönergeleri işaretlemenin sayfa içeriğini doğru yansıtmasını ve okuyucuya görünmeyen içeriğin işaretlenmemesini ister. Bu yüzden disambiguatingDescription'daki ifade, sayfanın görünür metninde de karşılık bulmalıdır.
Kendi durumumuzu da açıkça yazalım: Eylül 2026 itibarıyla sitemizin canlı Organization şemasında disambiguatingDescription alanı ve Wikidata sameAs bağlantısı yok; sameAs listesinde LinkedIn, Crunchbase, X (Twitter) ve Instagram profilleri yer alıyor. Şemanızı Schema Markup Üreticisi ile Organization ve sameAs alanlarıyla oluşturup disambiguatingDescription satırını elle ekleyebilir, sonucu Schema Markup Doğrulayıcı ile kontrol edebilirsiniz. JSON-LD'nin temelleri için Schema.org JSON-LD teknik rehberimiz başlangıç noktasıdır.
Wikidata ve üçüncü taraf profiller ayrıştırmayı nasıl tamamlar?
Bilgi grafiği katmanında ayrıştırma, markanın kendi öğesinin bulunması ve bu öğenin açıklamasının aynı etiketli diğer öğelerden açıkça ayrılmasıyla sağlanır. LinkedIn, Crunchbase ve sektör dizinleri gibi profiller aynı adı, aynı tanımı ve aynı resmî siteyi tekrarladıkça, sistemlerin eşleştirme için kullanacağı kanıt çoğalır.
Wikidata'nın açıklama yönergesi, ayırt edici tanımın nasıl yazılacağına dair iyi bir kalıp sunar. Açıklama 2 ile 12 kelime arasında olmalı, özel adlar dışında küçük harfle başlamalı, artikel ve tanıtım dili içermemeli, sonunda nokta olmamalıdır. Yönergedeki örnek de öğreticidir: "Amerika'nın en iyi romancısı" değil, "Amerikalı romancı". Örneğin "yapay zekâ görünürlüğü alanında İstanbul merkezli yazılım şirketi" gibi bir açıklama, aynı etiketi taşıyan bir piyade düzeni ya da oyun yeteneğiyle karışmaz.
Takma adlar ikinci önemli alandır. Wikidata'nın etiket yönergesine göre takma adlar, öğenin farklı adlarla aranırken de bulunmasını sağlar. Ticari adınızın yaygın yazım varyantlarını ve resmî unvanınızı kendi öğenizin takma adlarına eklemek, bu varyantların başka bir öğeye gitmesini zorlaştırır. Wikidata'da öğe oluşturmanın adım adım süreci ayrı bir konudur; burada önemli olan, öğe oluştuğunda açıklama ve takma ad alanlarının ayrıştırma işini üstlenmesidir.
Üçüncü taraf profillerde kural tutarlılıktır:
- Aynı ad: Resmî unvan ile kısa ad, her profilde aynı biçimde yazılmalı.
- Aynı tanım: Sitenizdeki ayırt edici cümlenin kısa bir versiyonu profil açıklamalarında da kullanılmalı.
- Aynı resmî site: Her profil aynı alan adına bağlantı vermeli; bu bağlantılar sameAs listenizle karşılıklı olmalı.
- Doğru bağlam: Basın ve sektör yayınlarındaki bahislerde marka adı, faaliyet alanıyla birlikte geçmeli.
Bu sinyallerin güvenilirlikle ilişkisini E-E-A-T ve yapay zekâ yazımızda ayrıntılı işledik. Entity ve otorite kavramlarını İngilizce kaynaklarla karşılaştırmak isteyenler The GEO Authority üzerinden devam edebilir.
Müdahaleden sonra neyi, ne zaman yeniden ölçmelisiniz?
Müdahaleden önce kaydettiğiniz testleri aynı sorgular, aynı platformlar ve aynı araçlarla tekrarlayın: Knowledge Graph Search API sonucu, Wikidata araması, aramasız ve aramalı model cevapları. Süre için güvenilir bir garanti yoktur; modelin belleği yeni bir sürüm eğitilmeden değişmeyebilir. Bu yüzden ölçümü tek seferlik değil, düzenli aralıklarla yapın.
Ölçümün değeri, başlangıç noktasının kayıtlı olmasına bağlıdır. Kendi markamız için tuttuğumuz başlangıç tablosu şöyle:
| Yüzey | Sorgu | Sonuç | Tarih | Mekanizma |
|---|---|---|---|---|
| Knowledge Graph Search API | "sheltron" | Tek sonuç: Schiltron, skor 211; şirket varlığı yok | Ağustos 2026 | Bilgi grafiği |
| Web bahis taraması | "sheltron" | 1.799 bahis; çoğu oyun yeteneği, ABD'li imalatçı ve Hint emlak şirketi | Ağustos 2026 | Bilgi getirme |
| ChatGPT (o4-mini), aramasız | "GEO nedir ve SEO'dan farkı nedir?" | "GEO (Coğrafi Hedefleme)" | Ağustos 2026 | Parametrik bellek |
| ChatGPT, aramasız | "Türkiye'nin ilk GEO şirketi" | GIS Turkey | Ağustos 2026 | Parametrik bellek |
| Wikidata API | "Sheltron" | Tek sonuç: Q1754114, "Infantry formation", 14 sitelink | Eylül 2026 | Bilgi grafiği |
| Türkçe Wikipedia | "Sheltron" | 0 sonuç | Eylül 2026 | Bilgi grafiği |
Yeniden ölçümde üç kurala uyun. İlki, sorguları ve platformları sabit tutmaktır; yeni sorgu eklemek serbesttir ama karşılaştırma yalnız aynı sorgular üzerinden yapılır. İkincisi, aramasız ve aramalı sonuçları ayrı raporlamaktır; ikisini tek bir oranda birleştirmek, hangi mekanizmanın düzeldiğini gizler. Üçüncüsü, model sürümünü kaydetmektir; sonuç değiştiğinde bunun müdahaleden mi yoksa model güncellemesinden mi kaynaklandığını ancak böyle ayırabilirsiniz.
Hangi yüzeyin önce düzeleceği konusunda bir beklenti kurmak mümkün ama bu ölçülmüş bir sonuç değil, bir çıkarımdır. Web'de arayan yüzeyler yeni kaynakları görebildiği için ilk tepki verenler olabilir; bilgi grafikleri kendi güncelleme döngüsüne bağlıdır; aramasız model cevapları ise ancak yeni eğitim verisiyle değişir. Kendi entity çalışmamızın sonucunu henüz ölçmedik. Eylül 2026 itibarıyla şirket öğesi oluşturulmadığı için bir önce-sonra karşılaştırması da bulunmuyor. Sabit 15 sorguyla yaptığımız haftalık atıf ölçümlerini canlı görünürlük sayfamızda yayımlıyoruz.
Adınız yapay zekâda başka bir şeyi çağırıyorsa, ilk iş hangi katmanda kaybolduğunuzu bulmaktır. Marka adınızı ve karışıklığı gözlemlediğiniz birkaç soruyu Sheltron hızlı değerlendirme formuna yazın; hangi mekanizmanın devrede olduğunu birlikte ayıralım.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Yapay Zekâ Markanızı Başka Bir Firmayla Karıştırıyorsa: Entity Ayrıştırma Nasıl Yapılır?
- TL;DR
- Yapay zekâ bir marka adını, o adı taşıyan en bilinen varlıkla eşleştirir. AmbER çalışmasına göre aynı adlı varlıklardan daha az bilineni sorulduğunda yanlış belge getirme olasılığı 2 kat. Ağustos 2026 ölçümümüzde Knowledge Graph'ta 'sheltron' sorgusu tek sonuç verdi: Schiltron (skor 211). ChatGPT 15 sorgunun 4'ünde web'de aradı, aramadığı bir cevapta GEO'yu 'Coğrafi Hedefleme' diye açtı.
- Ana Çıkarımlar (7)
- Marka adı karışıklığı üç ayrı yerde doğar: modelin parametrik belleği, Knowledge Graph/Wikidata eşleşmesi ve web aramasındaki retrieval; her birinin teşhisi ve müdahalesi farklıdır.
- AmbER (ACL 2021): aynı adı paylaşan iki varlıktan daha az bilineni sorulduğunda arama sistemlerinin yanlış belge getirme olasılığı 2 kat yüksek.
- Ağustos 2026 ölçümünde ChatGPT (o4-mini) 15 sorgunun yalnız 4'ünde web araması yaptı; aramadığı bir cevapta GEO'yu 'Coğrafi Hedefleme' diye açtı.
- Ağustos 2026'da Knowledge Graph Search API'de 'sheltron' sorgusu tek sonuç verdi: Schiltron (skor 211); Eylül 2026 itibarıyla Wikidata'da aynı etiketli tek öğe 14 sitelink'li bir piyade düzeni.
- Teşhis için aynı soru üç koşulda sorulur: aramasız, aramalı ve bağlam kelimeli; karışıklığın hangi testte kaybolduğu kaynağını gösterir.
- Wikidata'da iki öğe aynı etiket ve aynı açıklamaya birlikte sahip olamaz; açıklama 2-12 kelime, tanıtım dili içermeyen bir tür-sektör-konum tanımı olmalı.
- Organization şemasında disambiguatingDescription ve sameAs, sayfanın görünür metniyle aynı anlamı taşımalı; sonuç süresi için garanti yoktur.
- Kaynaklı Veriler
- 2 kat — Aynı adı paylaşan iki varlıktan daha az bilineni sorulduğunda, retrieval sistemlerinin yanlış belge getirme olasılığı (Chen vd., AmbER (ACL-IJCNLP 2021), 2021)
- %50'den fazla — NQ-open açık alan sorularında bir tür belirsizlik içeren soruların payı; kaynaklardan biri varlık referansları (AmbigNQ: 14.042 soru) (Min vd., AmbigQA (EMNLP 2020), 2020)
- 14 bin soru, 10 model — PopQA deneyinde dil modellerinin az bilinen varlıklarda zorlandığı, ölçek büyütmenin bunu belirgin düzeltmediği görüldü (Mallen vd., When Not to Trust Language Models (ACL 2023), 2023)
- %47,9 — ChatGPT'nin en çok atıf verdiği ilk 10 kaynak içinde Wikipedia'nın payı (680 milyon atıf, Ağustos 2024–Haziran 2025) (Profound, 2025)
- 211 — Ağustos 2026'da Knowledge Graph Search API'de 'sheltron' sorgusunun tek sonucu olan Schiltron'un skoru; şirket varlığı grafikte yok (Sheltron ölçümü (Ağustos 2026), 2026)
- 1.799 — Ağustos 2026 web bahis taramasında 'sheltron' bahsi; çoğu Final Fantasy XIV yeteneği, ABD'li imalatçı ve Hint emlak şirketi (Sheltron ölçümü (Ağustos 2026), 2026)
- 4/15 — ChatGPT (o4-mini) 15 hedef sorgunun yalnız 4'ünde web araması yaptı; Gemini 9, Claude 13, Perplexity 15 (Sheltron LLM atıf ölçümü (Ağustos 2026), 2026)
- 1/15 (%7) — Aynı ölçümde ChatGPT'nin sheltron.com.tr'ye atıf oranı; Perplexity'de 13/15 (%87) (Sheltron LLM atıf ölçümü (Ağustos 2026), 2026)
- 14 Wikipedia bağlantısı — Eylül 2026 itibarıyla Wikidata'da İngilizce etiketi 'Sheltron' olan tek öğe (Q1754114, piyade düzeni); şirket öğesi yok (Wikidata (Sheltron kontrolü, Eylül 2026), 2026)
- 3,6 — 12 aylık Search Console verisinde yalın 'sheltron' sorgusunun ortalama pozisyonu; 'sheltron teknoloji' sorgusunda 1,28 (Sheltron Google Search Console verisi (Ağustos 2026), 2026)
- Arama Niyetleri
- yapay zeka markamı başka firmayla karıştırıyor
- chatgpt marka adı karışıklığı
- entity disambiguation nedir
- aynı isimli marka yapay zeka
- kısaltma yanlış anlaşılıyor chatgpt
- disambiguatingDescription schema
- knowledge graph marka kontrolü
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz