
Türkçe Token Sayısı: Aynı Metin Türkçede 1,48 Kat Token Tutuyor, GEO İçin Ne Anlama Geliyor?
İnsan Hakları Evrensel Beyannamesi'nin Türkçe ve İngilizce metnini, Sheltron blogundan 161 paragrafı ve 50 GEO terimini üç OpenAI tokenizer'ıyla ölçtük: Türkçe token vergisi, diyakritik etkisi, answer-first paragraf ve chunk bütçesi.
💡Kısa Özet
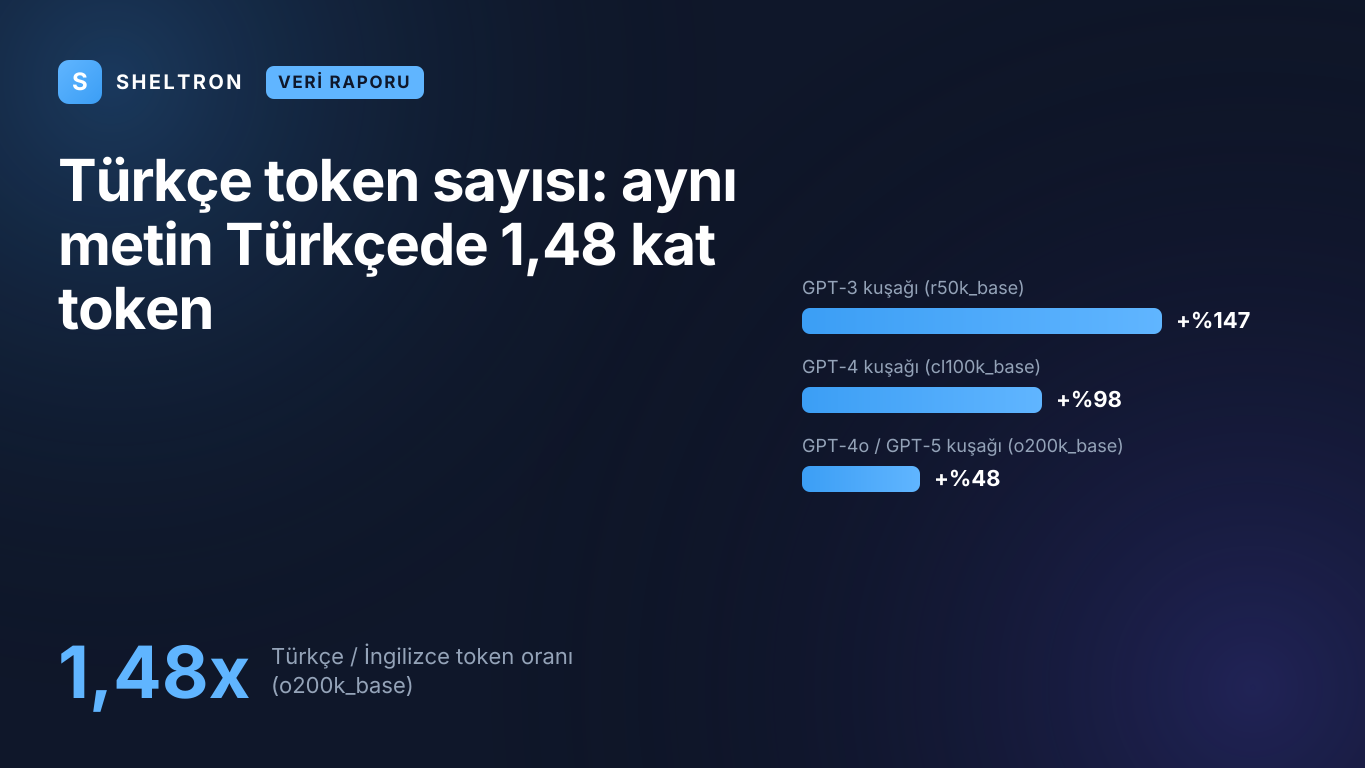
Aynı içerik o200k_base tokenizer'ında (GPT-4o/GPT-5 kuşağı) Türkçede 2.990, İngilizcede 2.017 token tutuyor: 1,48 kat. Bu oran GPT-3 kuşağında 2,47, GPT-4 kuşağında 1,98 idi. Türkçe karakterleri ASCII'ye çevirmek yeni tokenizer'da token sayısını %4,7 artırıyor. 40-60 kelimelik Türkçe paragraf medyan 95 token; 800 token'lık parça yaklaşık 365 Türkçe kelime taşıyor. Gemini ve Claude ölçülmedi.
Ana Çıkarımlar
- •İnsan Hakları Evrensel Beyannamesi'nin Türkçe metni o200k_base'de 2.990, İngilizcesi 2.017 token tutuyor; aynı içerik Türkçede 1,48 kat token harcıyor.
- •Türkçe/İngilizce token oranı tokenizer kuşağıyla düştü: GPT-3 kuşağında 2,47, GPT-4 kuşağında 1,98, GPT-4o/GPT-5 kuşağında 1,48.
- •Türkçe karakterleri ASCII'ye çevirmek o200k_base'de token sayısını azaltmıyor, artırıyor: beyannamede %4,7, Sheltron paragraflarında %6,1.
- •Elle seçilen 50 GEO teriminin Türkçede yalnız 5'i tek token; İngilizce karşılıklarında bu sayı 37. Toplam: 135'e karşı 64 token.
- •40-60 kelimelik bir Türkçe answer-first paragraf o200k_base'de medyan 95 token tutuyor (46 paragraf, 78-155 aralığı).
- •OpenAI'ın varsayılan 800 token'lık parçası yaklaşık 365 Türkçe, 693 İngilizce kelime taşıyor.
- •Gemini ve Claude tokenizer'larında Türkçe token sayısı ölçülmedi, bilinmiyor; Anthropic'in %30 artış bilgisi dil ayırmıyor.
Türkçe token sayısı, aynı içeriğin İngilizce karşılığından belirgin biçimde yüksek. İnsan Hakları Evrensel Beyannamesi'nin Türkçe metni, GPT-4o ve GPT-5 kuşağının kullandığı o200k_base tokenizer'ında 2.990 token; İngilizce metni 2.017 token. Aynı içerik Türkçede 1,48 kat, yani %48 daha fazla token harcıyor (Sheltron ölçümü, Eylül 2026). Akademik literatür, aynı metnin token uzunluğunun bazı dil çiftlerinde 15 kata kadar farklılaşabildiğini gösteriyor (Petrov ve ark., NeurIPS 2023).
Token, bir dil modelinin metni okurken kullandığı alt birimdir. API ücreti, bağlam penceresi ve bir sayfanın parçalara (chunk) bölünmesi bu birimle hesaplanır. Bu nedenle soru yalnız teknik bir merak değil: GEO açısından bir pasajın modelin gözünde ne kadar yer kapladığını, bir parçaya kaç Türkçe kelime sığdığını ve Türkçe karakterleri kaldırmak gibi yazım tercihlerinin neyi değiştirdiğini belirliyor. Eylül 2026'da üç OpenAI tokenizer'ıyla bir paralel metni, Sheltron blogundan 161 paragrafı ve 50 GEO terimini ölçtük. Yöntemi ve sınırlılıkları aşağıda açıkça yazıyoruz.
Türkçe bir metin kaç token tutar?
GPT-4o kuşağının o200k_base tokenizer'ında Türkçe metin kelime başına ortalama 2,19 token tutuyor; aynı içeriğin İngilizcesinde bu değer 1,15. Beyannamede Türkçe metin 1.364 kelimeyle 2.990, İngilizce metin 1.747 kelimeyle 2.017 token çıktı. Türkçe aynı içeriği daha az kelimeyle anlatıyor ama %48 daha fazla token harcıyor.
Aşağıdaki tablo aynı içeriğin üç sürümünü üç tokenizer kuşağında gösteriyor. "ASCII'ye katlanmış" sürüm, Türkçe metindeki ç, ğ, ı, ö, ş, ü harflerinin c, g, i, o, s, u ile değiştirilmiş hâlidir; kelime ve karakter sayısı değişmez.
| Sürüm | Karakter | Kelime | o200k_base | cl100k_base | r50k_base |
|---|---|---|---|---|---|
| Türkçe | 10.278 | 1.364 | 2.990 | 3.984 | 5.033 |
| Türkçe, ASCII'ye katlanmış | 10.278 | 1.364 | 3.132 | 3.705 | 4.220 |
| İngilizce | 10.637 | 1.747 | 2.017 | 2.016 | 2.035 |
| Türkçe / İngilizce token oranı | 1,48 | 1,98 | 2,47 | ||
| Kelime başına token (TR · EN) | 2,19 · 1,15 | 2,92 · 1,15 | 3,69 · 1,17 | ||
| Token başına karakter (TR · EN) | 3,44 · 5,27 | 2,58 · 5,28 | 2,04 · 5,23 |
Kaynak: kendi ölçümümüz, İnsan Hakları Evrensel Beyannamesi (başlık, önsöz ve 30 madde), js-tiktoken 1.0.21, Eylül 2026.
Tablonun en öğretici sütunu kelime sayısı. Türkçe metin İngilizcesinden %22 daha az kelime kullanıyor, çünkü İngilizcede ayrı kelimeyle söylenen edatlar, iyelikler ve zamanlar Türkçede eklerle aynı kelimeye bağlanıyor. Kelime azalıyor ama her kelime daha uzun ve daha nadir bir karakter dizisine dönüşüyor; tokenizer da bu diziyi daha çok parçaya bölüyor. Sonuçta bir o200k_base token'ı İngilizcede ortalama 5,27 karakter taşırken Türkçede 3,44 karakter taşıyor.
1,48 bu metne ait bir sonuç, Türkçe için sabit bir katsayı değil. Beyannameyi maddelere böldüğümüzde Türkçe/İngilizce oranı 30 maddede 1,15 ile 2,10 arasında değişti, medyanı 1,55 oldu. Beyannamenin Türkçe çevirisi "hürriyet", "haysiyet" gibi eski kelimeler içerdiği için ikinci bir örneklem de ölçtük: Sheltron blogunun Ağustos 2026'da yayımlanan 20 yazısındaki 161 paragrafta kelime başına token 2,17 çıktı. Güncel web Türkçesi ile eski hukuk metni neredeyse aynı oranı veriyor.
Nasıl ölçtük?
- Paralel metin: Unicode Konsorsiyumu'nun "UDHR in Unicode" projesindeki Türkçe ve İngilizce beyanname metinleri. Konsorsiyum projeyi Ocak 2024'ten beri barındırmadığı için dosyalar NLTK veri deposundaki kamu malı aynadan alındı.
- Tokenizer'lar: OpenAI'ın açık kaynak tiktoken kütüphanesindeki o200k_base, cl100k_base ve tarihsel referans olarak r50k_base; uygulama olarak js-tiktoken 1.0.21 kullanıldı.
- Blog paragrafları: 4–31 Ağustos 2026 arasında yayımlanan en yeni 20 canlı yazının H2 başlıklarının altındaki ilk paragraflar; 212 paragraftan 161'i uygunluk kuralını geçti.
- Terimler: Elle seçilmiş 50 GEO terimi ve İngilizce karşılıkları, ayrıca 13 ekli biçim. Liste rastgele örneklem değildir.
Türkçe neden daha çok token harcıyor?
Tokenizer'lar, eğitim verisinde sık geçen karakter dizilerini tek birim olarak saklayan bir sözlükle çalışır. Sözlükte bütün hâliyle bulunmayan kelime parçalara bölünür. Türkçe eklemeli bir dil olduğu için tek kelime birkaç ek taşır ve her ek ayrı bir parça olabilir: "evlerimizden" o200k_base'de ev·ler·imiz·den olarak dört token tutuyor.
OpenAI'ın kullandığı yöntem bayt çifti kodlaması (BPE) adını taşır. tiktoken belgelerine göre BPE metni sıkıştırır ve pratikte bir token ortalama 4 bayta karşılık gelir. Bu ortalama dile göre değişir. UTF-8 kodlamasında İngilizce harfler birer bayt tutarken ç, ğ, ı, ö, ş, ü ikişer bayt tutar; sözlük bu harfleri içeren dizileri yeterince sık görmediyse onları küçük parçalara ayırmak zorunda kalır.
Akademide bu ölçünün adı "fertility", yani kelime başına üretilen alt birim sayısıdır. Rust ve ark. (ACL 2021), fertility değerinin 1 olmasını, tokenizer sözlüğünün metindeki her kelimeyi bütün olarak içermesi şeklinde tanımlar ve çok dilli mBERT modelinin Türkçeyi aşırı böldüğünü gösterir. Bizim ölçümümüzde o200k_base için bu değer Türkçede 2,19, İngilizcede 1,15.
Farkın maliyet tarafını Ahia ve ark. (EMNLP 2023) 22 dil üzerinde inceledi. Çalışmaya göre token başına fiyatlandırılan ticari modellerde, desteklenen pek çok dilin kullanıcıları daha fazla ödüyor ve daha zayıf sonuç alıyor. Türkçeye özel çalışmalar ise çözümü tokenizer tasarımında arıyor: Toraman ve ark., kelimeleri morfoloji düzeyinde bölen bir tokenizer'ın yaygın yöntemlerle rekabet edebildiğini gösteriyor.
Yeni ve eski tokenizer arasındaki fark parçaların biçiminde de görülüyor. o200k_base Türkçe kelimeleri çoğunlukla eklerin sınırından bölüyor: " görün·ür·lük", " ev·ler·imiz·den". GPT-4 kuşağının cl100k_base tokenizer'ı ise aynı kelimeleri harf ve bayt düzeyine kadar indiriyor: " gör·ün·ü·rl·ük", " ö·l·ç·üm". "Tokenizer Türkçeyi eklerinden bölüyor" cümlesi yeni kuşak için büyük ölçüde doğru, eski kuşak için değil. Eklemeli yapının kullanıcı sorgularına yansımasını Türkçe long-tail sorgular yazımızda ayrıca ele aldık.
GPT-3'ten GPT-4o'ya Türkçe token vergisi 2,47'den 1,48'e indi
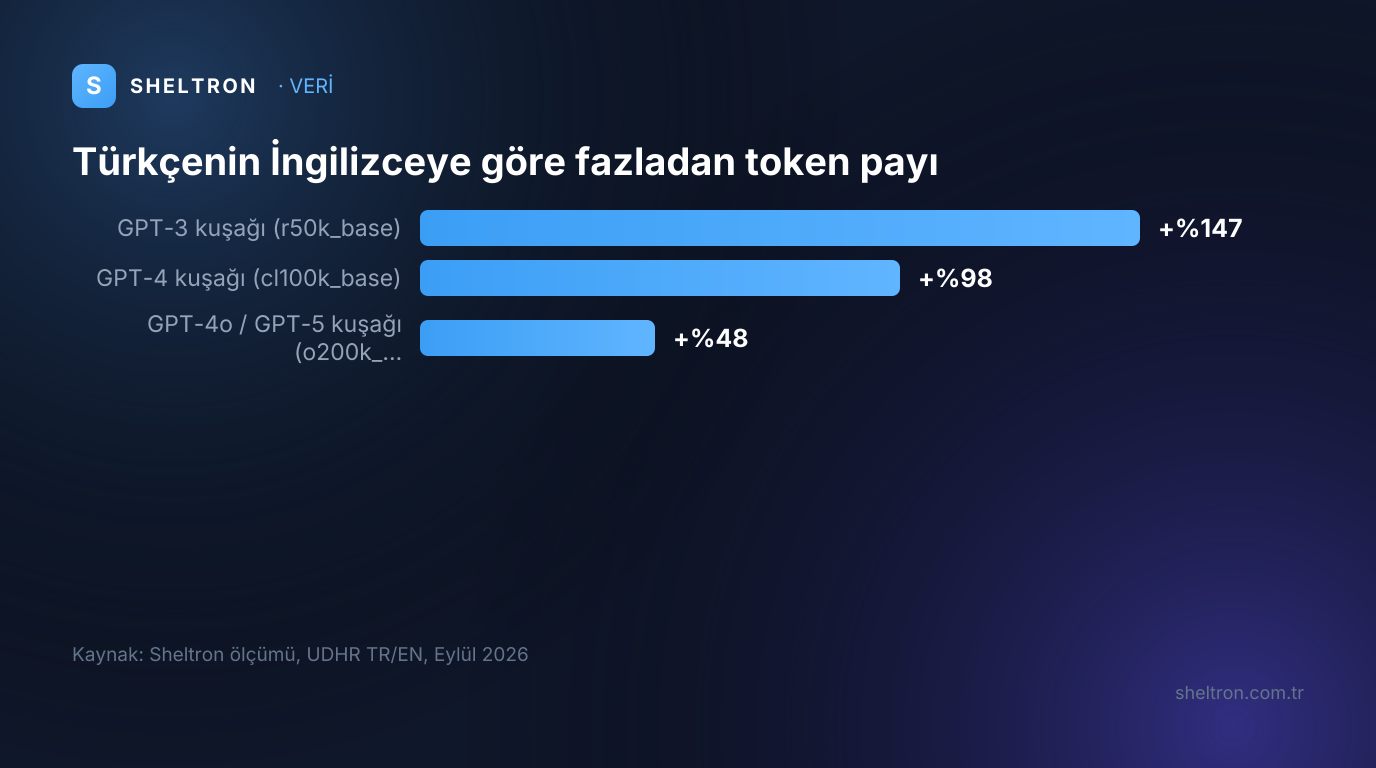
Aynı Türkçe metin, GPT-3 kuşağının r50k_base tokenizer'ında İngilizcenin 2,47 katı, GPT-4 kuşağının cl100k_base'inde 1,98 katı, GPT-4o ve GPT-5 kuşağının o200k_base'inde 1,48 katı token tutuyor. Yeni tokenizer Türkçe beyannamenin token sayısını %25 azalttı; İngilizce metni ise neredeyse hiç değiştirmedi. Türkçe için fark kapanmadı ama belirgin biçimde daraldı.
"Token vergisi" dediğimiz şey, aynı içeriği Türkçe yazmanın İngilizceye göre fazladan harcattığı token payıdır. Beyannamede bu pay GPT-3 kuşağında %147, GPT-4 kuşağında %98, GPT-4o kuşağında %48. GPT-4'ten GPT-4o'ya geçişte İngilizce metnin token sayısı sabit kaldı (2.016'dan 2.017'ye), Türkçe metninki ise 3.984'ten 2.990'a indi. Yeni tokenizer'ın getirdiği kazanç İngilizcede değil, Türkçede ortaya çıktı.
| Kuşak | Kodlama | Kullanan modeller (tiktoken eşlemesi, Eylül 2026) | TR token | EN token | TR / EN |
|---|---|---|---|---|---|
| GPT-3 | r50k_base | davinci | 5.033 | 2.035 | 2,47 |
| GPT-4 | cl100k_base | gpt-4, gpt-3.5-turbo | 3.984 | 2.016 | 1,98 |
| GPT-4o / GPT-5 | o200k_base | gpt-4o, gpt-4.1, gpt-5, o3 | 2.990 | 2.017 | 1,48 |
Kaynak: kendi ölçümümüz (UDHR TR/EN); model eşlemesi tiktoken model.py dosyasından, Eylül 2026.
Ölçüm aracımızın doğru saydığını iki yayımlanmış referansla sınadık. OpenAI, GPT-4o duyurusunda (Mayıs 2024) bir Türkçe örnek cümlenin yeni tokenizer'la 39 yerine 30 token tuttuğunu yazmıştı. Aynı cümleyi bizim aracımız da cl100k_base'de 39, o200k_base'de 30 saydı. Petrov ve ark.'nın FLORES-200 verisinde 2.000 cümle üzerinden Türkçe/İngilizce oranı cl100k_base için 1,915, r50k_base için 2,431; bizim beyanname sonuçlarımız 1,976 ve 2,473. Fark cl100k_base'de %3,2, r50k_base'de %1,7. Petrov verisinde o200k_base bulunmuyor; 1,48 değeri beyanname üzerindeki kendi ölçümümüz, farklı derlemlerde o200k_base oranı farklı çıkabilir.
Model ile tokenizer arasındaki eşleme kütüphanenin Eylül 2026 itibarıyla yaptığı eşlemedir. OpenAI'ın sonraki her modelde aynı tokenizer'ı kullanacağının bir garantisi yok. Eski kodlamalar, önceki modellere bağlı araçlarda ve veri hatlarında hâlâ karşınıza çıkabilir; bu yüzden hangi modelle çalıştığınızı bilmek, Türkçe token hesabının ilk adımı.
Türkçe karakterleri silmek token kazandırır mı?
Yeni tokenizer'da kazandırmıyor. Türkçe karakterleri ASCII'ye çevirmek (görünürlük → gorunurluk) o200k_base'de token sayısını azaltmıyor, artırıyor: beyannamede %4,7, blog paragraflarımızda %6,1. Aynı işlem eski kuşakta tasarruf sağlıyordu; beyannamede cl100k_base'de %7,0, r50k_base'de %16,2 daha az token çıktı. Yeni tokenizer doğru yazılmış Türkçeyi daha iyi tanıyor.
| ASCII'ye katlamanın etkisi | o200k_base | cl100k_base | r50k_base |
|---|---|---|---|
| Beyanname (1.364 kelime) | +%4,7 (artış) | −%7,0 (azalma) | −%16,2 (azalma) |
| Blogumuzdaki 20 answer-first paragraf | +%6,1 (artış) | −%8,0 (azalma) | −%20,0 (azalma) |
| 50 GEO teriminin toplamı | 135 → 146 | 192 → 172 | 248 → 188 |
Kaynak: kendi ölçümümüz, Eylül 2026.
Sonuç ilk bakışta şaşırtıcı ama mekanizması basit. o200k_base sözlüğü doğru yazılmış Türkçe kelimeleri bütün ya da büyük parçalar hâlinde öğrenmiş. " kullanıcı" ve " ürün" tek token; ASCII sürümleri " kullan·ici" ve " ur·un" ikişer token. " karşılaştırma" üç parça (karşı·laştır·ma), " karsilastirma" beş parça. Diyakritiksiz yazım, sözlüğün tanıdığı diziyi bozup onu daha az tanıdık parçalara zorluyor.
Elli terimin 15'i ASCII'ye çevrildiğinde o200k_base'de uzuyor; yalnız 5'i kısalıyor (atıf, sıralama, alıntı, tıklama, yapay zeka asistanı). cl100k_base'de tablo tersine döner: 16 terim kısalır, hiçbiri uzamaz.
Pratik sonuç açık: eski tokenizer'lar döneminde mantıklı görünen "Türkçe karakter kullanmayalım, token tasarrufu olur" kısayolu, güncel OpenAI kuşağında ters tepiyor. Eski kuşakta sağladığı tasarrufun bedeli de okunabilirlikti. Gemini ve Claude için aynı testi yapmadığımızı da not edelim; bu modellerde sonucun yönü bilinmiyor.
"Görünürlük" 3 token, "visibility" 1: GEO terimleri nasıl bölünüyor?
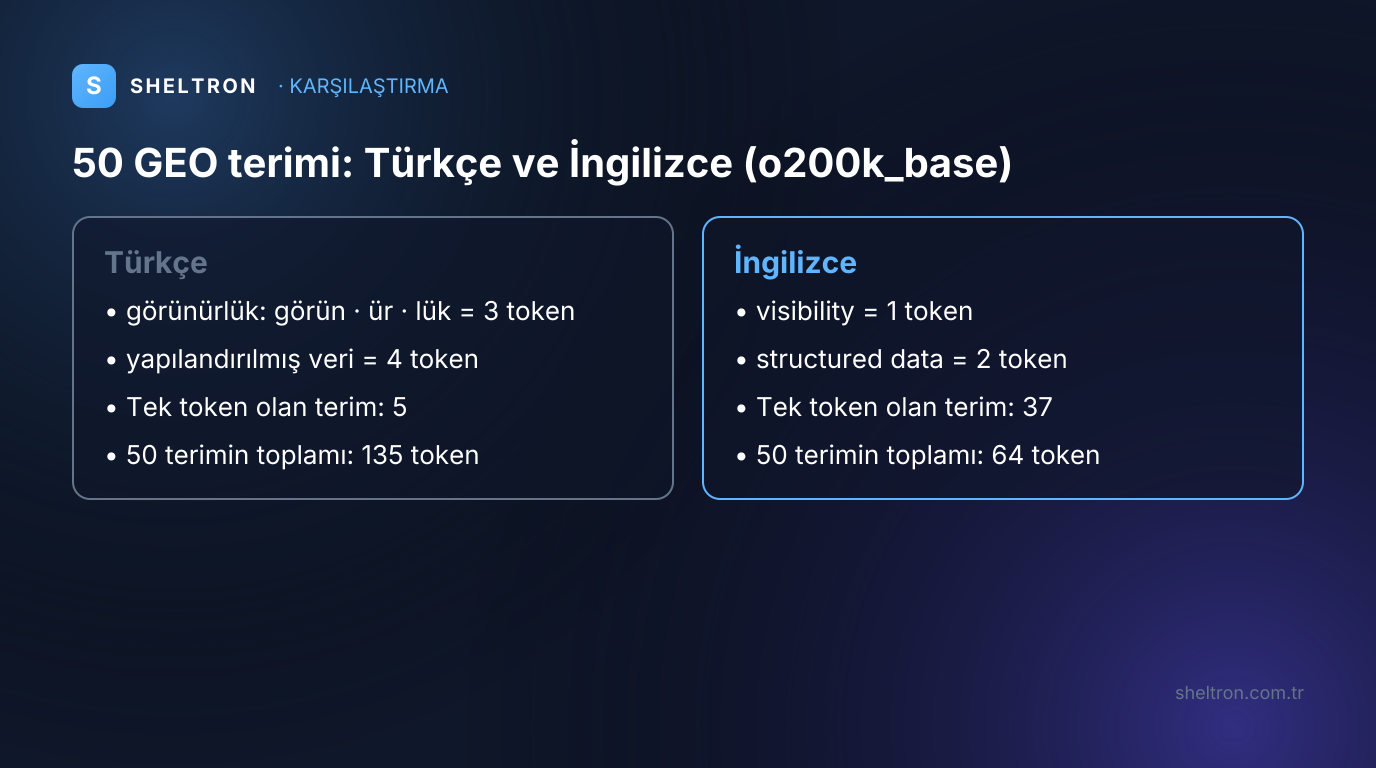
Elle seçtiğimiz 50 GEO teriminden Türkçede yalnız 5'i (kaynak, marka, kullanıcı, ürün, hizmet) o200k_base'de tek token; İngilizce karşılıklarında bu sayı 37. Elli terimin toplamı Türkçede 135, İngilizcede 64 token. Ekler eklendikçe fark büyüyor: "görünürlüğünüzü" o200k_base'de 4, cl100k_base'de 9 token tutuyor.
Terimleri cümle içindeki biçimleriyle, başlarında bir boşlukla saydık; akan metinde tokenizer kelimeyi önündeki boşlukla birlikte kodlar.
| Terim | o200k_base parçaları | o200k | ASCII (o200k) | İngilizce karşılık (o200k) | cl100k |
|---|---|---|---|---|---|
| görünürlük | görün · ür · lük | 3 | 4 | visibility: 1 | 5 |
| görünürlüğünüzü | görün · ürlüğ · ünüz · ü | 4 | 6 | — | 9 |
| yapılandırılmış veri | yapı · landır · ılmış · veri | 4 | 5 | structured data: 2 | 8 |
| karşılaştırma | karşı · laştır · ma | 3 | 5 | comparison: 1 | 6 |
| içerik | içer · ik | 2 | 3 | content: 1 | 3 |
| atıf | at · ı · f | 3 | 2 | citation: 1 | 3 |
| müşteri | müş · teri | 2 | 2 | customer: 1 | 4 |
| sıkça sorulan sorular | sık · ça · sor · ulan · sor · ular | 6 | 6 | frequently asked questions: 3 | 7 |
Kaynak: kendi ölçümümüz, 50 terim ve 13 ekli biçim, Eylül 2026.
Ek zincirleri farkı açıkça gösteriyor. o200k_base'de "marka" 1, "markanız" 2, "markanızın" 3, "markalarınızın" 4 token. "İçerik" 2 token iken "içeriklerinizin" 4 token. "optimizasyonlarımızdan" kelimesi yeni tokenizer'da 4, eski tokenizer'da 8 parçaya bölünüyor. İngilizcede aynı anlam çoğunlukla ayrı ve sık kullanılan kelimelerle kurulduğu için her kelime genellikle tek token kalıyor.
GEO açısından bunun iki sonucu var. Birincisi, bir kavramın kök hâli ile ekli hâlleri tokenizer'da farklı parça dizilerine dönüşüyor. Bunu ortadan kaldıramazsınız; ama marka ve ürün adlarını metin boyunca tek bir yazımla kullanmak, en azından yazım varyantlarından doğan dağınıklığı önler. İkincisi, terim yoğun bir tanım paragrafı Türkçede İngilizcesinden belirgin biçimde daha fazla token tutar. Sık kullanılan kavramların Türkçe tanımlarını GEO terimleri sözlüğünde topladık.
Answer-first paragraf Türkçede kaç token tutar?
40-60 kelimelik bir Türkçe answer-first paragraf o200k_base'de medyan 95 token tutuyor; Sheltron blogundaki 46 paragrafta aralık 78 ile 155 token arasında. GPT-4 kuşağının cl100k_base tokenizer'ında aynı paragrafların medyanı 129 token. Pratik kural: Türkçe paragrafı kelimeyle yazın, token'la bütçeleyin; bir kelime yaklaşık 2,2 token eder.
| Ölçü (blog paragraflarımız, yalnız Türkçe) | o200k_base | cl100k_base | r50k_base |
|---|---|---|---|
| Kelime başına token (161 paragraf) | 2,17 | 2,92 | 3,70 |
| 40-60 kelimelik paragraf: medyan token (46 paragraf) | 95 | 129 | 165 |
| Cümle başına token (392 cümle, ortalama 14,6 kelime) | 31,7 | 42,7 | 54,0 |
| Token başına karakter (20 answer-first paragraf) | 3,39 | 2,52 | 1,96 |
Kaynak: kendi ölçümümüz, 4–31 Ağustos 2026 arasında yayımlanan 20 yazı, Eylül 2026.
Answer-first yapı, her bölümün ilk paragrafının soruya tek başına cevap vermesini ister. Türkçede bu paragrafın token karşılığını bilmek, paragrafın bir yanıt motorunun ya da RAG hattının bağlamında ne kadar yer kaplayacağını tahmin etmeyi kolaylaştırır. Aynı bilgiyi İngilizce yazmak beyannamede %28 daha fazla kelime gerektirdi; ancak token hesabında Türkçe yine daha pahalı kaldı.
Sheltron'un 9 Ağustos 2026 tarihli GEO playbook'u, atıf alan pasajların 134-167 kelimelik, benzersiz ve veri içeren metinler olduğunu gözlemliyor. Türkçe o200k_base oranıyla bu uzunluk yaklaşık 290-365 token eder. Aynı playbook uzunluğun tek başına performansı öngörmediğini, belirleyici olanın pasaj düzeyindeki özellikler olduğunu da not ediyor. Hangi pasaj özelliklerinin gerçekten fark yarattığını GEO A/B testi yazımızda tartıştık. Kısacası token bütçesi pasajı yönetmenin bir aracıdır, atıf garantisi değildir.
Şeffaflık için bir yan bulguyu da paylaşalım: kendi 20 yazımızın ilk answer-first paragraflarının medyanı 38 kelime ve yalnız 6'sı 40-60 kelime bandında. Yani kendi standardımızın altında yazıyoruz. Bu paragrafları 40-60 kelime bandına taşımak token açısından ucuz: her ek kelime o200k_base'de ortalama 2,2 token getiriyor.
800 token'lık bir parça kaç Türkçe kelime taşır?
OpenAI'ın dosya arama (vector store) varsayılanı 800 token'lık parça ve 400 token örtüşmedir. Beyannamedeki o200k_base oranıyla bu parça yaklaşık 365 Türkçe ya da 693 İngilizce kelime taşır. Aynı büyüklükteki parça, Türkçe bir sayfanın İngilizce sürümüne göre kabaca yarısı kadar metni kapsar.
OpenAI'ın Retrieval belgelerine göre parça boyutu 100 ile 4.096 token arasında ayarlanabiliyor. Varsayılan değerlerle ve kendi kelime başına token oranlarımızla hesap şöyle:
| Parça boyutu | Türkçe (o200k_base) | İngilizce (o200k_base) | Türkçe (cl100k_base) | İngilizce (cl100k_base) |
|---|---|---|---|---|
| 512 token | 234 kelime | 443 kelime | 175 kelime | 444 kelime |
| 800 token (OpenAI varsayılanı) | 365 kelime | 693 kelime | 274 kelime | 693 kelime |
Kaynak: kendi hesabımız (UDHR kelime başına token oranı) ve OpenAI API Docs, Eylül 2026.
ChatGPT, Perplexity ya da Google'ın AI yüzeylerinin web sayfalarını hangi boyutta parçaladığı kamuya açık değil; bu değerler bilinmiyor. Yine de mantıksal sonuç şudur: bir parçanın içine sığan Türkçe metin, İngilizcenin yaklaşık yarısıdır. Bir H2 bölümünü 300-350 kelimeyi aşmayan, kendi başına anlamlı bir pasaj olarak yazmak, o200k_base oranıyla bölümü 800 token'lık tek bir parçanın içinde tutar. Bu bir çıkarımdır, atıf üzerindeki etkisini ölçmedik.
Modellerin sayfayı nasıl parça parça okuduğunu LLM'lerin sayfanın neresinden alıntı yaptığını anlattığımız yazıda, kendi Türkçe içeriğiniz üzerine bir RAG hattı kurmanın mimari seçeneklerini de RAG ve fine-tune karşılaştırmasında ele aldık. Bölümlerin kendi başına anlamlı olması, pillar-cluster mimarisinde her yazının tek bir alt soruya cevap vermesiyle aynı mantığa dayanıyor.
Çok dilli yayın yapan markalar için hesap bir adım daha ileri gider. Aynı sayfanın Türkçe ve İngilizce sürümleri eşit sayıda parçaya bölünmez; Türkçe sürüm daha fazla parçaya dağılır. Çok dilli GEO yazımızda ihracatçı markaların yabancı dilde görünürlüğünü bu açıdan da değerlendirdik.
Gemini ve Claude'da Türkçe kaç token tutuyor?
Bilinmiyor. Bu çalışmada Gemini ve Claude tokenizer'larını ölçmedik, çünkü ikisi de açık kaynak değil. Google, Gemini için yalnız genel bir kural veriyor: bir token yaklaşık 4 karaktere, 100 token 60-80 İngilizce kelimeye denk. Anthropic ise Claude 4.7 ve sonrası modellerin aynı metin için önceki Claude modellerine göre yaklaşık %30 daha fazla token ürettiğini belirtiyor.
İki bilginin de sınırı var. Google'ın kuralı İngilizce odaklı ve Türkçe için ayrı bir oran vermiyor. OpenAI tokenizer'larında Türkçe bir token ortalama 3,44 (o200k_base) ile 2,58 (cl100k_base) karakter taşıyor; "4 karakter" kuralı Türkçeye olduğu gibi uygulanırsa OpenAI modelleri için token sayısı olduğundan az tahmin edilir. Gemini'nin kendi tokenizer'ında durumun ne olduğunu ölçmediğimiz için bu yalnız kuralın dile bağlı olduğunu gösteren bir çıkarım.
Anthropic'in token sayma belgesi %30 artışın içeriğe ve iş yüküne göre değiştiğini söylüyor, dil ayrımı yapmıyor. Bu rakamdan Claude için bir Türkçe oranı türetmek doğru olmaz. Claude modellerinin Türkçe arama davranışını Opus 4.7 ve Sonnet 4.6 karşılaştırmamızda ayrıca inceledik.
Açık modeller için tek bir referans aralığı verebiliriz. Bayram ve ark. (2025) Türkçe TR-MMLU veri setinde (198.193 kelime) dört tokenizer'ın ürettiği token sayısını yayımladı. Kelimeye bölündüğünde (bizim hesabımız) aya-expanse için 2,19, llama-3.1 için 2,46, gemma-2 için 2,51, Qwen2.5 için 2,83 token/kelime çıkıyor. Veri seti farklı olduğu için bu değerler bizim ölçümümüzle doğrudan kıyaslanamaz; yalnız açık modellerin de benzer bir aralıkta olduğunu gösterir. Aynı çalışma, Türkçe kelimelerle örtüşen token oranının model başarısıyla güçlü biçimde ilişkili olduğunu (r=0,90) raporluyor.
Türkçeye özel araştırma da sürüyor. Nisan 2026'da yayımlanan HeceTokenizer çalışması, heceye dayalı bir tokenizer kullanan 1,5 milyon parametrelik küçük bir modelin, Türkçe pasaj getirme testinde (TQuAD) morfolojiye dayalı ve 200 kat büyük bir modelin raporlanan sonucunu geçtiğini bildiriyor (%50,3'e karşı %46,92 Recall@5).
Kendi Gemini ya da Claude değerinizi öğrenmenin güvenilir yolu, metninizi bu sağlayıcıların token sayma araçlarıyla saymaktır. Anthropic'in sayım uç noktası ücretsiz, ancak dakika başına istek sınırına tabi ve sonucu bir tahmin olarak veriyor.
Kendi içeriğinizin token sayısını nasıl ölçersiniz?
Türkçe bir sayfanın token profilini dört adımda çıkarabilirsiniz: metni düz yazıya çevirin, açık kaynak tiktoken ile o200k_base'de sayın, paragraf başına kelime ve token oranını hesaplayın, sonra pasajların AI yanıtlarında kullanılıp kullanılmadığını ayrıca test edin. Token sayısı tek başına atıfı belirlemez; yalnız pasajın ne kadar yer tuttuğunu gösterir.
- Metni çıkarın. Sayfanın gövdesini menü, altbilgi ve kod blokları olmadan düz metin olarak alın; her H2'nin ilk paragrafını ayrı işaretleyin.
- Sayın. Python'da tiktoken, JavaScript'te js-tiktoken ile o200k_base kodlamasını kullanın. Claude ve Gemini için sağlayıcıların kendi sayım araçlarını kullanın; OpenAI oranını bu modellere taşımayın.
- Oranlayın. Paragraf başına token ve kelime başına token hesaplayın. o200k_base'de Türkçe için 2,2 civarı olağan; bunun belirgin biçimde üstündeki paragraflar genellikle yoğun terim, kısaltma ya da uzun ek zinciri taşır. Bölüm uzunluğunu 800 token'lık bir parçayla karşılaştırın.
- Test edin. Yapısal kontrol için Sheltron'un ücretsiz İçerik Denetimi aracı başlık hiyerarşisini, şemayı ve AI yanıt motorlarına uyumu 0-100 arası bir skorla değerlendiriyor. Markanızın gerçekten görünüp görünmediğini ise AI Görünürlük Spot-Check ile sektörel sorgularda sınayın.
Ölçümü tek seferlik yapmak yetmez. Tokenizer'lar model sürümleriyle değişiyor; Anthropic'in Claude 4.7 ile tokenizer'ını değiştirmesi bunun bir örneği. Bu yazıdaki rakamlar Eylül 2026 itibarıyla geçerli. Bu tarihten sonra yeni bir tokenizer yayımlanırsa aynı dört adımı yeni kodlamayla tekrarlamak gerekir. Türkçe yanıtlarda hangi kaynakların öne çıktığını izlemek için Türkçe sorgularda LLM'lerin gösterdiği kaynakları analiz ettiğimiz yazı iyi bir başlangıç noktası.
Türkçe token verisi içerik yazımında neyi değiştirir?
Dört pratik kural çıkıyor: Türkçe karakterleri koruyun, çünkü yeni tokenizer'da silmek token artırıyor; answer-first paragrafı 40-60 kelimede tutun, bu yaklaşık 95 token eder; H2 bölümlerini 300-350 kelimelik bağımsız pasajlar olarak yazın; token hesabını her model için ayrı yapın ve bilinmeyeni bilinmiyor diye not edin.
Bu kuralların hiçbiri "daha kısa yazın" anlamına gelmiyor. Türkçe, aynı içeriği daha az kelimeyle ama daha fazla token'la anlatan bir dil; bu, dilin bir kusuru değil, yaygın tokenizer'ların eğitildiği verinin bir sonucu. İçerik ekibinin yapabileceği şey, bu maliyeti bilerek pasaj tasarlamak: her bölümü tek bir soruya odaklamak, tanımları kısa tutmak ve veriyi pasajın içine yerleştirmek. Türkçe içerik yapısı üzerine eğitim arayanlar için GEO Akademi, dil ve tokenizasyon araştırmalarını GEO bağlamında izlemek isteyenler için The GEO Authority iyi kaynaklar.
Türkçe içeriğinizin AI yanıtlarında nasıl temsil edildiğini düzenli izlemek istiyorsanız Sheltron'un AiSEO platformu bu iş için tasarlandı. Başlangıç noktası olarak hızlı değerlendirme formunu doldurun; sitenizin ChatGPT ve Gemini'deki mevcut görünümünü test edelim, ardından token bütçesini hangi sayfalarda elden geçirmeniz gerektiğini birlikte belirleyelim.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Türkçe Token Sayısı: Aynı Metin Türkçede 1,48 Kat Token Tutuyor, GEO İçin Ne Anlama Geliyor?
- TL;DR
- Aynı içerik o200k_base tokenizer'ında (GPT-4o/GPT-5 kuşağı) Türkçede 2.990, İngilizcede 2.017 token tutuyor: 1,48 kat. Bu oran GPT-3 kuşağında 2,47, GPT-4 kuşağında 1,98 idi. Türkçe karakterleri ASCII'ye çevirmek yeni tokenizer'da token sayısını %4,7 artırıyor. 40-60 kelimelik Türkçe paragraf medyan 95 token; 800 token'lık parça yaklaşık 365 Türkçe kelime taşıyor. Gemini ve Claude ölçülmedi.
- Ana Çıkarımlar (7)
- İnsan Hakları Evrensel Beyannamesi'nin Türkçe metni o200k_base'de 2.990, İngilizcesi 2.017 token tutuyor; aynı içerik Türkçede 1,48 kat token harcıyor.
- Türkçe/İngilizce token oranı tokenizer kuşağıyla düştü: GPT-3 kuşağında 2,47, GPT-4 kuşağında 1,98, GPT-4o/GPT-5 kuşağında 1,48.
- Türkçe karakterleri ASCII'ye çevirmek o200k_base'de token sayısını azaltmıyor, artırıyor: beyannamede %4,7, Sheltron paragraflarında %6,1.
- Elle seçilen 50 GEO teriminin Türkçede yalnız 5'i tek token; İngilizce karşılıklarında bu sayı 37. Toplam: 135'e karşı 64 token.
- 40-60 kelimelik bir Türkçe answer-first paragraf o200k_base'de medyan 95 token tutuyor (46 paragraf, 78-155 aralığı).
- OpenAI'ın varsayılan 800 token'lık parçası yaklaşık 365 Türkçe, 693 İngilizce kelime taşıyor.
- Gemini ve Claude tokenizer'larında Türkçe token sayısı ölçülmedi, bilinmiyor; Anthropic'in %30 artış bilgisi dil ayırmıyor.
- Kaynaklı Veriler
- 1,48 kat — İnsan Hakları Evrensel Beyannamesi'nin Türkçe metni o200k_base'de İngilizcesinden 1,48 kat token tutuyor (2.990'a karşı 2.017) (Sheltron ölçümü (UDHR TR/EN, js-tiktoken 1.0.21, Eylül 2026), 2026)
- 2,47 → 1,98 → 1,48 — aynı Türkçe metnin İngilizceye göre token oranı GPT-3, GPT-4 ve GPT-4o/GPT-5 kuşağı tokenizer'larında (Sheltron ölçümü (UDHR TR/EN, Eylül 2026), 2026)
- %25 — o200k_base, Türkçe beyannamenin token sayısını cl100k_base'e göre %25 azaltıyor (3.984'ten 2.990'a); İngilizce metin değişmiyor (Sheltron ölçümü (UDHR TR/EN, Eylül 2026), 2026)
- 2,19 token/kelime — o200k_base'de Türkçe beyanname metninde kelime başına token; İngilizcede 1,15 (Sheltron ölçümü (UDHR TR/EN, Eylül 2026), 2026)
- %4,7 — Türkçe karakterleri ASCII'ye çevirmek o200k_base'de beyannamenin token sayısını azaltmıyor, %4,7 artırıyor (Sheltron ölçümü (UDHR TR, Eylül 2026), 2026)
- 37 / 50 — elle seçilen 50 GEO teriminin İngilizce karşılıklarından 37'si o200k_base'de tek token; Türkçelerinde yalnız 5'i (Sheltron ölçümü (50 GEO terimi, Eylül 2026), 2026)
- 95 token — 40-60 kelimelik Türkçe answer-first paragrafın o200k_base'deki medyan token sayısı (46 paragraf, 78-155 aralığı) (Sheltron ölçümü (sheltron.com.tr blogu, 20 yazı, Eylül 2026), 2026)
- 365 kelime — 800 token'lık bir parçaya o200k_base oranıyla sığan Türkçe kelime; İngilizcede 693 (Sheltron hesabı (UDHR oranı) ve OpenAI API Docs, Retrieval, 2026)
- 800 token — OpenAI vector store dosya aramasında varsayılan parça boyutu; varsayılan örtüşme 400 token (OpenAI API Docs, Retrieval, 2026)
- 39'dan 30'a — OpenAI'ın GPT-4o duyurusundaki Türkçe örnek cümlenin token sayısı yeni tokenizer'la 39'dan 30'a iniyor (OpenAI, Hello GPT-4o, 2024)
- 1,915 — FLORES-200'ün 2.000 cümlesinde cl100k_base için Türkçe/İngilizce token oranı (r50k_base: 2,431) (Petrov ve ark., Tokenization Fairness (NeurIPS 2023), 2023)
- 15 kata kadar — aynı metnin farklı dillerdeki token uzunluğu farkı bazı dil çiftlerinde 15 kata çıkabiliyor (Petrov ve ark., Language Model Tokenizers Introduce Unfairness Between Languages (NeurIPS 2023), 2023)
- %30 — Claude 4.7 ve sonrası modellerin yeni tokenizer'ı aynı metin için önceki modellere göre yaklaşık %30 daha fazla token üretiyor (dil ayrımı yok) (Anthropic, Claude Docs — Token counting, 2026)
- 4 karakter — Google'a göre Gemini modellerinde bir token yaklaşık 4 karaktere, 100 token 60-80 İngilizce kelimeye denk (Google AI for Developers — Understand and count tokens, 2026)
- 2,83 token/kelime — Qwen2.5 tokenizer'ı TR-MMLU'da (198.193 kelime) kelime başına token; aya-expanse 2,19 (kaynaktaki ham sayılardan hesap) (Bayram ve ark., Tokenization Standards for Linguistic Integrity: Turkish as a Benchmark (arXiv 2025), 2025)
- Arama Niyetleri
- türkçe token sayısı
- türkçe metin kaç token
- türkçe tokenizer verimliliği
- diyakritiksiz türkçe token
- llm türkçe maliyet farkı
- türkçe chunk uzunluğu
- o200k_base türkçe
- türkçe kelime kaç token
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz