
Türk Siteleri Yapay Zekâ Botlarını Engelliyor mu? 425 Popüler Sitede robots.txt ve Sunucu Yanıtı Taraması
Sheltron, Türkiye'nin en çok ziyaret edilen 425 sitesinin robots.txt dosyalarını ve GPTBot ile ClaudeBot kimliklerine verdikleri sunucu yanıtını Eylül 2026'da taradı: hangi botlar engelleniyor, beyan ile uygulama örtüşüyor mu, Cloudflare'in payı ne?
💡Kısa Özet
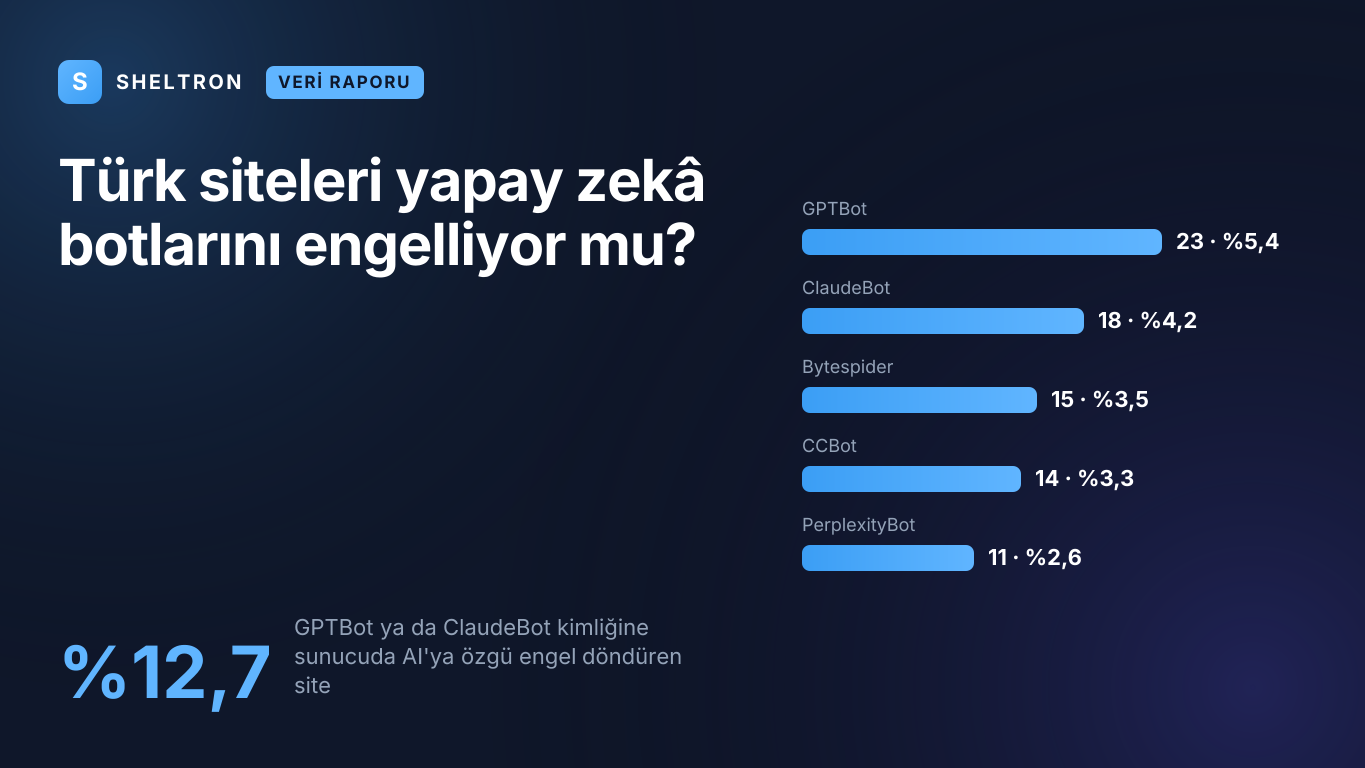
Eylül 2026 taramasında Türkiye'nin en popüler 425 sitesinin %9,2'si (39) robots.txt'te en az bir AI eğitim botunu adıyla tamamen engelliyor, AI arama botlarını kapatanlar %3,1. Test edilebilen 401 sitenin %12,7'si GPTBot ya da ClaudeBot kimliğine AI'ya özgü sunucu engeli döndürüyor; bunların 45'inin robots.txt'i GPTBot'u tamamen engellemiyor. Cloudflare arkasında oran %22,7, dışında %4,9.
Ana Çıkarımlar
- •Eylül 2026'da Türkiye'nin en popüler 425 sitesinin 39'u (%9,2) robots.txt'te en az bir AI eğitim botunu adıyla tamamen engelliyor; AI arama botlarını kapatanların oranı %3,1 (13 site).
- •En çok engellenen bot GPTBot (23 site, %5,4); ardından ClaudeBot (18), Bytespider (15), CCBot ve meta-externalagent (14'er) geliyor. Hiçbir site User-agent: * ile tüm siteyi kapatmıyor.
- •Eğitim botunu engelleyen 39 sitenin 27'si (%69) OAI-SearchBot, Claude-SearchBot ve PerplexityBot'un hiçbirini tamamen engellemiyor; arama botları açık kalıyor (27 sitenin 18'inde varsayılan olarak, yalnızca 9'u bir arama botunu adıyla anıyor).
- •Test edilebilen 401 sitenin 51'i (%12,7) GPTBot ya da ClaudeBot kimliğine AI'ya özgü 403 ya da challenge döndürüyor; bunların 45'inin (%88) robots.txt'i GPTBot'u tamamen engellemiyor.
- •Cloudflare arkasındaki test edilebilir sitelerde AI'ya özgü sunucu engeli oranı %22,7, Cloudflare dışında %4,9; AI'ya özgü engellerin 51'de 40'ı Cloudflare arkasında.
- •Yeni beyan araçları yaygın değil: Content-Signal satırı 15 sitede (%3,5), Cloudflare Managed robots.txt bloğu 2 sitede, Bot Preference Sync bloğu hiçbir sitede yok.
- •Haber sitelerinin %16,7'si eğitim botunu robots.txt'te kapatıyor; e-ticarette robots.txt engeli %8,7'de kalırken AI'ya özgü sunucu engeli %15,8'e çıkıyor.
Sheltron'un Eylül 2026 taramasına göre Türkiye'de en çok ziyaret edilen 425 sitenin yalnızca 39'u (%9,2) robots.txt dosyasında en az bir yapay zekâ eğitim botunu adıyla tamamen engelliyor. ChatGPT, Claude ve Perplexity'nin arama botlarını kapatan sitelerin oranı %3,1. Sunucu katmanında ise tablo değişiyor: test edilebilen 401 sitenin %12,7'si GPTBot ya da ClaudeBot kimliğiyle gelen isteğe yapay zekâya özgü bir 403 ya da doğrulama sayfası döndürüyor. Bu 51 sitenin 45'inde robots.txt GPTBot'u tamamen engellemiyor.
Kısacası popüler Türk siteleri yapay zekâ botlarını beyan düzeyinde nadiren engelliyor; sunucu düzeyinde ise daha sık ve çoğu zaman robots.txt'e yansıtmadan yapay zekâ kimliklerine engel döndürüyor. Örneklem, Chrome UX Report'un Ağustos 2026 Türkiye listesindeki ilk 1.000 siteden süzüldü. Tarama, Cloudflare'in 15 Eylül 2026'da yapay zekâ tarayıcı kontrollerini yenilemesinden sonra yapıldı. Tek bir zaman kesiti olduğu için bu değişikliğin etkisini değil, Eylül 2026 sonundaki durumu gösteriyor.
Türk siteleri yapay zekâ botlarını engelliyor mu?
Beyan katmanında çoğunlukla hayır, sunucu katmanında daha sık evet. Popüler 425 sitenin %9,2'si robots.txt'te en az bir yapay zekâ eğitim botunu adıyla tamamen kapatıyor, AI arama botlarını kapatanların oranı %3,1. Buna karşılık test edilebilen 401 sitenin %12,7'si GPTBot ya da ClaudeBot kimliğine sunucuda yapay zekâya özgü bir engel döndürüyor.
Aşağıdaki tablo iki katmanı yan yana gösteriyor. robots.txt, sitenin tarayıcılara ne söylediğidir; sunucu yanıtı ise aynı tarayıcı kapıya geldiğinde gerçekte ne olduğudur.
| Ölçü (Eylül 2026) | Site | Oran |
|---|---|---|
| Geçerli bir robots.txt dosyası var | 342 / 425 | %80,5 |
| En az bir AI botunu robots.txt'te adıyla anıyor | 85 / 425 | %20,0 |
| En az bir AI eğitim botunu adıyla tamamen engelliyor | 39 / 425 | %9,2 |
| En az bir AI arama botunu tamamen engelliyor | 13 / 425 | %3,1 |
User-agent: * ile tüm siteyi kapatıyor |
0 / 425 | %0 |
| Content-Signal satırı kullanıyor | 15 / 425 | %3,5 |
| GPTBot ya da ClaudeBot kimliğine AI'ya özgü sunucu engeli döndürüyor | 51 / 401 | %12,7 |
Kaynak: Sheltron taraması, Eylül 2026. N = 425; sunucu testi için N = 401.
Tablodaki sıfır da bir bulgu: hiçbir site User-agent: * ile tüm siteyi kapatmıyor. Yani popüler Türk siteleri tarayıcılara toptan kapı kapatmıyor, engelledikleri botları tek tek seçiyor. robots.txt dosyası olmayan ya da isteğe HTML sayfa döndüren 70 site (%16,5) ve dosyasına ulaşılamayan 13 site (%3,1) var. RFC 9309, 4xx dönen dosyada tarayıcının her yere erişebileceğini, sunucu ya da ağ hatası nedeniyle ulaşılamayan dosyada ise tam engel varsaymasını öngörüyor. Bu raporda ulaşılamayan dosyalar engel sayılmadı.
Yerli ve global ayrımı sonucu pek değiştirmiyor. Ağırlıkla Türkiye'de faaliyet gösteren 392 sitenin 34'ü (%8,7) bir eğitim botunu adıyla kapatıyor; uluslararası markaların 33 Türkiye sitesinde bu sayı 5.
Küresel ölçümlerle doğrudan karşılaştırma yapmak zor, çünkü tanımlar farklı. Cloudflare, 15 Eylül 2026 tarihli duyurusunda kendi müşterilerinin %17'sinin eğitimi engellemek için bir mekanizma açtığını, arama botlarını engelleyenlerin ise %1'in altında kaldığını açıkladı. Yön aynı: eğitimi kapatan çok, aramayı kapatan az. Akademik tarafta ise Data Provenance Initiative'in Consent in Crisis çalışması, C4 veri kümesinin en kritik kaynaklarının %28'den fazlasının bir yıl içinde robots.txt ile tamamen kısıtlandığını gösteriyordu. Bu taramadaki asıl fark ise başka: Türkiye'nin popüler sitelerinde yapay zekâ botlarına karşı direnç robots.txt'ten çok CDN ve güvenlik duvarı katmanında görülüyor.
Bu ölçüm nasıl yapıldı?
Örneklem, Chrome UX Report'un Ağustos 2026 Türkiye listesinin ilk 1.000 kovasından geliyor. Yetişkin içerik, yasa dışı bahis, lisanssız yayın ve küresel platformlar ayıklandıktan sonra 425 Türkiye'ye yönelik site kaldı. robots.txt dosyaları RFC 9309 kurallarıyla okundu, ana sayfalar tarayıcı, GPTBot ve ClaudeBot kimlikleriyle ayrı ayrı istendi.
Kaynak, Chrome kullanıcılarının gerçek ziyaretlerinden türetilen CrUX Top Lists deposundaki Türkiye dosyası. Liste kova içinde sıra vermez; 1.000 site kendi aralarında sıralanamaz.
Süzme dört adımda yapıldı:
- Alan adı
.trile biten, ana sayfasılang="tr"döndüren ya da dil etiketi okunamayan siteler aday alındı: 625 alan adı. - Elle 193 alan adı elendi: yetişkin içerik (53), yasa dışı bahis ve casino aynaları (35), lisanssız film, dizi ve APK aynaları (55), anlamsız ya da geçici alan adları (10), robots.txt kararı Türkiye'de verilmeyen küresel platformlar (39) ve doğrulanamayan 1 site.
- Kalan 432 sitenin 7'si, başka bir örneklem alan adına ya da küresel bir alan adına yönlendiği için analizden çıkarıldı.
- Analiz örneklemi: N = 425 (392 yerli, 33 global). Her site elle bir sektöre atandı.
robots.txt'te 15 bot ayrı ayrı sınıflandı. Eğitim botları: GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot, Bytespider, meta-externalagent ve Amazonbot. AI arama botları: OAI-SearchBot, Claude-SearchBot ve PerplexityBot. Kullanıcı adına sayfa getiren botlar: ChatGPT-User, Claude-User ve Perplexity-User. Bingbot ayrıca izlendi. Bir botun "tamamen engelli" sayılması için hem ana sayfanın hem de sıradan bir iç sayfanın kapalı olması gerekti; yalnız bazı yolları kapatan kurallar "kısmi" sayıldı.
Sunucu testinde her ana sayfa, 2 saniye arayla önce tarayıcı, sonra GPTBot, sonra ClaudeBot kimliğiyle istendi. Tarayıcıya açılıp bot kimliklerine kapanan ya da yanıt vermeyen 72 site ikinci bir turda yeniden denendi ve bu turda yapay zekâ ile ilgisi olmayan jenerik bir kontrol botu kimliği de kullanıldı. Kontrol botu geçerken GPTBot ya da ClaudeBot sert bir engelle (401, 403, 406, 451 ya da challenge sayfası) karşılaştıysa sonuç "AI'ya özgü engel" olarak kaydedildi.
Sınırlılıklar sonucu yorumlarken belirleyici:
- Sunucu testi gerçek bot deneyimi değildir. İstekler OpenAI ya da Anthropic'in IP adreslerinden gelmedi. Doğrulanmış bot listesi kullanan bir güvenlik duvarı gerçek GPTBot'u farklı karşılayabilir ya da sahte kimliği taklitçi sayıp engelleyebilir. Ölçülen şey, "sitede yapay zekâ adlarına bağlı bir kural ya da bot yönetimi tepkisi var mı" sorusunun cevabıdır. Bu nedenle sunucu testinde tekil site adı verilmiyor.
- Tek zaman kesiti. Veri Eylül 2026'da toplandı; önce/sonra karşılaştırması yok.
- Popüler site yanlılığı. Örneklem Türkiye'nin en çok ziyaret edilen siteleridir, KOBİ sitelerine genellenemez.
Türkiye'deki AI görünürlüğünü farklı bir açıdan ölçen veri çalışmamız için Türkiye GEO Endeksi 2026 raporuna bakabilirsiniz. Kendi robots.txt dosyanızın hangi AI botuna ne söylediğini görmek için Sheltron'un ücretsiz robots.txt AI bot kontrol aracını kullanabilirsiniz. Araç yalnız beyan katmanını okur; sunucu katmanını ayrıca test etmek gerekir.
robots.txt'te en çok hangi yapay zekâ botları engelleniyor?
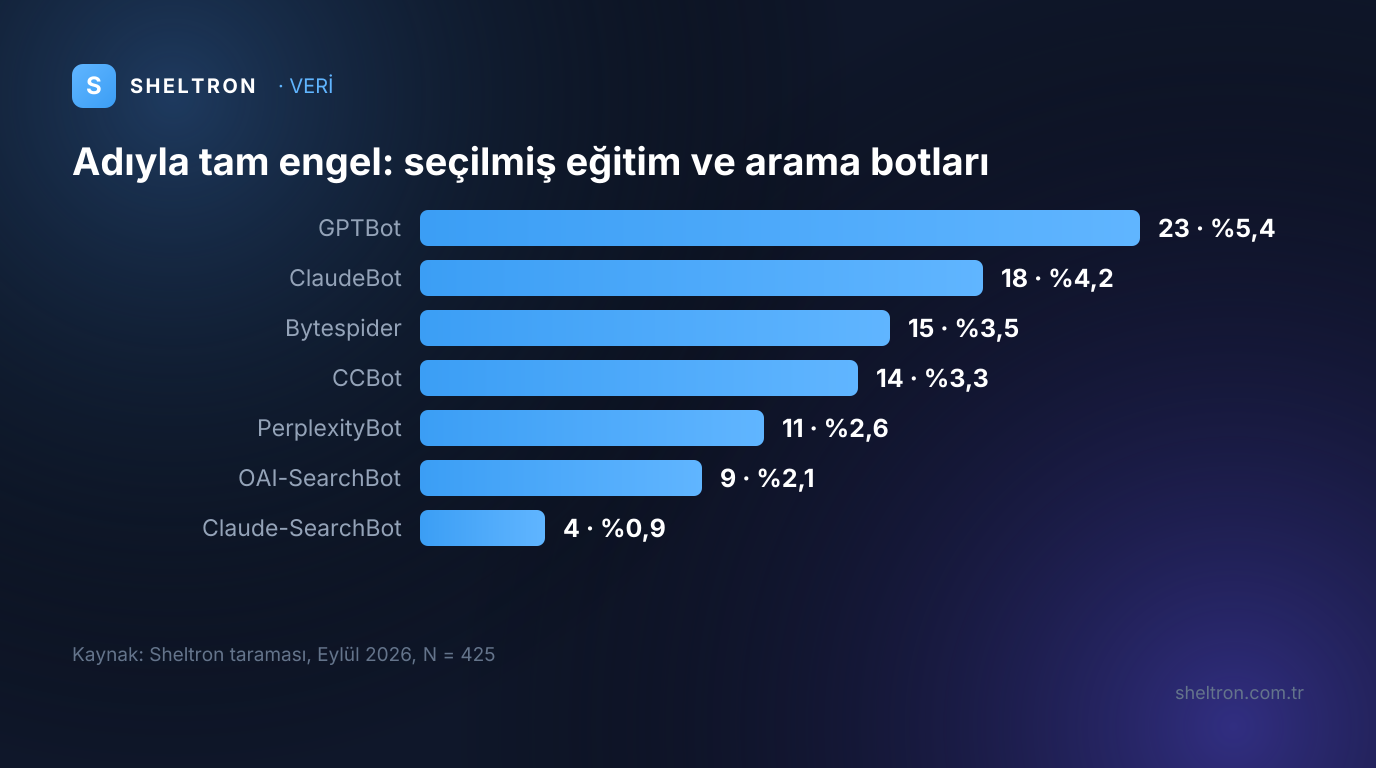
En çok engellenen bot, OpenAI'ın eğitim tarayıcısı GPTBot: 23 site (%5,4) onu adıyla tamamen kapatıyor. ClaudeBot 18, Bytespider 15, CCBot ve meta-externalagent 14'er siteyle izliyor. AI arama ve kullanıcı botları listenin sonunda yer alıyor; Claude-SearchBot'u 4, Perplexity-User'ı yalnızca 1 site engelliyor.
| Bot | Şirket | Tür | Adıyla tam engel | Oran (N = 425) | Adıyla anan site |
|---|---|---|---|---|---|
| GPTBot | OpenAI | Eğitim | 23 | %5,4 | 62 |
| ClaudeBot | Anthropic | Eğitim | 18 | %4,2 | 49 |
| Bytespider | ByteDance | Eğitim | 15 | %3,5 | 19 |
| CCBot | Common Crawl | Eğitim | 14 | %3,3 | 29 |
| meta-externalagent | Meta | Eğitim | 14 | %3,3 | 21 |
| PerplexityBot | Perplexity | Arama | 11 | %2,6 | 44 |
| Google-Extended | Eğitim (token) | 10 | %2,4 | 40 | |
| Amazonbot | Amazon | Eğitim | 10 | %2,4 | 17 |
| ChatGPT-User | OpenAI | Kullanıcı adına | 10 | %2,4 | 40 |
| OAI-SearchBot | OpenAI | Arama | 9 | %2,1 | 44 |
| Applebot-Extended | Apple | Eğitim (token) | 8 | %1,9 | 25 |
| Claude-SearchBot | Anthropic | Arama | 4 | %0,9 | 17 |
| Claude-User | Anthropic | Kullanıcı adına | 3 | %0,7 | 15 |
| Perplexity-User | Perplexity | Kullanıcı adına | 1 | %0,2 | 11 |
| Bingbot | Microsoft | Arama | 1 | %0,2 | 20 |
Kaynak: Eylül 2026 taraması, N = 425.
Bytespider'ı adıyla anan 19 sitenin 15'inin onu tamamen engellemesi de dikkat çekici: bu botun adını yazan site, neredeyse her zaman onu kapatmak için yazıyor.
Google'ın tarayıcı dokümantasyonuna göre Google-Extended ayrı bir tarayıcı değil, yalnızca robots.txt'te kullanılan bir token; sitenin Google Arama'ya dahil edilmesini etkilemiyor ve sıralama sinyali olarak kullanılmıyor. Apple da Applebot-Extended'ın sayfa taramadığını, yalnızca Applebot'un topladığı verinin eğitimde kullanılıp kullanılmayacağını belirlediğini söylüyor. Bu iki token'ı kapatan 10 ve 8 site, arama görünürlüğünü riske atmadan eğitim kullanımını reddetmiş oluyor.
Küresel bir referans olarak Cloudflare'in Temmuz 2025 analizi, en popüler 10.000 alan adının yalnızca %37'sinde robots.txt bulunduğunu ve bu dosyaların %7,8'inde GPTBot'un kısıtlandığını bildiriyordu. Bizim örneklemde robots.txt dosyası olan 342 sitenin 23'ünde (%6,7) GPTBot tamamen engelli. Cloudflare "kısıtlama", biz "tam engel" ölçtüğümüz ve örneklemler farklı olduğu için yalnızca iki rakamın benzer düzeyde olduğunu söyleyebiliriz; "Türkiye daha az engelliyor" sonucu bu veriden çıkmaz.
Siteler eğitim botunu arama botundan ayırıyor mu?
Çoğunlukla evet, ama genellikle pasif biçimde. Eğitim botunu kapatan 39 sitenin 27'si (%69) OAI-SearchBot, Claude-SearchBot ve PerplexityBot'un hiçbirini tamamen engellemiyor. Bu 27 sitenin yalnızca 9'u robots.txt'te bir AI arama botunun adını anıyor; kalan 18'inde arama botları varsayılan olarak açık kalıyor. GPTBot'u engelleyen 23 sitenin 14'ü OAI-SearchBot'u tamamen engellemiyor, ama yalnızca 4'ü onu adıyla anıyor.
Bu sonuç, Cloudflare'in 15 Eylül 2026'da öne çıkardığı "aramada kal, eğitime kapan" yaklaşımıyla örtüşüyor. Şirket o tarihte tek "Block AI Bots" anahtarının ayrı arama, eğitim ve ajan kontrolleri lehine kullanımdan kaldırılacağını açıkladı ve dört ölçütü karşılayan tarayıcılar için "Accountable" adlı bir sınıf tanımladı. Cloudflare'in basın bültenine göre hem arama hem eğitim için veri toplayan karma kullanımlı tarayıcılar, doğrulanmış tarayıcı trafiğinin %36,6'sını oluşturuyor. Türkiye'de eğitim botunu engelleyen popüler sitelerin %69'u AI arama botlarını açık tutuyor, ama bu 27 sitenin yalnızca 9'u bunu açık bir kuralla yapıyor.
Öte yandan 13 site en az bir AI arama botunu tamamen engelliyor ve bunların 12'si eğitim botlarını da kapatıyor. 13 sitenin 7'si haber sitesi: Eylül 2026 taramasında Hürriyet, Milliyet, CNN Türk, NTV, NTV Spor, Posta ve Fanatik'in robots.txt dosyaları GPTBot'un yanında OAI-SearchBot'u da tamamen engelliyordu. Kalan 6 sitenin 4'ü e-ticaret, biri kamu, biri içerik sitesi. OpenAI'ın tarayıcı dokümantasyonu, OAI-SearchBot'u ChatGPT'nin arama özelliğinde siteleri bulmak ve göstermek için kullanılan bot olarak tanımlıyor. Bu botu kapatmak, eğitim verisinden çıkmaktan çok, ChatGPT'nin güncel cevaplarında kaynak gösterilme şansını azaltmak anlamına geliyor. Türkçe sorgularda hangi kaynakların öne çıktığını Türkçe sorgularda LLM'lerin gösterdiği kaynaklar yazısında, ChatGPT'de görünmemenin diğer nedenlerini de ChatGPT görünürlüğü için 7 neden yazısında ele aldık.
Kullanıcı adına sayfa getiren botlar ayrı bir durum. 12 site en az birini tamamen engelliyor, ancak OpenAI ChatGPT-User için robots.txt kurallarının uygulanmayabileceğini, Perplexity de Perplexity-User'ın robots.txt kurallarını genellikle dikkate almadığını belirtiyor. Anthropic ise destek sayfasında ClaudeBot, Claude-SearchBot ve Claude-User'ın üçünün de robots.txt'e uyduğunu söylüyor. Yani bu satırların bir kısmı pratikte bir beyandan öteye geçmiyor.
Bir botu adıyla anmak onu engellemek anlamına da gelmiyor. GPTBot'u robots.txt'te adıyla anan 62 sitenin 39'u onu tamamen engellemiyor; ya açıkça izin veriyor ya da yalnız bazı yolları kapatıyor. Sheltron'un kendi robots.txt dosyası da Googlebot ve Bingbot dahil 17 tarayıcıya ayrı gruplarla izin veriyor. Burada RFC 9309'un bir kuralı önem kazanıyor: kendi adına bir grup bulan bot User-agent: * grubunu yok sayar. Yani GPTBot için ayrı bir grup yazan site, genel gruptaki yasakların GPTBot'a uygulanmadığını hesaba katmalı.
Engelleme kararının arkasında ekonomik bir hesap var. Cloudflare Radar'ın 2025 yıl değerlendirmesi, Anthropic'in yönlendirdiği her ziyarete karşılık yaptığı tarama sayısının, yani crawl-to-refer oranının 500.000:1'e kadar çıktığını gösteriyordu. Bu oranların Türk siteleri açısından ne anlama geldiğini AI crawler ekonomisi ve crawl-to-refer oranı yazısında inceledik. AI atıf mekanizmaları üzerine İngilizce kaynaklar için The GEO Authority derlemesine de bakılabilir.
robots.txt ile sunucu aynı şeyi söylüyor mu?
Çoğu zaman hayır. GPTBot ya da ClaudeBot kimliğine yapay zekâya özgü sunucu engeli döndüren 51 sitenin 45'inde (%88) robots.txt GPTBot'u tamamen engellemiyor. Tersine, robots.txt'te GPTBot'u kapatan 22 test edilebilir sitenin 15'i aynı kimliğe ana sayfayı sorunsuz açıyor. Beyan ile uygulama çoğu sitede ayrı yönetiliyor gibi.
| robots.txt'te GPTBot | Sunucu açık | AI'ya özgü engel | Genel bot engeli | Yalnız zaman aşımı | Toplam |
|---|---|---|---|---|---|
| Tamamen engelli | 15 | 6 | 1 | 0 | 22 |
| Engelli değil (izin, kısmi, dosya yok ya da ulaşılamadı) | 317 | 45 | 11 | 6 | 379 |
| Toplam | 332 | 51 | 12 | 6 | 401 |
Kaynak: Eylül 2026 taraması. Tarayıcı isteği de başarısız olan 24 site "belirsiz" sayılıp tablo dışında bırakıldı.
AI'ya özgü engel uygulayan 51 sitenin robots.txt'lerine bakıldığında 17'si GPTBot'a açıkça izin veriyor, 28'i yalnız bazı yolları kapatıyor. Bu sitelerin robots.txt'i yapay zekâ tarayıcılarına açık görünüyor; oysa aynı kimlikle gelen istek 403 ya da challenge sayfasıyla karşılaşırken jenerik kontrol botu geçiyor. Engel "bot" kelimesine değil, yapay zekâ botlarının adlarına bağlı görünüyor. Popüler Türk sitelerinde GPTBot ya da ClaudeBot kimliğine sunucuda AI'ya özgü engel döndüren her 51 sitenin 45'i, robots.txt'te GPTBot'a kapıyı kapatmıyor.
Ters yöndeki uyumsuzluk da önemli. robots.txt'te GPTBot'u tamamen kapatan sitelerin çoğu, sunucuda bu kimliğe ana sayfayı açıyor. robots.txt bir rica protokolü olduğu için bu bir çelişki değil; ancak uymayan ya da kimliğini gizleyen tarayıcılar için bu siteler yalnızca beyana güveniyor.
12 site ise kontrol botunu da engelliyor, yani yapay zekâya değil, otomasyon gibi görünen her isteğe kapalı. 6 sitede bot isteği yalnız zaman aşımına uğradı.
İstekler sahte kimlikle gönderildiği için bu 51 sitenin gerçek GPTBot'u da engellediği kesin değildir. Kesin olan, bu sitelerde yapay zekâ adlarına tepki veren bir kural bulunduğudur. Bu kuralın kasıtlı bir karar mı, yoksa bir güvenlik ürününün varsayılan ayarı mı olduğunu dışarıdan ayırt etmek mümkün değil. WAF izin listeleri ve bot yönetimi kararlarının hangi ekipte verilmesi gerektiğini AI search altyapı kararları yazısında tartıştık.
Cloudflare bu tabloyu ne kadar belirliyor?
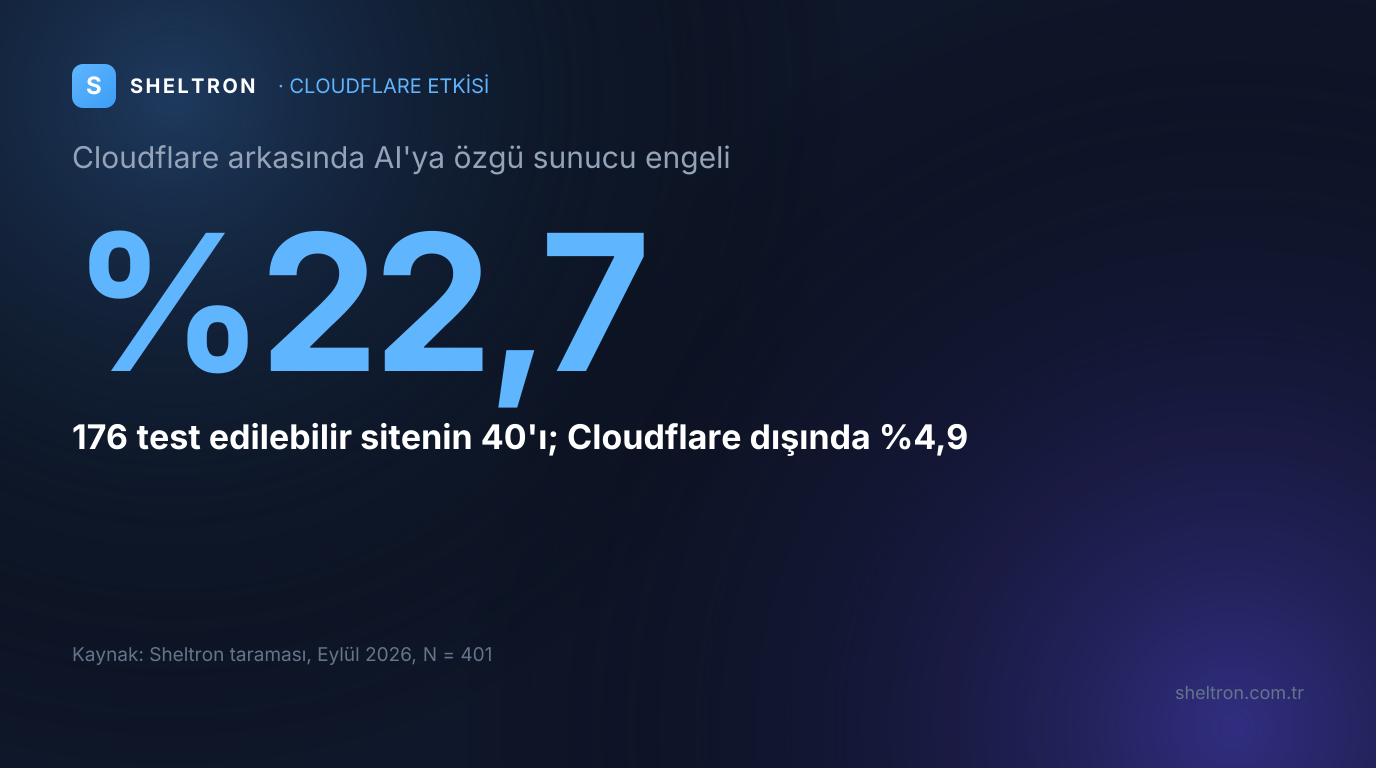
Belirgin biçimde. Örneklemdeki sitelerin 187'si (%44,0) Cloudflare arkasından sunuluyor. Cloudflare arkasındaki 176 test edilebilir sitenin %22,7'si yapay zekâya özgü sunucu engeli uyguluyor; Cloudflare dışındaki 225 sitede bu oran %4,9. AI'ya özgü engellerin 51'de 40'ı Cloudflare arkasındaki sitelerden geliyor. Yani sunucu katmanındaki engellerin dörtte üçünden fazlası tek bir CDN'de toplanıyor.
Kalan 11 engelin 5'i CloudFront, 3'ü nginx arkasında; Akamai, Imperva ve LiteSpeed arkasında birer site var. Aradaki fark, engellerin önemli bir kısmının site ekiplerinin robots.txt'e yazdığı kararlardan değil, CDN panelinde açılan bot yönetimi ayarlarından geldiğini düşündürüyor.
Buna karşın Cloudflare'in robots.txt'e doğrudan yazdığı araçlar popüler Türk sitelerinde neredeyse hiç görünmüyor:
- Managed robots.txt bloğu: 425 sitenin yalnızca 2'sinde var. Cloudflare dokümantasyonuna göre bu blok, dosyaya bir Content-Signal satırı ve GPTBot, ClaudeBot, CCBot, Google-Extended gibi sekiz eğitim botu için tam engel ekliyor. Cloudflare, Eylül 2025'te bu özelliği 3,8 milyon alan adının kullandığını açıklamıştı.
- Bot Preference Sync bloğu: Hiçbir sitede yok. Cloudflare bu sistemi 21 Ağustos 2026'da duyurdu; yeni müşterilerde varsayılan olarak açık, Managed robots.txt kullanan mevcut müşterilere ise onay istemiyle sunuluyor. Cloudflare 15 Eylül duyurusunda Managed robots.txt'in bu sistem lehine kullanımdan kaldırılacağını açıkladı.
Cloudflare'in 15 Eylül 2026 duyurusuna göre yeni alan adlarına kurulum sırasında önerilen bir ön ayar sunuluyor; reklam gelirli sitelerde bu ön ayar eğitim için Disallow AI Training, ajanlar için Block on pages with ads. Mevcut sitelerin ayarları ise yeni kontrollere kendiliğinden taşınıyor; ancak Block seçeneği artık Googlebot ve Bingbot gibi karma kullanımlı tarayıcıları da kapsıyor. Bot Preference Sync geçişi onayla sunulduğu için robots.txt dosyalarındaki bu tablo Eylül 2026'dan sonra değişebilir. Cloudflare'in ücretli tarama modelini ve Türk siteleri için seçenekleri daha önce Pay per Crawl rehberinde ele almıştık.
Content-Signal ve yeni tercih standartları kullanılıyor mu?
Henüz çok az. Content-Signal satırı 425 sitenin yalnızca 15'inde (%3,5) bulunuyor. Bunların 13'ü model eğitimine kapalı (ai-train=no), 2'si eğitime açıkça izin veriyor. 15 satırın 10'u aynı kalıbı izliyor: aramaya ve AI cevaplarında kullanıma açık, model eğitimine kapalı. Yeni beyan biçimi popüler Türk sitelerinde henüz yerleşmiş değil.
Content-Signal, Cloudflare'in Eylül 2025'te tanıttığı ve robots.txt'e eklenen bir satırdır. Üç sinyal tanımlar: search arama dizinine alınmayı, ai-input içeriğin AI cevaplarında girdi olarak kullanılmasını, ai-train ise model eğitimini kapsar. Taramada bu satırı kullanan siteler arasında Türk Telekom, Onedio, Webtekno ve idefix var. Pegasus ile Paraşüt ise ai-train=yes yazarak eğitime açıkça izin veren iki site.
Content-Signal satırı, Eylül 2026 itibarıyla Türkiye'nin en popüler 425 sitesinden yalnızca 15'inde bulunuyor. Bu düşük oranın bir nedeni, sinyalin henüz bir standart olmaması. Aynı sorunu çözmek için IETF bünyesinde kurulan AI Preferences (aipref) çalışma grubu, yapay zekâ kullanım tercihleri için ortak bir sözlük ve bu sözlüğü robots.txt ya da HTTP başlıklarıyla iliştirme yöntemi üzerinde çalışıyor. Grubun takviminde IESG'ye gönderim için 31 Ağustos 2026 hedefi vardı; Eylül 2026 itibarıyla standart olarak yayımlandığına dair bir kaynak yok.
Content-Signal da tıpkı robots.txt gibi bir beyandır; ona uyup uymamak tarayıcının kararıdır. llms.txt gibi diğer makine okunur dosyaların ne ölçüde işe yaradığını llms.txt gerçeği yazısında veriyle tartıştık. Beyan dosyalarını elle yazmak yerine taslakla başlamak isteyenler için Sheltron'un llms.txt üreticisi robots.txt taslağı da oluşturabiliyor.
Sektörlere göre tablo nasıl değişiyor?
Haber siteleri beyanda, e-ticaret siteleri sunucuda engelliyor. Haber ve medya sitelerinin %16,7'si robots.txt'te bir eğitim botunu kapatıyor ve %7,3'ü AI arama botlarını da engelliyor. E-ticarette robots.txt engeli %8,7'de kalırken yapay zekâya özgü sunucu engeli %15,8'e çıkıyor. Kamu sitelerinde sunucu engeli hiç görülmedi.
| Sektör | Site | Eğitim botunu adıyla tam engelleyen | AI arama botunu tam engelleyen | AI'ya özgü sunucu engeli |
|---|---|---|---|---|
| Haber-medya | 96 | 16 (%16,7) | 7 (%7,3) | 14 / 96 (%14,6) |
| E-ticaret-perakende | 103 | 9 (%8,7) | 4 (%3,9) | 15 / 95 (%15,8) |
| Kamu | 46 | 2 | 1 | 0 / 42 |
| İçerik-topluluk | 28 | 2 | 1 | 8 / 28 |
| Finans | 26 | 3 | 0 | 1 / 26 |
| Telekom-yazılım | 26 | 1 | 0 | 0 / 25 |
| Seyahat-etkinlik | 21 | 4 | 0 | 3 / 20 |
Kaynak: Eylül 2026 taraması. Yalnızca en az 20 sitesi olan sektörler gösterildi; oran, 90'dan fazla sitesi olan iki sektörde verildi.
Haber siteleri, yapay zekâ tarayıcılarına karşı en net tavrı alan grup. 96 haber sitesinin 13'ü (%13,5) GPTBot'u tamamen engelliyor ve 7'si OAI-SearchBot'u da kapatıyor. Uluslararası karşılaştırma için sık anılan kaynak, Reuters Institute'un 2024 başında yayımladığı analiz. Bu analize göre 2023 sonunda 10 ülkenin en çok kullanılan 15'er haber sitesinin %48'i OpenAI'ın tarayıcılarını engelliyordu. Türkiye o örneklemde yoktu; ayrıca tarih, site seçimi ve tanım farklı olduğu için %48 ile bizim %13,5'imiz doğrudan karşılaştırılamaz. Medya sektöründe AI görünürlüğünün nasıl işlediğini medya ve yayıncılık sayfamızda topladık.
E-ticarette durum tersine dönüyor. robots.txt'te eğitim botunu kapatan e-ticaret sitesi 9, ama sunucuda yapay zekâ kimliklerine engel döndüren 15 site var. Ürün sayfaları AI alışveriş asistanlarının ve ajanların en çok ihtiyaç duyduğu içerik olduğundan, bu engelin kasıtlı olup olmadığını kontrol etmek e-ticaret ekipleri için özellikle önemli. Engel gözden geçirildikten sonra kataloğun AI yüzeylerindeki görünürlüğünü sürekli izlemek için Sheltron'un GEO Builder platformu kullanılabilir.
İçerik ve topluluk sitelerinde de 28 sitenin 8'i sunucuda AI'ya özgü engel döndürüyor. Kamu sitelerinde robots.txt engeli 2 sitede görülüyor, sunucu engeli ise test edilebilen 42 kamu sitesinin hiçbirinde yok.
Bu bulgular sitenizin AI görünürlüğü için ne anlama geliyor?
İki katmanı ayrı ayrı kontrol etmeniz gerektiği anlamına geliyor: robots.txt'in hangi yapay zekâ botuna ne söylediğini ve CDN ya da güvenlik duvarının aynı botlara gerçekte ne döndürdüğünü. Taramadaki en yaygın uyumsuzluk, robots.txt'te açık görünen bir sitenin sunucuda yapay zekâ kimliklerine engel döndürmesi.
Bu kontrol dört soruya indirgenebilir:
- Kararınız yazılı mı? Eğitim, arama ve kullanıcı adına getirme için ayrı ayrı "evet" ya da "hayır" kararı verin. Taramada eğitimi kapatan sitelerin çoğu aramayı açık bırakıyor, ama çoğunlukla varsayılan olarak; bu tercih sizin için geçerli olabilir, olmayabilir de.
- robots.txt kararınızı doğru ifade ediyor mu? Her botun adıyla bir grubu varsa
User-agent: *kurallarının o bota uygulanmadığını unutmayın. Botları dosyanızda tek tek görmek için robots.txt AI bot kontrol aracı yeterli. - Sunucu aynı kararı uyguluyor mu? CDN ya da WAF panelinizdeki bot yönetimi ayarlarını robots.txt kararınızla karşılaştırın. Cloudflare kullanıyorsanız arama, eğitim ve ajan kontrollerinin ayrı olduğunu ve 15 Eylül 2026'dan sonra Block seçeneğinin Googlebot ile Bingbot'u da kapsadığını hesaba katın; aramada kalıp eğitimi kapatmak için Disallow AI Training kullanılıyor.
- Değişiklik görünürlüğe yansıdı mı? Engeli kaldırdıktan ya da daralttıktan sonra, markanızın AI cevaplarında görünüp görünmediğini AI görünürlük spot check aracıyla ölçün.
Buradaki mantık, AI görünürlüğünün en temel ön koşulunun erişim olmasıdır. GEO nedir sayfasında anlattığımız gibi, bir yapay zekâ cevabında kaynak gösterilmek için önce içeriğin o sisteme ulaşabilmesi gerekir. Tarama, popüler Türk sitelerinin yaklaşık sekizde birinde yapay zekâ bot adlarına tepki veren ve robots.txt'te görünmeyen bir sunucu ya da CDN kuralına işaret ediyor. Yapay zekâ botlarını engelleme kararı, bir güvenlik ürününün varsayılanına bırakılmayacak kadar önemli bir görünürlük kararıdır.
Sitenizin yapay zekâ botlarına beyanda ve uygulamada ne söylediğini birlikte okumak, ChatGPT ve Gemini'de nasıl göründüğünüzü anlamanın ilk adımı. Sheltron'un hızlı değerlendirmesi, sitenizin yapay zekâ cevaplarındaki durumunu ölçerek işe nereden başlamanız gerektiğini gösterir.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Türk Siteleri Yapay Zekâ Botlarını Engelliyor mu? 425 Popüler Sitede robots.txt ve Sunucu Yanıtı Taraması
- TL;DR
- Eylül 2026 taramasında Türkiye'nin en popüler 425 sitesinin %9,2'si (39) robots.txt'te en az bir AI eğitim botunu adıyla tamamen engelliyor, AI arama botlarını kapatanlar %3,1. Test edilebilen 401 sitenin %12,7'si GPTBot ya da ClaudeBot kimliğine AI'ya özgü sunucu engeli döndürüyor; bunların 45'inin robots.txt'i GPTBot'u tamamen engellemiyor. Cloudflare arkasında oran %22,7, dışında %4,9.
- Ana Çıkarımlar (7)
- Eylül 2026'da Türkiye'nin en popüler 425 sitesinin 39'u (%9,2) robots.txt'te en az bir AI eğitim botunu adıyla tamamen engelliyor; AI arama botlarını kapatanların oranı %3,1 (13 site).
- En çok engellenen bot GPTBot (23 site, %5,4); ardından ClaudeBot (18), Bytespider (15), CCBot ve meta-externalagent (14'er) geliyor. Hiçbir site User-agent: * ile tüm siteyi kapatmıyor.
- Eğitim botunu engelleyen 39 sitenin 27'si (%69) OAI-SearchBot, Claude-SearchBot ve PerplexityBot'un hiçbirini tamamen engellemiyor; arama botları açık kalıyor (27 sitenin 18'inde varsayılan olarak, yalnızca 9'u bir arama botunu adıyla anıyor).
- Test edilebilen 401 sitenin 51'i (%12,7) GPTBot ya da ClaudeBot kimliğine AI'ya özgü 403 ya da challenge döndürüyor; bunların 45'inin (%88) robots.txt'i GPTBot'u tamamen engellemiyor.
- Cloudflare arkasındaki test edilebilir sitelerde AI'ya özgü sunucu engeli oranı %22,7, Cloudflare dışında %4,9; AI'ya özgü engellerin 51'de 40'ı Cloudflare arkasında.
- Yeni beyan araçları yaygın değil: Content-Signal satırı 15 sitede (%3,5), Cloudflare Managed robots.txt bloğu 2 sitede, Bot Preference Sync bloğu hiçbir sitede yok.
- Haber sitelerinin %16,7'si eğitim botunu robots.txt'te kapatıyor; e-ticarette robots.txt engeli %8,7'de kalırken AI'ya özgü sunucu engeli %15,8'e çıkıyor.
- Kaynaklı Veriler
- %9,2 — Türkiye'nin en popüler 425 sitesinden robots.txt'te en az bir AI eğitim botunu adıyla tamamen engelleyenlerin oranı (39 site) (Sheltron taraması (CrUX TR Ağustos 2026 ilk 1.000 kovası, Eylül 2026, N=425), 2026)
- %3,1 — en az bir AI arama botunu (OAI-SearchBot, Claude-SearchBot, PerplexityBot) tamamen engelleyen site oranı (13 site) (Sheltron taraması (Eylül 2026, N=425), 2026)
- %12,7 — GPTBot ya da ClaudeBot kimliğiyle gelen isteğe AI'ya özgü 403 ya da challenge döndüren test edilebilir site oranı (51/401) (Sheltron taraması (Eylül 2026, sunucu yanıtı testi, N=401), 2026)
- 45 — AI'ya özgü sunucu engeli döndüren 51 sitenin robots.txt'i GPTBot'u tamamen engellemeyenlerin sayısı (%88) (Sheltron taraması (Eylül 2026), 2026)
- %22,7 — Cloudflare arkasındaki test edilebilir sitelerde AI'ya özgü sunucu engeli oranı; Cloudflare dışında %4,9 (Sheltron taraması (Eylül 2026), 2026)
- %69 — eğitim botunu engelleyen 39 sitenin üç AI arama botundan hiçbirini tamamen engellemeyenlerin oranı (27 site; yalnızca 9'u bir arama botunu adıyla anıyor) (Sheltron taraması (Eylül 2026), 2026)
- %3,5 — robots.txt'te Content-Signal satırı kullanan site oranı (15/425) (Sheltron taraması (Eylül 2026), 2026)
- %80,5 — geçerli bir robots.txt dosyası olan site oranı (342/425) (Sheltron taraması (Eylül 2026), 2026)
- %17 — Cloudflare sitelerinden AI eğitimini engellemek için bir mekanizma açanların oranı; arama botlarını engelleyenler %1'in altında (Cloudflare Blog — Have it both ways: stay discoverable in search while disallowing AI training, 2026)
- %36,6 — karma kullanımlı (arama ve eğitim) tarayıcıların Cloudflare'deki doğrulanmış tarayıcı trafiğindeki payı (Cloudflare basın bülteni — Cloudflare Helps End the Search-or-AI-Training Tradeoff, 2026)
- %7,8 — en popüler 10.000 alan adının robots.txt dosyalarında GPTBot'un kısıtlandığı oran (Temmuz 2025) (Cloudflare Blog — Control content use for AI training with Cloudflare's managed robots.txt, 2025)
- %48 — 2023 sonunda 10 ülkenin önde gelen haber sitelerinden OpenAI tarayıcılarını engelleyenlerin oranı (Reuters Institute for the Study of Journalism — How many news websites block AI crawlers?, 2024)
- %28'den fazla — C4 veri kümesinin kritik kaynaklarından bir yılda robots.txt ile tamamen kısıtlananların payı (Longpre ve ark., Consent in Crisis: The Rapid Decline of the AI Data Commons (arXiv), 2024)
- 500.000:1'e kadar — Anthropic'in crawl-to-refer oranı: yönlendirdiği her ziyarete karşılık yaptığı tarama sayısı (Cloudflare Radar 2025 Year in Review, 2025)
- 3,8 milyon — Cloudflare Managed robots.txt özelliğini kullanan alan adı sayısı (Eylül 2025) (Cloudflare Blog — Giving users choice with Cloudflare's new Content Signals Policy, 2025)
- Arama Niyetleri
- türk siteleri yapay zeka botlarını engelliyor mu
- gptbot engelleme oranı türkiye
- robots.txt ai bot istatistikleri türkiye
- content-signal ai-train kullanımı
- cloudflare managed robots.txt türkiye
- gptbot 403 engelleniyor
- eğitim botu arama botu ayrımı robots.txt
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz