Schema @id Nedir? Organization, WebSite ve Person'ı Tek Entity Grafiğinde Birleştirmek
Schema @id, JSON-LD'de bir varlığın URL biçimindeki kalıcı kimliğidir. Yazı, Organization, WebSite ve Person düğümlerini @id ve @graph ile tek bir entity grafiğinde bağlamayı, @id format kurallarını ve çift şema tuzaklarını kendi sitemizin canlı verisiyle anlatıyor.
💡Kısa Özet
Schema @id, aynı şirketi, kişiyi ya da siteyi her sayfada tek bir varlık olarak tanıtan URL biçimindeki kimliktir. RDF 1.1'e göre iki @id yalnız karakter karakter aynıysa eşittir; #eren-cop ile #eren-çöp iki ayrı kişidir. Eylül 2026'da sheltron.com.tr'nin 325 sayfasını taradık: 22 sayfada çift BreadcrumbList, 21 sayfada aynı @id'li ikinci Organization düğümü, 235 blog yazısının 222'sinde iki unvanlı yazar bulduk.
Ana Çıkarımlar
- •@id, JSON-LD'de bir düğümün IRI biçimindeki kimliğidir; yalnız @id içeren nesne başka yerde tanımlı varlığa referanstır (W3C JSON-LD 1.1).
- •RDF 1.1'e göre IRI eşitliği normalizasyonsuz, karakter karakter karşılaştırmadır: http/https, www, sondaki / ve Türkçe karakter farkı ayrı varlık yaratır.
- •Göreli "#organization" her sayfada o sayfanın adresine çözülür; 100 sayfalık sitede 100 ayrı şirket demektir. @id her zaman mutlak URL olmalı.
- •Aynı @id'ye ikinci tam düğüm basmak çelişkiyi silmez: düzleştirme sonrası iki unvan ya da iki ad aynı varlıkta yan yana birikir.
- •Sheltron, çelişkili 3 Organization tanımını tek kaynağa indirdi; Ağustos 2026 itibarıyla kaynak kodda 33 noktadan yalnız @id ile referans veriyordu.
- •Eylül 2026 taramasında 325 sayfada 1.447 JSON-LD bloğu ve 1.144 yalnız-@id referansı; 22 sayfada çift BreadcrumbList, 21 sayfada ikinci Organization düğümü bulundu.
- •Google'ın AI özellikleri belgesine göre AI Overviews için özel şema gerekmez; @id bir görünürlük garantisi değil, varlık tutarlılığı aracıdır.
Schema @id, JSON-LD'de bir şirkete, kişiye ya da web sitesine verilen URL biçimindeki kalıcı kimliktir. Aynı @id'yi taşıyan her nesne, hangi sayfada ya da blokta durursa dursun aynı varlık sayılır. HTTP Archive'ın Web Almanac 2024 yapılandırılmış veri bölümüne göre JSON-LD sayfaların %41'inde kullanılıyor (2022'de %34'tü). Ancak JSON-LD kullanmak, varlıkların birbirine doğru bağlandığı anlamına gelmiyor.
Aşağıda @id mimarisini kendi sitemizin kaydı üzerinden anlatıyoruz. Sheltron'da Organization eskiden üç ayrı dosyada, birbiriyle çelişen bilgilerle tanımlıydı; bu tanımları tek kaynağa indirdik. Eylül 2026'da sheltron.com.tr'nin 325 sayfasını yeniden taradığımızda 1.447 JSON-LD bloğu, 1.144 yalnız-@id referansı ve hâlâ kapanmamış dört tutarsızlık bulduk. Düzelttiklerimizi de açık kalanları da rakamlarıyla paylaşıyoruz. JSON-LD'nin temellerine yeniyseniz önce Schema.org ve JSON-LD rehberimize göz atmanızı öneririz.
Schema @id nedir ve neden bir kimlik numarası gibi çalışır?
@id, bir JSON-LD düğümünü tanımlayan IRI'dir; pratikte bir URL'dir. W3C'nin JSON-LD 1.1 standardına göre düğüm @id anahtar kelimesiyle tanımlanır. Yalnız @id içeren nesne ise "node reference" sayılır, yani başka bir yerde tam olarak tanımlanmış bir varlığa işaret eder. Aynı @id'yi taşıyan iki nesne, farklı bloklarda dursa bile aynı varlığı anlatır.
JSON-LD 1.1 spesifikasyonu bunu tek cümleyle söyler: "In JSON-LD, a node is identified using the @id keyword." Kimlik numarası benzetmesi burada işe yarar. Adları aynı olan iki kişiyi kimlik numarası ayırır; adı iki farklı biçimde yazılmış tek bir kişiyi de yine kimlik numarası birleştirir. @id, yapılandırılmış veride aynı işi görür: blog yazısındaki yayıncının, ürün sayfasındaki sağlayıcının ve ana sayfadaki şirketin aynı kurum olduğunu, adların benzerliğinden tahmin etmeye gerek bırakmadan söyler.
@id ile url özelliği sık karıştırılır. url, varlığın web sayfasını gösteren sıradan bir schema.org özelliğidir. @id ise varlığın kendisinin kimliğidir. Yaygın uygulamada şirketin url değeri ana sayfa (https://ornek.com.tr/), @id değeri ise aynı adresin parçalı biçimidir (https://ornek.com.tr/#organization). Sondaki #organization parçası, ana sayfa belgesiyle o belgenin anlattığı şirketi birbirinden ayırır.
@id verilmeyen düğüm "blank node" olur. İşlemci ona _:b0 gibi geçici bir ad verir ve bu ad yalnız o belge içinde geçerlidir; başka bir bloktan ya da sayfadan bu düğüme bağlanamazsınız. Kendi blog yazılarımızdan birinin şemasını JSON-LD işlemcisinden geçirdiğimizde 35 düğüm çıktı: 4'ü adlandırılmış IRI, 31'i blank node. Bu tek başına hata değildir; bir BreadcrumbList'in liste öğelerine kalıcı kimlik vermek gerekmez. Asıl kural şudur: birden fazla sayfada ya da blokta geçen her varlığın bir @id'si olmalıdır.
Pratikte kalıcı kimlik isteyen düğümler şunlardır:
- Organization: Sitenin yayıncısı, ürünlerin sağlayıcısı, yazarların işvereni.
- WebSite: Tüm sayfaların
isPartOfile bağlandığı üst varlık. - Person: Yazarlar ve kurucular; E-E-A-T sinyalinin makine okunur hâli.
- WebPage ve Article: Sayfaya özel düğümler; kendi URL'lerinden türetilir.
- Tekrar kullanılan görseller: Örneğin logo, bir kez tanımlanıp
imageya dalogoözelliğinde referansla çağrılır.
Web Almanac 2024 verisine göre mobil sayfalarda en yaygın JSON-LD tipi %12,73 ile WebSite; Organization %7,16 ile onu izliyor, BreadcrumbList ise sayfaların %5,66'sında yer alıyor. Listenin başındaki bu tipler, bir sitede sayfadan sayfaya tekrarlanan ve bu yüzden kalıcı kimliğe en çok ihtiyaç duyan tiplerdir.
JSON-LD ile schema.org aynı şey mi?
Hayır. schema.org bir sözlüktür: Organization, Person, sameAs gibi tip ve özellik adlarını tanımlar; Eylül 2026 itibarıyla güncel sürümü 16 Eylül 2026 tarihli 30.1'dir. JSON-LD ise bu terimleri sayfaya yazmanın W3C standardı olan sözdizimidir. @id ve @graph schema.org'a değil, JSON-LD'ye aittir; bu yüzden kurallarını da W3C belirler.
Ayrımın pratik karşılığı şudur: schema.org Organization sayfası bir şirketi hangi özelliklerle anlatabileceğinizi söyler (legalName, foundingDate, founder, sameAs). İki farklı bloktaki şirketin aynı şirket olup olmadığına ise W3C ve IETF belgelerindeki kimlik kuralları karar verir.
| Katman | schema.org | JSON-LD |
|---|---|---|
| Ne tanımlar? | Tip ve özellik adları (sözlük) | Bu adların sayfada nasıl yazılacağı (sözdizimi) |
| Kim yönetir? | schema.org topluluğu | W3C (JSON-LD 1.1 Önerisi, 2020) |
| @id, @graph, @context | Tanımlamaz | Tanımlar |
| Diğer biçimlerle ilişkisi | Microdata ve RDFa da aynı sözlüğü kullanır | Microdata ve RDFa'ya alternatif bir sözdizimi |
| Google'ın tercihi | — | JSON-LD'yi önerir |
Google, yapılandırılmış veriye giriş belgesinde JSON-LD'yi "ölçekte uygulaması ve bakımı en kolay çözüm" olarak önerir. Sözdizimi örneklerini ayrıntılı görmek isterseniz JSON-LD teknik rehberimize bakabilirsiniz. Buradan sonrası tamamen JSON-LD'nin kimlik mekanizmasıyla ilgili.
Aynı şirketi birden çok yerde tanımlamak grafiği nasıl böler?
JSON-LD işlemcileri aynı @id'yi taşıyan parçaları tek düğümde birleştirir; çelişen değerler birbirini silmez, yan yana birikir. Farklı @id'ler ise hiç birleşmez. İki durumda da makine "bu şirketin adı ne, kurucusunun unvanı ne" sorusuna tek bir cevap bulamaz. Sonuçta aynı şirket, makine okunur veride ya çelişkili tek bir kayıt ya da birbirinden habersiz birkaç kayıt olarak kalır.
Birleştirmenin normatif dayanağı JSON-LD 1.1 İşleme Algoritmaları belgesindeki "flattening" adımıdır: işlemci bir düğüm haritası kurar ve bu harita "collects all properties of a node in a single map". Yani aynı @id'li iki tanım tek düğüme dökülür. Bir tanımda "Kurucu & CEO", diğerinde "Kurucu & GEO Stratejisti" yazıyorsa işlemci birini seçmez, ikisini birden aynı kişiye yazar.
Bunu varsayım olarak bırakmadık. Eylül 2026'da Schema.org ve JSON-LD rehberimizin sayfasındaki beş JSON-LD bloğunu açık kaynaklı jsonld kütüphanesiyle düzleştirdik. Yazar düğümünün jobTitle alanı iki ayrı değer olarak çıktı. Çelişki kaybolmadı, grafiğin içine yerleşti.
Kimliği farklı yazılmış tanımlar ise hiç buluşmaz. Sheltron'da Organization eskiden üç yerde tanımlıydı: sayfa kodunun içinde, public/schema.json dosyasında ve public/entity.graph dosyasında. Üçü de farklı foundingDate, sameAs ve adres taşıyordu. Hepsini tek bir yapılandırma dosyasına indirdik; hem sayfalardaki JSON-LD hem /schema.json artık oradan besleniyor. Yalnız entity.graph dosyası Eylül 2026 itibarıyla hâlâ yayında ve ayrı bir kimlik taşıyor; ayrıntısı çift şema bölümünde.
Google'ın Organization belgesi bu işaretlemenin amacını, kurumun "arama sonuçlarında ayırt edilmesine" (disambiguate) yardım etmek olarak tanımlıyor. Çelişen iki tanım bu amaca ters düşer. ChatGPT ya da Perplexity gibi AI platformlarının JSON-LD'yi içeride nasıl işlediği kamuya açık biçimde belgelenmiş değil. Kesin olarak söyleyebileceğimiz, standardın ne ürettiğidir; aşağıdaki tablo bunu kendi sitemizden örneklerle özetliyor.
| Durum | Kendi sitemizden örnek | JSON-LD işlemcisindeki sonuç |
|---|---|---|
| Farklı @id, aynı şirket | sheltron:Organization (entity.graph) ile https://sheltron.com.tr/#organization |
İki ayrı düğüm, hiç birleşmez |
| Aynı @id, çelişen değer | Person jobTitle: "Kurucu & CEO" ve "Kurucu & GEO Stratejisti" |
Tek düğüm, iki unvan |
| Aynı @id, eksik alanlı ikinci düğüm | /sektorler/finans/ sayfasındaki 5 alanlı ikinci Organization |
Tek düğüm, iki farklı name |
| Yalnız-@id referansı | "publisher": {"@id": "https://sheltron.com.tr/#organization"} |
Tek düğüm, çelişki yok (hedef durum) |
@id URL formatı nasıl olmalı?
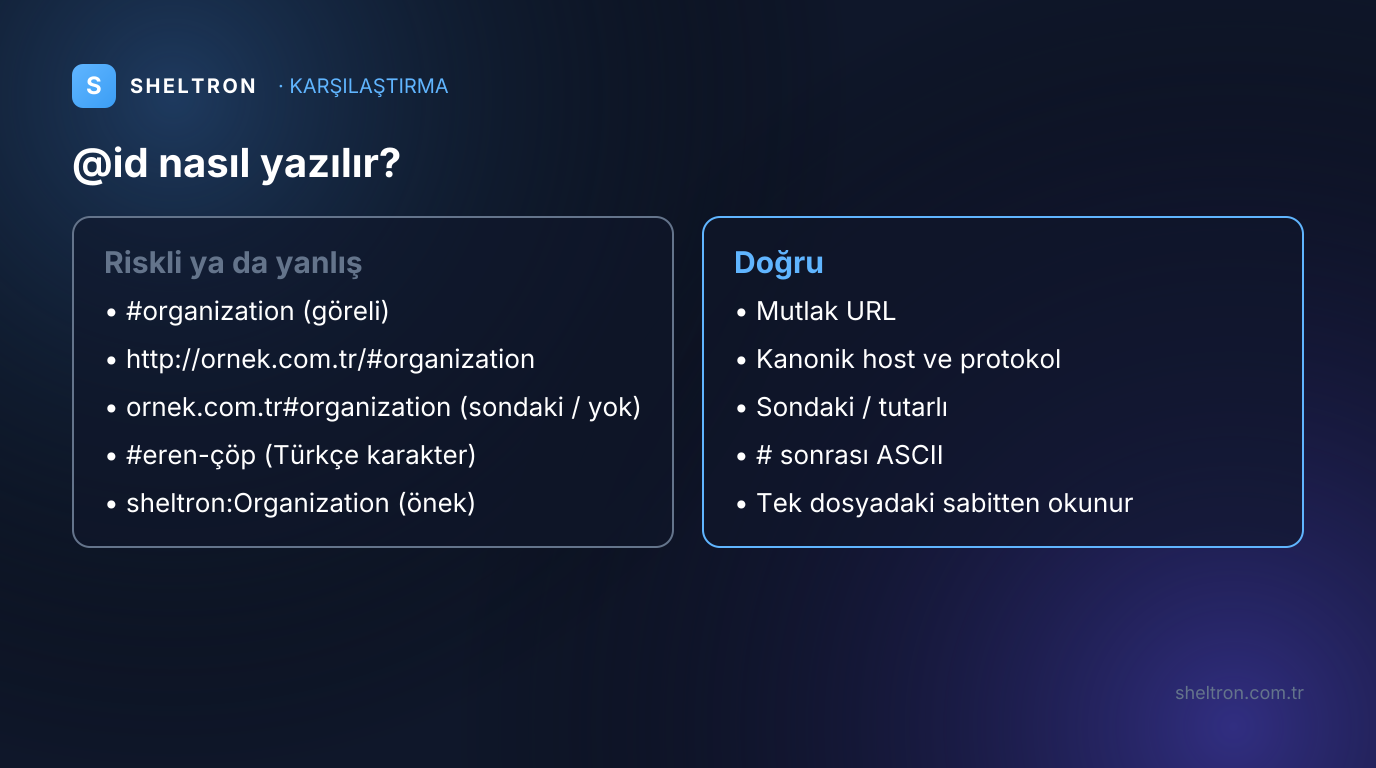
@id her zaman mutlak bir URL olmalı, alan adının kanonik biçimini (https, www'lu ya da www'suz, sondaki eğik çizgi) birebir kullanmalı ve # işaretinden sonraki parça ASCII karakterlerden oluşmalıdır. RDF 1.1'e göre iki IRI yalnız karakter karakter aynıysa eşittir; hiçbir normalizasyon yapılmaz.
RDF 1.1 Kavramlar belgesi kuralı açıkça koyar: iki IRI, basit dize karşılaştırmasında aynıysa eşittir ve "Further normalization MUST NOT be performed". Dayandığı RFC 3987 §5.3.1 basit dize karşılaştırmasını tanımlar. §5.3.2 ise %7Bfoo%7D/rosé ile %7bfoo%7d/ros%C3%A9 gibi IRI'lerin ancak normalizasyon yapan bir sistemde eşit sayılabileceğini örnekler. RDF 1.1 bu normalizasyonu yasakladığı için bu IRI'ler JSON-LD'de ayrı kimliktir. Bir tarayıcı iki adresi aynı sayfaya götürebilir; kimlik karşılaştırması ise bununla ilgilenmez.
Türkçe siteler için en somut tuzak burada ortaya çıkıyor. Yazar @id'miz bir yerde …/ekip/#eren-çöp, ekip sayfamızda ise …/ekip/#eren-cop olarak yazılmıştı. Bir insan için ikisi aynı kişidir; JSON-LD işlemcisi için iki ayrı Person'dır. Aynı iki kimliği Eylül 2026'da bir denemede düzleştirdiğimizde işlemci gerçekten iki ayrı düğüm döndürdü; yani eski yapıda yazar sinyali ikiye bölünüyordu. @id slug'larını ASCII'ye çevirerek sorunu kapattık.
JSON-LD'de iki @id yalnız karakter karakter aynıysa aynı varlıktır; #eren-cop ile #eren-çöp bir makine için iki ayrı insandır.
İkinci tuzak göreli @id'dir. JSON-LD 1.1 §4.1.3'e göre göreli IRI'ler belgenin temel adresine göre çözülür; sayfaya gömülü JSON-LD'de bu temel adres sayfanın kendi URL'sidir. Aynı denemede "@id": "#organization" ana sayfada https://sheltron.com.tr/#organization, /hakkimizda/ sayfasında ise https://sheltron.com.tr/hakkimizda/#organization olarak genişledi. Göreli bir #organization @id'si her sayfada o sayfanın adresine çözülür; 100 sayfalık bir sitede 100 ayrı şirket demektir.
| @id | Durum | Neden |
|---|---|---|
https://ornek.com.tr/#organization |
Doğru | Mutlak, kanonik host, ASCII |
#organization |
Riskli | Her sayfada o sayfanın URL'sine çözülür |
http://ornek.com.tr/#organization |
Yanlış | Protokol farkı, farklı IRI demektir |
https://ornek.com.tr#organization |
Yanlış | Sondaki / eksik, farklı IRI |
https://ornek.com.tr/ekip/#eren-çöp |
Yanlış | ASCII sürümden (#eren-cop) ayrı bir kişi |
sheltron:Organization (önekli) |
Yanlış | @context'teki öneke göre başka bir adrese genişler |
https://ornek.com.tr/#/schema/organization/1 |
Doğru | Mutlak ve tutarlı; farklı bir adlandırma geleneği |
Son satır bir hatırlatma: #organization biçimi bir zorunluluk değil, yalnızca yaygın bir gelenektir. Yoast'un şema yaklaşımı belgesinde /#/schema/organization/1 kalıbı kullanılıyor. Hangi kalıbı seçtiğiniz değil, seçtiğiniz kalıbı her yerde birebir aynı yazmanız belirleyicidir.
@graph ne işe yarar, iç içe yazımdan farkı ne?
@graph, aynı @context'i paylaşan birden çok varlığı tek blokta yan yana listeler; varlıklar birbirinin içine gömülmek yerine @id ile bağlanır. Google iç içe yazımı da ayrı blokları da kabul eder, ancak ayrı blokların birbirine bağlanması için @id kullanılmasını açıkça önerir.
JSON-LD 1.1'e göre yalnız @context ve @graph içeren bir üst düzey nesne, belgenin örtük varsayılan grafiğini ifade eder; spesifikasyon bunu, üst düzeyde aynı bağlamı paylaşan çok sayıda düğüm olduğunda yararlı bulur. İç içe yazımda ise yazar nesnesi Article'ın içine, kurucu nesnesi Organization'ın içine gömülür. Tek seferlik bir varlık için sorun yoktur. Ancak aynı kişi hem Article'ın yazarı hem şirketin kurucusu olarak iki ayrı yerde gömülü yazılırsa iki kopya zamanla birbirinden uzaklaşır. Yukarıdaki iki unvan sorunu tam olarak böyle doğdu.
Google'ın genel yapılandırılmış veri yönergeleri aynı sayfadaki ayrı blokları bağlamayı bir yemek tarifi ve video örneğiyle anlatır: iki öğede de @id kullanın; bağlamazsanız Google Search videonun tarife ait olduğunu bilemeyebilir. Aşağıdaki iskelet, bir blog yazısı için beş düğümlük tipik bir grafiği gösteriyor:
{
  "@context": "https://schema.org",
  "@graph": [
    { "@type": "Organization", "@id": "https://ornek.com.tr/#organization",
      "name": "Örnek Teknoloji A.Ş.", "url": "https://ornek.com.tr/",
      "logo": { "@id": "https://ornek.com.tr/#logo" } },
    { "@type": "WebSite", "@id": "https://ornek.com.tr/#website",
      "url": "https://ornek.com.tr/",
      "publisher": { "@id": "https://ornek.com.tr/#organization" } },
    { "@type": "Person", "@id": "https://ornek.com.tr/ekip/#ad-soyad",
      "name": "Ad Soyad",
      "worksFor": { "@id": "https://ornek.com.tr/#organization" } },
    { "@type": "WebPage", "@id": "https://ornek.com.tr/blog/yazi/#webpage",
      "isPartOf": { "@id": "https://ornek.com.tr/#website" } },
    { "@type": "Article", "@id": "https://ornek.com.tr/blog/yazi/#article",
      "mainEntityOfPage": { "@id": "https://ornek.com.tr/blog/yazi/#webpage" },
      "author": { "@id": "https://ornek.com.tr/ekip/#ad-soyad" },
      "publisher": { "@id": "https://ornek.com.tr/#organization" } }
  ]
}
Bu iskelette her varlık bir kez tanımlanıyor, ilişkiler ise yalnız kimlikle kuruluyor: WebSite'ı yayımlayan Organization, Person'ın çalıştığı Organization, WebPage'in parçası olduğu WebSite, Article'ın yazarı olan Person. Hiçbir düğüm başka bir düğümün kopyasını taşımıyor; bu yüzden çelişki üretecek ikinci bir kaynak da yok.
Organization, WebSite ve Person'ı tek grafikte nasıl bağlarsınız?
Tam Organization, WebSite ve Person düğümlerini tek bir yapılandırma dosyasından üretin ve her sayfada bir kez basın. Sayfa şablonları bu varlıkları yeniden tanımlamaz; publisher, author, worksFor ve isPartOf gibi özelliklerde yalnız {"@id": …} verir. Ağustos 2026 iç değerlendirmemize göre Sheltron kaynak kodunda Organization'a 33 noktadan bu şekilde referans veriliyordu.
Uygulamayı beş adıma bölüyoruz:
Kimlik sabitlerini tek dosyada tanımlayın. Bizde bu dosya
src/lib/seo-config.ts; kimlikler taban adresten türetiliyor:${baseUrl}/#organization,${baseUrl}/#website,${baseUrl}/ekip/#eren-cop. Hedef, hiçbir şablonun @id'yi elle yazmaması ve bu sabitleri okumasıdır. Eylül 2026 itibarıyla bizde sektör ve araç sayfaları gibi bazı şablonlar kimliği hâlâ düz metin olarak yazıyordu; çift Organization bulgusu da bunlardan birinden çıkıyor.Tam düğümleri yalnız o kaynaktan üretin. Google, Organization bilgisini ana sayfaya ya da kurumu anlatan tek bir sayfaya koymayı öneriyor ve zorunlu alan belirlemiyor; ilgili olan her özelliği eklemenizi istiyor. Person için kanonik sayfa ekip ya da yazar sayfasıdır. Google'ın Article belgesi de yazarın, onu benzersiz biçimde tanımlayan bir sayfaya bağlanmasını tavsiye ediyor. Yazar grafiğinin güven sinyaliyle ilişkisini E-E-A-T ve yapay zekâ yazımızda ayrıntılandırdık.
Sayfa düğümlerinde yalnız referans verin. Canlı
/schema.jsondosyamızdaki WebSite düğümü, yayıncısını yeniden tanımlamak yerine yalnız kimliğiyle çağırıyor (kısaltılmış):JSON Kod Örneği{ "@type": "WebSite", "@id": "https://sheltron.com.tr/#website", "url": "https://sheltron.com.tr", "publisher": { "@id": "https://sheltron.com.tr/#organization" }, "inLanguage": "tr-TR" }JSON-LD'yi sunucu tarafında basın. Google, JavaScript ile sonradan eklenen JSON-LD'yi okuyabildiğini belirtiyor. Google dışındaki AI tarayıcılarının JavaScript çalıştırıp çalıştırmadığı ise her platform için belgelenmiş değil; riski almamak için tüm şemayı sunucuda üretilen HTML'e taşıdık. Next.js tarafındaki uygulamayı schema markup ve llms.txt teknik altyapı yazımızda anlattık.
Referansları doğrulayın. Ücretsiz Şema Doğrulayıcı sayfadaki JSON-LD bloklarını ve @graph düğümlerini tek tek listeler. Araç Eylül 2026 itibarıyla @graph içindeki düğümlerde "@context eksik" hatası gösterebiliyor; @context üst nesnede tanımlıysa bu hata yok sayılabilir. Referans hedeflerinin grafikte var olup olmadığını görmek için ise sayfanın JSON-LD'sini bir JSON-LD işlemcisinde (ör. jsonld kütüphanesi ya da JSON-LD Playground) düzleştirin. Schema Markup Üretici Eylül 2026 itibarıyla Organization ve Person düğümlerine @id eklemiyor. Ürettiğiniz kodda kimlik alanlarını yukarıdaki sabitlerle elle eklemeniz gerekiyor; adım adım akış için 9 adımlık üretici rehberimize bakabilirsiniz.
İki rakamı karıştırmamak gerekir. 33, Ağustos 2026 itibarıyla kaynak kodda Organization'a referans verilen noktaların sayısıdır. Eylül 2026 taramasında 325 sayfanın HTML çıktısında saydığımız 1.144 yalnız-@id nesnesi ise yalnız Organization'a değil, tüm varlıklara giden referansların toplamıdır. Site altyapısını sıfırdan kuruyorsanız kimlik sabitlerini baştan tasarıma dahil etmek, sonradan temizlemekten çok daha az emek ister. Şema işaretlemesini site kurulumunun bir parçası olarak sunan GEO Builder gibi altyapılarda bu karar ilk günden verilebilir.
Çift şema nereden çıkar? Bileşen ve sayfa @graph tuzağı
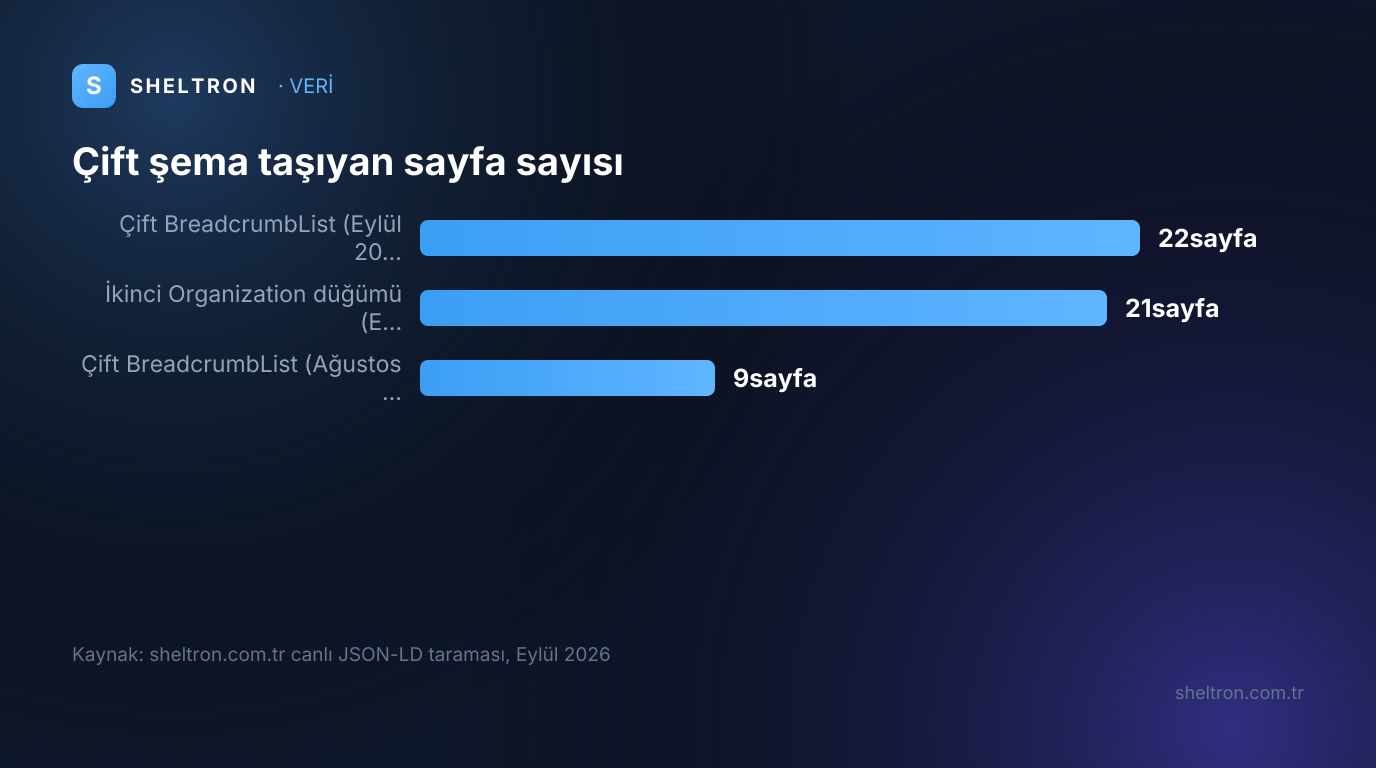
Çift şema çoğunlukla tekrar kullanılan bir bileşenin (breadcrumb, SSS, sayfa iskeleti) kendi JSON-LD'sini basmasından ve sayfanın aynı tipi kendi @graph'ında yeniden tanımlamasından doğar. Kendi sitemizin Eylül 2026 taramasında 22 sayfada çift BreadcrumbList, 21 sayfada aynı @id'li ikinci bir Organization düğümü bulduk.
Rakamlar Eylül 2026 taramasına aittir ve yayın tarihine kadar bir kısmı düzeltilmiş olabilir. Taramada sitenin yayındaki 326 URL'sini çektik; 325'i yanıt verdi. Her sayfadaki JSON-LD bloklarını ayrıştırıp tip ve kimlik alanlarını saydık. Taramayı aynı ay içinde tekrarladığımızda geçici hata veren tek sayfa dışında sonuçlar birebir aynı çıktı. Bulgular şöyle:
- Çift BreadcrumbList (22 sayfa): Örneğin
/sektorler/finans/sayfasında bir blok "Ana Sayfa › Sektörler › Finans & Bankacılık" diyor ve @id taşıyor. Breadcrumb bileşeninin bastığı ikinci blok ise "Anasayfa › Sektörler › Finans & Bankacılık" diyor ve @id taşımıyor. Ağustos 2026 tarihli iç değerlendirmemizde bu sorun 9 sayfa olarak kayıtlıydı. İki sayım aynı yöntemle yapılmadığı için farkın bir kısmı kapsamdan kaynaklanıyor olabilir; kesin olan, sorunun kapanmadığıdır. - İkinci Organization düğümü (21 sayfa): Aynı finans sayfasında sayfa iskeletinin bastığı Organization 21 alanlı ve adı "Sheltron Teknoloji A.Ş."; sayfanın kendi @graph'ındaki düğüm ise 5 alanlı ve adı "Sheltron Teknoloji". İkisi de
https://sheltron.com.tr/#organizationkimliğini taşıdığı için düzleştirme sonrasında şirketin iki farklı adı oluyor. Bu sayfanın şablonu kimliği seo-config'ten okumak yerine kendi sabitini tanımlıyor. - İki unvanlı yazar (235 yazının 222'si): Aynı Person @id'si sayfa iskeletindeki kurucu tanımında "Kurucu & CEO", yazar tanımında "Kurucu & GEO Stratejisti" unvanını taşıyor. Kalan 13 yazıda yalnız "Kurucu & CEO" var.
- Önekli ayrı entity dosyası:
entity.graphdosyası Eylül 2026 taramasında hâlâ yayındaydı veapplication/octet-streamtürüyle sunuluyordu.@contextiçindesheltronönekihttps://sheltron.com.tr/ontology/adresine bağlı olduğu içinsheltron:Organizationkimliğihttps://sheltron.com.tr/ontology/Organizationadresine genişliyor. Kuruluş tarihi artık kanonik tanımla aynı (2025-07-28); çelişki tarih düzeyinde değil, kimlik düzeyinde sürüyor.
Aynı @id'ye ikinci kez tam düğüm basmak çelişkiyi çözmez, çoğaltır: JSON-LD işlemcisi iki farklı adı ya da unvanı silmeden aynı varlığa yazar.
Çözümün kalıbı bizde zaten var. Tekrar kullanılan SSS bileşeni her render'da kendi FAQPage'ini basıyordu; sayfa seviyesinde FAQPage tanımlanan yerler için bileşene bir disableSchema seçeneği ekledik ve Ağustos 2026 iç değerlendirmemize göre bu seçenek 8 sayfa şablonunda kullanılıyordu. Eylül 2026 itibarıyla aynı seçenek breadcrumb bileşenine eklenmemişti. İkinci Organization düğümünün düzeltmesi daha da basit: sayfa @graph'ı Organization'ı yeniden yazmak yerine {"@id": "https://sheltron.com.tr/#organization"} referansı vermeli. Benzer çiftlenme SSS işaretlemesinde de sık görülür; FAQ ve QA şeması seçimi yazımız ile doğrulayıcıdaki 9 hata rehberimiz bu vakaları tek tek ele alıyor.
@id eklemek AI görünürlüğünü garanti eder mi?
Hayır. Google'ın AI özellikleri belgesi, AI Overviews ya da AI Mode'da görünmek için eklenmesi gereken özel bir schema.org işaretlemesi olmadığını söylüyor. @id bir sıralama ya da atıf sinyali olarak belgelenmiş değildir; işlevi, bir varlık hakkındaki makine okunur bilginin tek ve çelişkisiz kalmasını sağlamaktır.
Google'ın AI özellikleri belgesi bunu açıkça yazıyor: "There's also no special schema.org structured data that you need to add." Belgelenmemiş başka noktalar da var. Google'ın farklı sayfalardaki aynı @id'leri tek varlıkta birleştirip birleştirmediği resmî olarak açıklanmış değil. Yoast da sayfalar arası desteğin "limited" olduğunu not ediyor ve her sayfanın ilgili düğümleri kendisinin basmasını öneriyor. Bu yüzden önerdiğimiz mimari iki ilkeyi birlikte uygular: tam düğüm her sayfada bir kez ve tek kaynaktan basılır, sayfaya özel düğümler ona yalnız kimlikle bağlanır.
Kendi verimiz de şemanın tek başına yetmediğini gösteriyor. Ağustos 2026 değerlendirmemizde FAQPage işaretlemesi ile AI atfı arasındaki korelasyon ρ = −0,061 çıktı; pratikte ilişki yoktu. Buradan çıkardığımız ders, alıntılanmasını istediğimiz her bloğun yalnız şemada değil, sunucuda üretilen HTML'de de görünür olması gerektiğiydi. Google'ın yönergesi de aynı yönde: okuyucunun göremediği içeriği işaretlemeyin.
Peki @id neden yine de önemli? Çünkü yapılandırılmış veri çok büyük ölçekte makinelerce işleniyor. Mannheim Üniversitesi'nin Web Data Commons projesi, Ekim 2024 Common Crawl verisinde ayrıştırılan 2,39 milyar HTML URL'nin 1,25 milyarında yapılandırılmış veri buldu ve toplam 15,6 milyar tiplenmiş entity çıkardı. Bu ölçekte varlıkları eşleştiren bir sistem için en sağlam ipucu, adların benzerliği değil açık bir kimliktir. Kimliği bölmek, bu eşleştirmeye kendi elinizle belirsizlik eklemek demektir. Entity ve otorite kavramının daha geniş çerçevesi için The GEO Authority kaynaklarına, terimlerin kısa tanımları için GEO terimleri sözlüğümüze bakabilirsiniz.
Entity grafiğinizi beş kontrolle nasıl denetlersiniz?
Denetim beş soruya iner: her varlığın tek bir @id'si var mı, @id'ler mutlak ve ASCII mi, aynı @id'ye ikinci bir tam düğüm basılıyor mu, yalnız-@id referanslarının hedefi grafikte var mı ve eski, ayrı entity dosyaları hâlâ yayında mı? Her soru, önceki bölümlerde gördüğümüz tuzaklardan birine karşılık geliyor.
- Kimlik envanteri çıkarın. Ana sayfa, bir ürün ya da hizmet sayfası, bir blog yazısı ve ekip sayfasının kaynağında
"@id"geçen tüm değerleri listeleyin. Aynı varlık için protokol, www, sondaki eğik çizgi ya da Türkçe karakter farkıyla birden fazla varyant varsa kanonik olanı seçin ve diğerlerini ona çevirin. - Göreli kimlikleri ayıklayın.
#ile başlayan her @id, bulunduğu sayfanın adresine çözülür. Bunları tam adresle yazın. - Aynı kimlikli tam düğümleri sayın. Bir sayfada aynı @id ile birden fazla, ikiden çok alanlı düğüm varsa biri fazladır. Sayfanın JSON-LD'sini bir JSON-LD işlemcisinde düzleştirin:
nameya dajobTitlegibi tekil olması beklenen bir alan iki değerle dönüyorsa çelişki bulmuşsunuz demektir. - Referans hedeflerini doğrulayın. Yalnız-@id nesnesi, grafikte tam tanımı olan bir düğüme işaret etmelidir. Bunu görmek için sayfanın JSON-LD'sini bir JSON-LD işlemcisinde düzleştirin ve her yalnız-@id nesnesinin kimliğini, tam tanımlı düğümlerin kimlik listesinde arayın.
- Sitenin sunduğu tüm şema dosyalarını karşılaştırın.
/schema.json, eski entity dosyaları ya da ayrı SSS dosyaları gibi sayfa dışında servis edilen JSON-LD'yi kanonik kimliklerle karşılaştırın. Kullanılmayanı kaldırın ya da aynı @id'lere bağlayın.
Site içi tutarlılık işin yarısıdır. Aynı kurumun adresi, adı ve hizmetleri site dışındaki kanallarda da farklı yazılıyorsa grafik yine bölünür. Sheltron SME-Index bu nedenle tutarlılığı kaynak eşleşmesi ve AI yanıt doğruluğu üzerinden ölçüyor; ayrıntıları SME-Index sayfasında bulabilirsiniz. Şema kontrolünü düzenli bir izleme akışına bağlamak isteyen ekipler için AiSEO platformunun özellikleri arasında şema denetimi de yer alıyor.
Sitenizde kaç ayrı "şirket", kaç ayrı "yazar" dolaştığını merak ediyorsanız ilk adım bir ölçüm. Hızlı Değerlendirme formunu doldurun; kimlik tutarlılığından AI görünürlüğüne kadar sitenizin nerede durduğunu somut bulgularla birlikte paylaşalım.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Schema @id Nedir? Organization, WebSite ve Person'ı Tek Entity Grafiğinde Birleştirmek
- TL;DR
- Schema @id, aynı şirketi, kişiyi ya da siteyi her sayfada tek bir varlık olarak tanıtan URL biçimindeki kimliktir. RDF 1.1'e göre iki @id yalnız karakter karakter aynıysa eşittir; #eren-cop ile #eren-çöp iki ayrı kişidir. Eylül 2026'da sheltron.com.tr'nin 325 sayfasını taradık: 22 sayfada çift BreadcrumbList, 21 sayfada aynı @id'li ikinci Organization düğümü, 235 blog yazısının 222'sinde iki unvanlı yazar bulduk.
- Ana Çıkarımlar (7)
- @id, JSON-LD'de bir düğümün IRI biçimindeki kimliğidir; yalnız @id içeren nesne başka yerde tanımlı varlığa referanstır (W3C JSON-LD 1.1).
- RDF 1.1'e göre IRI eşitliği normalizasyonsuz, karakter karakter karşılaştırmadır: http/https, www, sondaki / ve Türkçe karakter farkı ayrı varlık yaratır.
- Göreli "#organization" her sayfada o sayfanın adresine çözülür; 100 sayfalık sitede 100 ayrı şirket demektir. @id her zaman mutlak URL olmalı.
- Aynı @id'ye ikinci tam düğüm basmak çelişkiyi silmez: düzleştirme sonrası iki unvan ya da iki ad aynı varlıkta yan yana birikir.
- Sheltron, çelişkili 3 Organization tanımını tek kaynağa indirdi; Ağustos 2026 itibarıyla kaynak kodda 33 noktadan yalnız @id ile referans veriyordu.
- Eylül 2026 taramasında 325 sayfada 1.447 JSON-LD bloğu ve 1.144 yalnız-@id referansı; 22 sayfada çift BreadcrumbList, 21 sayfada ikinci Organization düğümü bulundu.
- Google'ın AI özellikleri belgesine göre AI Overviews için özel şema gerekmez; @id bir görünürlük garantisi değil, varlık tutarlılığı aracıdır.
- Kaynaklı Veriler
- %41 — JSON-LD, 2024'te web sayfalarının %41'inde kullanılıyor (2022'de %34) (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %12,73 — WebSite, mobil sayfalarda en yaygın yapılandırılmış veri tipi (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %7,16 — Organization tipinin yer aldığı mobil sayfa oranı (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- 15,6 milyar — Ekim 2024 Common Crawl çıkarımında bulunan tiplenmiş entity sayısı (15.647.463.083) (Web Data Commons, Mannheim Üniversitesi, 2024)
- 30.1 — Eylül 2026 itibarıyla güncel schema.org sürümü (16 Eylül 2026) (schema.org, 2026)
- 33 — Ağustos 2026 itibarıyla Sheltron kaynak kodunda Organization'a yalnız @id ile referans verilen nokta sayısı (Sheltron SEO-GEO Playbook, Ağustos 2026, 2026)
- 1.144 — Eylül 2026 taramasında 325 sayfada sayılan yalnız-@id referansı (1.447 JSON-LD bloğu) (Sheltron ölçümü — sheltron.com.tr canlı JSON-LD taraması (Eylül 2026), 2026)
- 22 — Eylül 2026 taramasında çift BreadcrumbList taşıyan sheltron.com.tr sayfası (Ağustos 2026 iç değerlendirmesinde 9) (Sheltron ölçümü — sheltron.com.tr canlı JSON-LD taraması (Eylül 2026), 2026)
- 21 — Aynı #organization @id'siyle eksik alanlı ikinci Organization düğümü basan sayfa (Sheltron ölçümü — sheltron.com.tr canlı JSON-LD taraması (Eylül 2026), 2026)
- 222 — 235 blog yazısının 222'sinde aynı Person @id'si iki farklı jobTitle taşıyor (Sheltron ölçümü — sheltron.com.tr canlı JSON-LD taraması (Eylül 2026), 2026)
- Arama Niyetleri
- schema @id nedir
- json-ld @graph kullanımı
- çift organization schema sorunu
- @id url formatı nasıl olmalı
- entity graph json-ld
- json ld vs schema org
- json-ld @id türkçe karakter
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz