robots.txt'te AI Bot Kuralları: RFC 9309 Eşleşme Tuzağı, 2026 User-Agent Listesi ve Doğru Şablon
robots.txt'te AI botlarına kural yazarken RFC 9309'un grup eşleşmesi ve kural önceliği nasıl işler, yalnız Allow: / yazmak neden /admin ve /api yasaklarını kaldırır, Eylül 2026 itibarıyla hangi token hangi işi yapar ve kural nasıl doğrulanır.
💡Kısa Özet
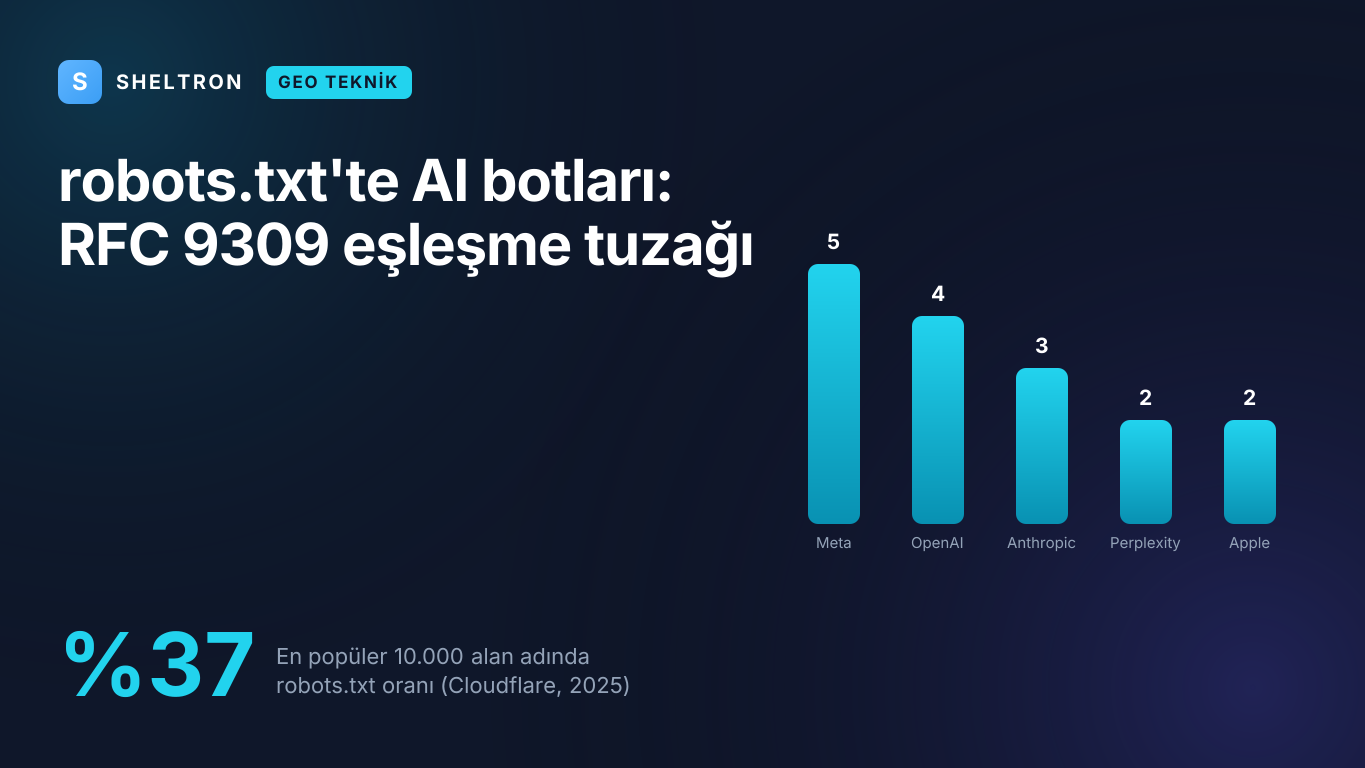
RFC 9309'a göre bir bot robots.txt'te kendi adını taşıyan grubu bulursa * grubunu okumaz; yalnız Allow: / yazılan AI bot grupları /admin ve /api yasaklarını o botlar için kaldırır. Sheltron'un kendi denetimi bu durumu 16 AI botunda tespit etti. Eylül 2026 itibarıyla OpenAI 4, Anthropic 3, Perplexity 2 token belgeliyor. Cloudflare'e göre en popüler 10.000 alan adının yalnız %37'sinde robots.txt var.
Ana Çıkarımlar
- •RFC 9309 ve Google spesifikasyonuna göre bota özel grup ile * grubu birleştirilmez; bot kendi grubunu bulursa * grubundaki yasakları okumaz.
- •Yalnız 'User-agent: GPTBot / Allow: /' yazmak /admin ve /api yasaklarını GPTBot için kaldırır; Sheltron'un kendi denetimi bu durumu 16 AI botunda tespit etti.
- •Aynı gruptaki çatışmada en uzun (en spesifik) kural kazanır; Allow: / tek karakterlik olduğu için altındaki Disallow: /api/ satırını geçersiz kılmaz.
- •Eylül 2026 itibarıyla OpenAI 4, Anthropic 3, Perplexity 2, Meta 5 token belgeliyor; eğitim botunu kapatmak arama botunu kapatmıyor.
- •anthropic-ai ve Claude-Web Anthropic'in güncel dokümanında yok; Claude eğitim taraması için kural ClaudeBot'a yazılmalı.
- •robots.txt 5xx dönerse RFC 9309 tam yasak, 4xx dönerse kısıt yok varsayar; WAF'ın yalnız robots.txt isteğine 403 döndürüp sayfaları açık bırakması tüm yasakları düşürebilir.
- •robots.txt değişikliğinin OpenAI ve Perplexity sistemlerine yansıması 24 saate kadar sürebilir; RFC önbellek için de 24 saat üst sınırı öneriyor.
robots.txt'te bir AI botu için açılan her User-agent grubu, o bot için sitenin genel * kurallarının yerine geçer: bot kendi grubunu bulduğunda * grubunu hiç okumaz. Grup yalnız Allow: / satırıyla kurulduğunda /admin ya da /api gibi yasaklar o bot için sessizce ortadan kalkar. Cloudflare'in Temmuz 2025'te yayımladığı ölçüme göre en popüler 10.000 alan adının yalnız yaklaşık %37'sinde robots.txt dosyası vardı ve bulunan dosyaların %7,8'i GPTBot'u engelliyordu (Cloudflare Blog, 2025). Kural yazan sitelerde ise asıl risk, engelleme kararının kendisinden çok yazılan kuralın botlar tarafından nasıl okunduğudur.
Bu okuma biçimini Eylül 2022'de yayımlanan RFC 9309 standart hâline getirdi. Aşağıda grup eşleşmesi ve kural önceliği, Eylül 2026 itibarıyla OpenAI, Anthropic, Perplexity, Google, Apple ve Meta'nın resmi dokümanlarında yer alan bot token'ları, kullanımdan kalkan adlar ve kendi sitenize uyarlayabileceğiniz iki şablon yer alıyor. Botları engelleyip engellememenin ekonomik tarafı ayrı bir konu; o tartışma için AI crawler ekonomisi analizimize bakabilirsiniz. Buradaki odak sözdizimi ve doğrulama.
robots.txt'te AI botlarına yazılan kural neden sitenin genel yasaklarını etkiler?
robots.txt kuralları gruplar hâlinde okunur ve her bot yalnız tek bir gruba uyar. RFC 9309'a göre bot kendi adını taşıyan grubu bulduğu anda * grubunu dikkate almaz. Bu yüzden bir AI botunu "açmak" için eklenen iki satır, sitenin genel yasaklarını o bot için geçersiz kılabilir.
robots.txt, 1994'te Martijn Koster'ın önerdiği gayriresmî bir kural olarak doğdu ve yaklaşık 28 yıl boyunca yazılı bir standarda dayanmadan uygulandı. RFC 9309 protokolü IETF standardına dönüştürdü; grup eşleşmesi, kural önceliği, hata kodları, önbellek süresi ve dosya boyutu sınırı o tarihten beri yazılı kurallara bağlı.
AI botları bu tabloya iki yeni karmaşıklık ekledi. İlki bot sayısı: tek bir sağlayıcı artık model eğitimi, arama indeksi ve kullanıcı isteği için ayrı token'lar kullanıyor. İkincisi dosyanın amacındaki değişim: robots.txt yalnız tarama yükünü yönetmek için değil, içeriğin model eğitiminde kullanılıp kullanılamayacağını beyan etmek için de kullanılıyor. Data Provenance Initiative'in 14.000 alan adını inceleyen çalışması, 2023-2024 döneminde C4 derlemindeki en aktif ve kritik kaynakların %28'inden fazlasının robots.txt ile tamamen kısıtlandığını ortaya koydu. Araştırmacılar bu protokolleri, internetin yapay zekâ için yeniden kullanılmasıyla başa çıkacak şekilde tasarlanmamış ve bu yüzden etkisiz kalan araçlar olarak niteliyor (Longpre ve ark., arXiv 2024).
Bu nedenle AI botlarına kural yazarken iki şeyi birlikte bilmek gerekiyor: hangi token'ın hangi işi yaptığını ve bu token'lar için açılan grupların * grubuyla nasıl etkileştiğini. Hatanın bedeli ikincisinde ortaya çıkıyor; Türkçe rehberlerde de rastlanan User-agent: GPTBot ve altında tek satır Allow: / kalıbı bu etkileşimi göz ardı ediyor.
robots.txt, üretken motor optimizasyonu (GEO) çalışmalarının en alt katmanıdır. Bot sayfaya erişemiyorsa yapılandırılmış veri, içerik ya da llms.txt üzerinde yapılan iş görünmez kalır; erişim yanlış yerden açıksa bu kez istemediğiniz yollar taranır. Teknik katmanların bütününü schema markup ve llms.txt altyapı rehberimizde ele aldık.
RFC 9309'a göre bir bot hangi grubu okur?
Bir bot, robots.txt'teki grupları kendi token'ıyla büyük-küçük harf ayırmadan karşılaştırır ve yalnız eşleşen grubun kurallarına uyar. Aynı bota ait birden fazla grup varsa bunlar birleştirilir. Hiç eşleşen grup yoksa bot * grubuna düşer. Bota özel grup ile * grubu ise hiçbir durumda birleştirilmez.
RFC 9309'un 2.2.1 bölümü kuralı açıkça koyuyor: crawler, token'ıyla eşleşen grubu büyük-küçük harf duyarsız biçimde bulmalı ve o grubun kurallarına uymalı; eşleşen grup yoksa * grubuna uymalıdır. Google'ın 31 Ağustos 2026'da güncellenen robots.txt spesifikasyonu aynı ilkeyi daha da net yazıyor: belirli bir crawler için yalnız bir grup geçerlidir, diğer gruplar yok sayılır ve "User agent specific groups and global groups (*) are not combined." Google'a göre grupların dosyadaki sırası da önemsiz; * grubunun en üstte ya da en altta olması sonucu değiştirmez.
Token yazımında iki ayrıntı sık karıştırılıyor. Birincisi sürüm numarası: botun HTTP isteğindeki kimlik dizesi GPTBot/1.4 gibi bir sürüm taşır, ama robots.txt'e yalnız GPTBot yazılır. Google da googlebot/1.2 ile googlebot ifadesini eşdeğer sayıyor. İkincisi karakter seti: RFC'ye göre token yalnız harf, alt çizgi ve tire içerebilir. Büyük-küçük harf ise önemli değil; gptbot ile GPTBot aynı grubu açar.
Aşağıdaki kısa dosyanın farklı botlar tarafından nasıl okunduğu, kuralın pratikteki etkisini gösteriyor:
User-agent: *
Disallow: /admin/
Disallow: /api/

User-agent: GPTBot
Allow: /

User-agent: Googlebot
Disallow: /arama/
| Bot | Okuduğu grup | /admin/ sonucu |
Neden |
|---|---|---|---|
| GPTBot | GPTBot grubu | Açık | Kendi grubunu buldu, * grubunu okumaz |
| OAI-SearchBot | * grubu |
Kapalı | Kendi adına grup yok |
| ClaudeBot | * grubu |
Kapalı | Kendi adına grup yok |
| Googlebot | Googlebot grubu | Açık | Kendi grubunda yalnız /arama/ yasak |
| Storebot-Google | * grubu |
Kapalı | Google: özel grubu yoksa * grubuna uyar |
| Applebot | Googlebot grubu | Açık | Apple: robots.txt Applebot'u anmıyorsa Googlebot kurallarına uyar |
Tablodaki son iki satır, kendi adına grubu olmayan botların her zaman aynı yere düşmediğini gösteriyor. Google'ın kendi örneğinde Storebot-Google, Googlebot grubuna değil * grubuna düşüyor. Apple'ın Applebot sayfası ise Eylül 2026 itibarıyla farklı bir davranış tarif ediyor: dosyada Applebot geçmiyor ama Googlebot geçiyorsa Applebot, Googlebot'un kurallarını izliyor. Googlebot'a özel bir kısıt yazdığınızda Apple'ın botunu da etkilemiş olursunuz.
Yalnız "Allow: /" yazmak neden /admin ve /api'yi açar?
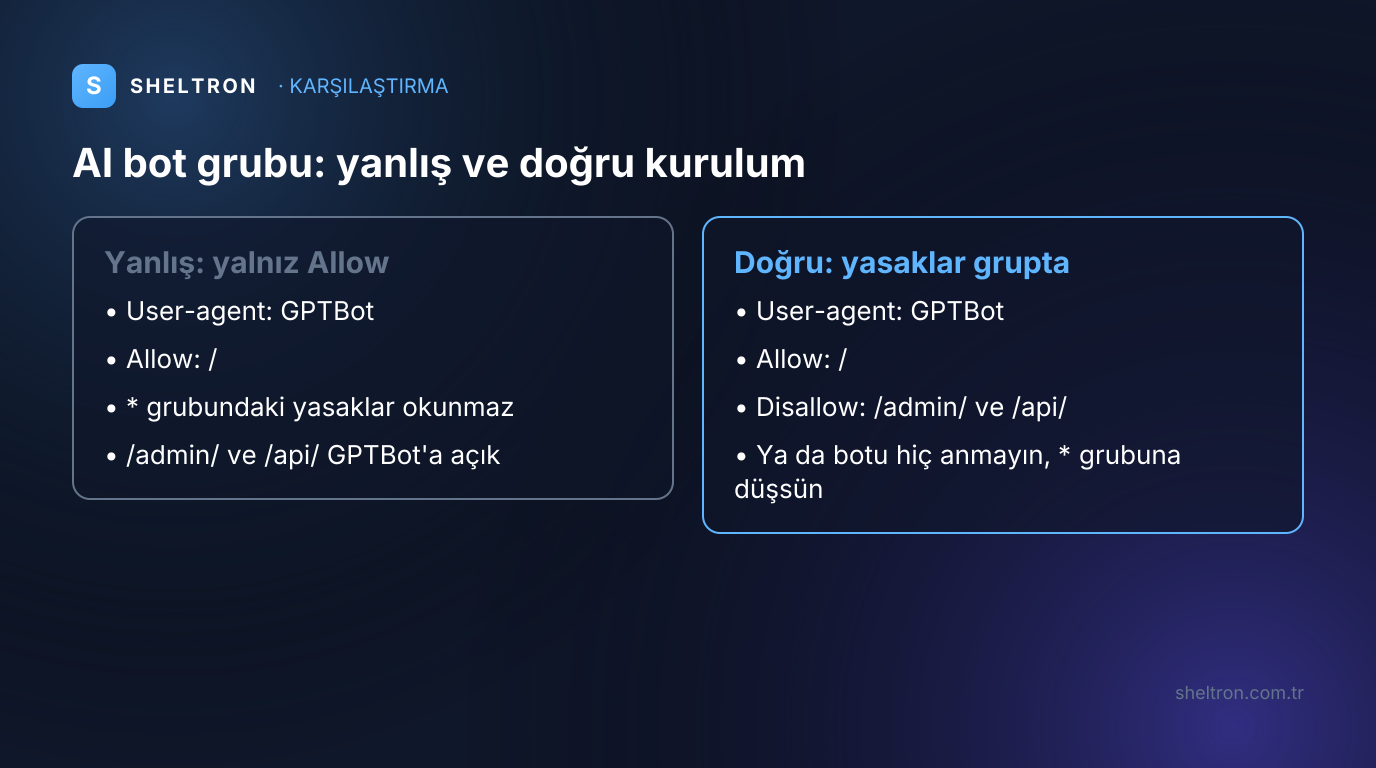
Tuzak Allow: / satırının kendisinde değil, bot grubunda disallow satırlarının bulunmamasında. Bot kendi grubunu bulduğu için * grubundaki yasakları hiç okumaz. Kendi grubunda da yasak yoksa, RFC 9309'a göre hiçbir kuralla eşleşmeyen her yol izinlidir. Sonuçta /admin ve /api o bot için açık kalır.
Aşağıdaki kalıp, bot listesi veren rehberlerde "AI botlarına izin verme" şablonu olarak karşımıza çıkıyor:
User-agent: *
Disallow: /admin/
Disallow: /api/

User-agent: GPTBot
Allow: /
Site sahibinin niyeti GPTBot'un içerik sayfalarını taramasına izin vermek. Fiilen ortaya çıkan durum ise GPTBot için /admin/ ve /api/ yasaklarının hiç var olmaması. Aynı kalıp ClaudeBot, PerplexityBot ve diğer botlar için çoğaltıldığında, sitenin genel yasakları yalnız hiç anılmayan botlar için geçerli kalıyor.
Bu hata teorik bir örnek değil. Sheltron'un kendi sitesinde yürüttüğü teknik denetim, 16 AI botu için yalnız Allow: / yazıldığını ve bu yüzden /api, /admin ve /studio yasaklarının bu botlar için geçersiz kaldığını tespit etti. Düzeltmede yasak listesi tek bir dizide tutuldu ve kod her bot grubuna aynı listeyi yazacak biçimde değiştirildi. Eylül 2026 itibarıyla sitenin robots.txt dosyasını üreten kod 18 grup yazıyor: bir * grubu ve 17 bot grubu. Kod her gruba aynı dört yasağı (/api/, /admin/, /private/, /studio/) tek bir listeden ekliyor.
Doğru kurulum için üç seçenek var:
Seçenek A: Yasakları her gruba kopyalamak. Sheltron'un kullandığı yöntem budur. Her bot grubu Allow: / satırının altında aynı disallow listesini taşır. Dosya uzar, ama listeyi koddan tek bir kaynaktan ürettiğinizde gruplar arasında kayma oluşmaz.
User-agent: GPTBot
Allow: /
Disallow: /api/
Disallow: /admin/
Disallow: /private/
Disallow: /studio/
Seçenek B: Botları tek grupta toplamak. Art arda yazılan User-agent satırları tek bir grup oluşturur. Aynı kuralı alacak botları alt alta sıralayıp yasakları bir kez yazmak hem kısa hem de bakımı kolay bir yoldur.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /admin/
Disallow: /api/
Seçenek C: Botu hiç anmamak. Bir bota * grubundan farklı bir kural vermiyorsanız, onun adına grup açmanıza gerek yok; bot zaten * grubuna düşer. En sade ve hataya en kapalı yol budur. Sheltron'un 17 bot grubu da * grubuyla aynı kuralları taşıdığı için işlevsel olarak bu seçenekle aynı sonucu veriyor; grupların değeri, hangi botların bilinçli olarak karşılandığını dosyayı okuyan herkese göstermesi.
Allow ve Disallow çatıştığında hangisi kazanır?
Aynı grup içinde bir URL'ye birden fazla kural uyuyorsa en çok karakter içeren, yani en spesifik kural kazanır. Allow ve Disallow eşit uzunluktaysa RFC 9309 Allow'un seçilmesini önerir; Google da çatışmada en az kısıtlayıcı kuralı uygular. Hiçbir kural eşleşmezse URL izinli sayılır.
RFC 9309'un 2.2.2 bölümü "en spesifik eşleşme"yi en çok okteti, pratikte en çok karakteri olan eşleşme olarak tanımlıyor. Bu yüzden Allow: / ile başlayan bir grup, altındaki disallow satırlarını geçersiz kılmaz: / tek karakterlik bir eşleşmedir, /api/ ise beş karakterlik. Seçenek A'daki "Allow: / ve ardından yasak listesi" kalıbı bu sayede doğru çalışır. Kısacası sorun hiçbir zaman Allow satırında değil, yasakların gruba taşınmamasındadır.
| Gruptaki kurallar | İstenen URL | Sonuç | Neden |
|---|---|---|---|
Allow: / + Disallow: /api/ |
/api/siparis |
Engelli | /api/ (5 karakter) / (1 karakter) kuralından uzun |
Disallow: /blog/ + Allow: /blog/rehber/ |
/blog/rehber/robots |
İzinli | Allow kuralı daha uzun |
Disallow: /blog/ + Allow: /blog/rehber/ |
/blog/haber/ |
Engelli | Yalnız Disallow eşleşiyor |
Disallow: /Admin/ |
/admin/ |
İzinli | Yol eşleşmesi büyük-küçük harfe duyarlı |
Yalnız Allow: / |
/admin/ |
İzinli | Hiçbir yasak eşleşmiyor |
Disallow: / |
/robots.txt |
İzinli | RFC: /robots.txt her zaman izinlidir |
Tablodaki dördüncü satır, özellikle büyük harfli dizin adları kullanan sitelerde dikkat ister. RFC 9309 bot adının eşleşmesini büyük-küçük harfe duyarsız tutarken yol eşleşmesinin duyarlı olmasını öneriyor. /Admin/ yazıp /admin/ adresini korumayı beklemek sık yapılan bir hata.
Google ayrıca * ve $ joker karakterlerini destekliyor: Disallow: /*.pdf$ gibi bir satır, adresi .pdf ile biten tüm yolları kapsar. Karmaşık desenlerde sonucu tahmin etmek yerine son bölümdeki eşleştiriciyle test edin.
Grup dışında kalan kurallar da ayrı bir tuzaktır. RFC 9309'a göre dosyanın başında, ilk User-agent satırından önce yazılmış allow ya da disallow satırları hiçbir gruba ait değildir ve yok sayılmalıdır. "Genel kural" diye en üste yazılan satırlar bu yüzden hiçbir bota uygulanmayabilir; genel kurallar her zaman User-agent: * satırının altına yazılmalıdır.
Eylül 2026 itibarıyla hangi AI botu hangi işi yapıyor?
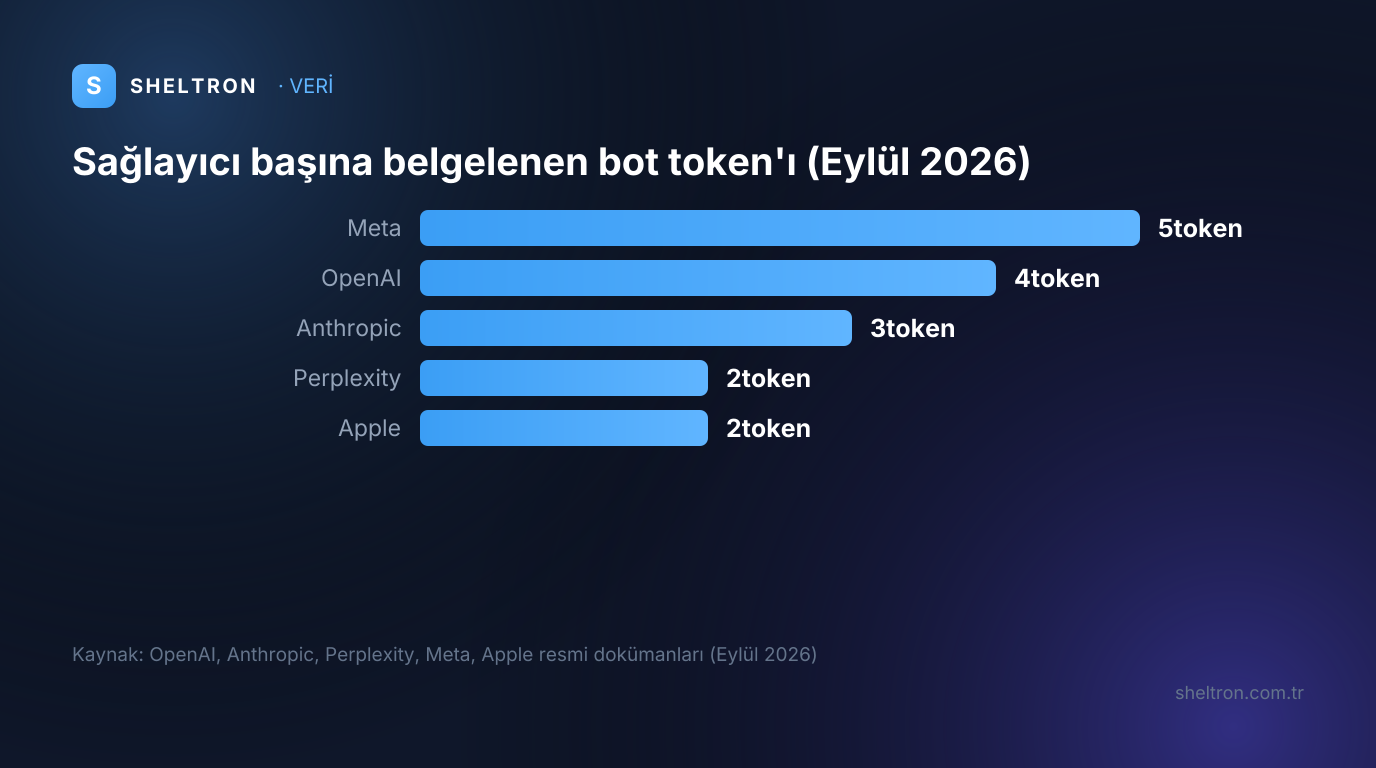
Büyük sağlayıcılar botlarını üç role ayırıyor: model eğitimi için veri toplayan botlar, AI aramasının indeksini oluşturan botlar ve bir kullanıcının isteğiyle sayfayı anlık getiren fetcher'lar. Eylül 2026 itibarıyla OpenAI dört, Anthropic üç, Perplexity iki token belgeliyor. Eğitim botunu kapatmak arama botunu kapatmıyor.
Aşağıdaki tablo yalnız sağlayıcıların kendi resmi dokümanlarına dayanıyor. OpenAI ve Perplexity sayfaları tarih taşımadığı için tablo, Eylül 2026'da erişilen sürümleri yansıtıyor; yayın tarihine kadar yeni bir token eklenmesi ya da tanımların değişmesi mümkün.
| Sağlayıcı | Eğitim | Arama / indeks | Kullanıcı isteğiyle getirme | robots.txt notu |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | ChatGPT-User için kurallar "uygulanmayabilir"; ayrıca reklam doğrulaması için OAI-AdsBot |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | Üçü de robots.txt'e uyuyor; Crawl-delay destekleniyor |
| Perplexity | Yok (Perplexity: iki bot da model eğitimi için tarama yapmıyor) | PerplexityBot | Perplexity-User | Perplexity-User robots.txt'i "genellikle yok sayıyor" |
| Google-Extended (kontrol token'ı) | Googlebot | Bu rehberde ele alınmadı | Google-Extended'ın ayrı bir tarayıcısı yok | |
| Apple | Applebot-Extended (tarama yapmaz) | Applebot | Belgelenmemiş | Applebot anılmıyorsa Googlebot kurallarına uyar |
| Meta | Meta-ExternalAgent | Meta-WebIndexer | Meta-ExternalFetcher | Fetcher robots.txt'i atlayabiliyor |
| Common Crawl | CCBot | Yok | Yok | User-agent: CCBot ile engelleniyor |
OpenAI'ın dokümanı, dört ayarın birbirinden bağımsız olduğunu açıkça yazıyor: bir site OAI-SearchBot'a izin verip GPTBot'u engelleyebilir. ChatGPT-User, ChatGPT ve özel GPT'lerde kullanıcının başlattığı eylemler için çalışır; OAI-AdsBot ise ChatGPT'de reklam olarak gönderilen sayfaların güvenlik doğrulamasını yapar. OAI-SearchBot ile ChatGPT aramasının kaynak seçimi arasındaki ilişkiyi ChatGPT Search ve Bing Copilot karşılaştırmamızda ayrıntılı işledik.
Anthropic'in 7 Nisan 2026'da güncellenen sayfası üç botu ayırıyor ve iki önemli uyarı içeriyor: Claude-SearchBot'u kapatmak sitenin kullanıcı aramalarındaki görünürlüğünü ve doğruluğunu, Claude-User'ı kapatmak ise kullanıcı yönlendirmeli web aramasındaki görünürlüğünü azaltabilir. Perplexity tarafında PerplexityBot, Perplexity arama sonuçlarında siteleri göstermek ve bağlantı vermek için çalışıyor; Perplexity, iki botunun da model eğitimi için veri toplamadığını belirtiyor. Perplexity'de kaynak olarak öne çıkmanın içerik tarafını Perplexity rehberimizde anlattık.
Google-Extended ve Applebot-Extended ise tarama yapmayan kontrol token'ları. Google'a göre Google-Extended'ın ayrı bir HTTP kimliği yok; tarama mevcut Google tarayıcılarıyla yapılıyor ve token yalnız içeriğin Gemini modellerinin eğitiminde ve Gemini Apps ile Vertex AI'daki yanıt dayandırmada (grounding) kullanılıp kullanılmayacağını belirliyor. Google, bu token'ın sitenin Google Search'e dahil olmasını etkilemediğini ve sıralama sinyali olmadığını yazıyor. AI Overviews hakkında bu sayfada ayrı bir ifade yok; AI Overviews'un kaynak seçimini ayrı bir rehberde ele aldık. Apple da Applebot-Extended'ın sayfa taramadığını, yalnız Applebot'un topladığı verinin nasıl kullanılacağını belirlediğini ve bu token'ı engelleyen sayfaların arama sonuçlarında yer almaya devam edebileceğini belirtiyor.
Meta'nın dokümanı beş token listeliyor: Meta-ExternalAgent, Meta-WebIndexer, Meta-ExternalAds, Meta-ExternalFetcher ve FacebookExternalHit. Microsoft ise yapay zekâ yanıtları için ayrı bir user-agent tanımlamıyor; Eylül 2023 duyurusu kontrolü o dönemki adıyla Bing Chat, bugünkü adıyla Copilot için nocache ve noarchive meta etiketlerine bırakıyor.
Bytespider, cohere-ai, Diffbot ve YouBot gibi sık görülen token'ların resmi dokümanları bu rehber için doğrulanmadığından tabloya alınmadı; bunlar için sağlayıcının güncel belgesine bakın.
Hangi token'lar eskidi, hangi botlar robots.txt'i atlayabilir?
Anthropic'in güncel dokümanı yalnız ClaudeBot, Claude-SearchBot ve Claude-User'ı listeliyor; anthropic-ai ve Claude-Web artık bu sayfada geçmiyor. Bu yüzden eski adlara yazılan kurallar güncel botları durdurmaz. Kullanıcı isteğiyle çalışan fetcher'lardan Perplexity-User robots.txt'i genellikle yok sayıyor, ChatGPT-User için kurallar uygulanmayabiliyor. robots.txt bir erişim yetkilendirmesi değil, bir beyandır.
Eski Anthropic token'ları Temmuz 2025'te hâlâ bazı robots.txt dosyalarında yer alıyordu. Cloudflare'in Temmuz 2025 ölçümünde anthropic-ai, PerplexityBot, ClaudeBot ve Bytespider'ın her biri, bulunan robots.txt dosyalarının %5'inden azında geçiyordu; Google-Extended ise %5,6'sında. Search Engine Journal'ın 25 Şubat 2026 tarihli haberine göre Claude-Web ve anthropic-ai kullanımdan kalktı. Anthropic'in kendi sayfası bu adları hiç anmıyor. Pratik sonuç şu: Claude'un eğitim taramasını durdurmak istiyorsanız kuralı ClaudeBot için yazmalısınız. Eski satırları dosyada bırakmak zarar vermez, ama tek başına beklenen etkiyi de sağlamaz.
İkinci konu, robots.txt'in kapsamının sınırı. RFC 9309 bu sınırı açıkça çiziyor: kurallar "bir erişim yetkilendirmesi biçimi değildir." Sağlayıcıların kendi belgeleri de kullanıcı isteğiyle çalışan fetcher'lar için istisnalar tanımlıyor:
- ChatGPT-User: OpenAI, eylemleri kullanıcı başlattığı için robots.txt kurallarının uygulanmayabileceğini yazıyor.
- Perplexity-User: Perplexity bu fetcher'ın robots.txt kurallarını genellikle yok saydığını belirtiyor.
- Meta-ExternalFetcher: Meta, kullanıcının isteğiyle tek tek bağlantı getiren bu aracın robots.txt kurallarını atlayabileceğini söylüyor. FacebookExternalHit de güvenlik ve bütünlük kontrollerinde robots.txt'i atlayabiliyor.
- Claude-User: Anthropic ise bu botun da robots.txt yönergelerine uyduğunu belirtiyor; bu açıdan diğer fetcher'lardan ayrışıyor.
Bu yüzden robots.txt, "iyi niyetli botlara isteğinizi bildirme" aracı olarak düşünülmeli. Gerçek erişim kontrolü kimlik doğrulama, WAF ve CDN katmanında yapılır. Bir isteğin gerçekten iddia ettiği bottan gelip gelmediğini görmek için sağlayıcılar IP listeleri yayımlıyor: OpenAI her bot için ayrı bir JSON dosyası (ör. openai.com/gptbot.json), Anthropic claude.com/crawling/bots.json, Perplexity perplexity.com/perplexitybot.json yayımlıyor; Common Crawl ise CCBot'u ters DNS ile doğrulanabilen ayrı IP aralıklarından çalıştırıyor. Anthropic'in bir uyarısı burada önemli: IP engellemesi, botun robots.txt dosyanızı okumasını da engelleyebileceği için güvenilir bir yöntem değil. WAF ve altyapı kararlarını AI arama altyapısı yazımızda, Cloudflare'in ücretli tarama modelini ise pay-per-crawl analizimizde inceledik.
Yeni bir standart da yolda, ama henüz standart değil. IETF'in AIPREF çalışma grubu, robots.txt'e Content-Usage adlı bir satır ekleyerek içeriğin eğitim ya da arama amacıyla kullanımına dair tercihleri ifade etmeyi öneriyor. Eylül 2026 itibarıyla sözlük taslağı 08. revizyonda (14 Eylül 2026), robots.txt eki taslağı 05. revizyonda (19 Ağustos 2026). İkisi de RFC değil ve sağlayıcıların bu satırı okuyup okumadığı bu rehber için doğrulanmadı. Taslakları izlemek mantıklı, ama Eylül 2026 itibarıyla engelleme ve izinleri bu satıra emanet etmemek gerekir.
Eğitim kapalı, AI araması açık bir robots.txt nasıl yazılır?
En güvenli yol, farklı kural alacak botları tek grupta art arda User-agent satırlarıyla toplamak, * grubundaki yasaklardan hangilerinin onlar için de geçerli olacağına bilinçli karar vermek ve Sitemap satırlarını dosyanın en sonuna koymaktır. Kuralı * ile aynı olan botları hiç anmamak dosyayı kısaltır ve tuzağı ortadan kaldırır.
Şablon 1: Tüm AI botları açık, yönetim yolları kapalı. Botları tek tek anmaya gerek yok. Hepsi * grubuna düşer ve aynı yasakları alır.
User-agent: *
Disallow: /admin/
Disallow: /api/

Sitemap: https://ornek.com.tr/sitemap.xml
Şablon 2: Eğitim kapalı, AI araması ve klasik arama açık.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: Meta-ExternalAgent
User-agent: CCBot
Disallow: /

User-agent: *
Disallow: /admin/
Disallow: /api/

Sitemap: https://ornek.com.tr/sitemap.xml
Bu dosyada OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot ve Applebot kendi adlarına grup bulamadığı için * grubuna düşer; içerik sayfalarını tarayabilir, yönetim yollarına giremezler. Eğitim grubundaki Disallow: / zaten her şeyi kapattığı için /admin/ ve /api/ satırlarını o gruba ayrıca yazmanız gerekmez. Bir bota kısmi izin vereceğiniz her durumda ise yasak listesini o gruba da eklemelisiniz.
Şablonu uyarlarken dikkat edilmesi gereken beş ayrıntı var:
- Sitemap satırlarını en sona koyun. Google'ın spesifikasyonuna göre allow, disallow ve user-agent dışındaki satırlar grup yapısını bölmez.
User-agent: a, ardındanSitemap:, ardındanUser-agent: bveDisallow: /yazılan bir dosyada a da engellenir. - Googlebot'a özel grup açarsanız Applebot'u da düşünün. Applebot kendi adını bulamazsa o gruba uyar. Farklı davranmasını istiyorsanız Applebot için ayrı grup yazın.
- Her alt alan adının kendi robots.txt dosyası vardır. Anthropic, botu engellemek istediğiniz her alt alan adında bu işlemin ayrıca yapılması gerektiğini hatırlatıyor.
- Crawl-delay'e güvenmeyin. Anthropic bu standart dışı satırı destekliyor, ama Google ve Applebot desteklemiyor.
- Google-Extended'ı kapatmanın bedelini doğru tartın. Google'a göre Search görünürlüğünüz değişmez; etkilenen, Gemini tarafındaki eğitim ve yanıt dayandırma kullanımıdır.
robots.txt ile llms.txt'i de birbirine karıştırmamak gerekiyor. robots.txt botlara hangi yolları tarayabileceklerini söyler; llms.txt ise dil modellerine sitenin önemli içeriklerini özetleyen bir dizin sunar ve erişim izni vermez. Aradaki farkı llms.txt rehberimizde, dosyanın gerçek etkisine dair verileri llms.txt gerçeği yazımızda bulabilirsiniz. Dosyayı sıfırdan oluşturmak için Sheltron'un ücretsiz llms.txt üreticisini kullanabilirsiniz.
robots.txt kuralının gerçekten çalıştığı nasıl doğrulanır?
Dört kontrol çoğu hatayı yakalar: dosyanın HTTP 200 ve düz metin olarak döndüğünü görmek, boyutun 500 KiB sınırının altında kaldığını doğrulamak, kritik bot ve URL çiftlerini Google'ın açık kaynak eşleştiricisiyle test etmek ve değişikliğin botlara yansıması için yaklaşık 24 saat beklemek.
1. HTTP durum kodu. Botun robots.txt'i nasıl yorumlayacağı önce sunucunun verdiği yanıta bağlı. RFC 9309 ve Google'ın spesifikasyonu farklı durum kodlarını şöyle ele alıyor:
| robots.txt yanıtı | RFC 9309 | |
|---|---|---|
| 2xx | Kurallar okunur ve uygulanır | Kurallar okunur ve uygulanır |
| 3xx | En az 5 ardışık yönlendirme izlenmeli; fazlasında dosya erişilemez sayılabilir | En az 5 yönlendirme izlenir; sonrasında robots.txt 404 sayılır (yani kısıt yok) |
| 4xx | Crawler sunucudaki her kaynağa erişebilir | robots.txt yokmuş gibi davranılır (429 bu kuralın dışında) |
| 5xx veya ağ hatası | Tam yasak varsayılmalı | İlk 12 saat tarama durur, sonraki 30 gün son iyi sürüm kullanılır |
Pratik sonuç: 5xx tam yasak, 4xx kısıt yok anlamına gelir. WAF'ın yalnız robots.txt isteğine 403 döndürüp sayfaları açık bırakması, RFC 9309'a göre tüm yasakların düşmesine yol açabilir. curl -sI https://ornek.com.tr/robots.txt komutuyla durum kodunu ve text/plain içerik türünü kontrol edin; testi bir bot kimlik dizesiyle de tekrarlayın.
2. Boyut ve biçim. RFC 9309 crawler'ların en az 500 kibibaytı ayrıştırmasını şart koşuyor; Google da 500 KiB'tan sonrasını yok sayıyor. Yüzlerce satırlık otomatik üretilmiş dosyalarda son satırlardaki kurallar okunmayabilir.
3. Bot ve URL testi. Google'ın üretimde kullandığı ayrıştırıcının hafifçe değiştirilmiş hâli google/robotstxt deposunda açık kaynak olarak yayımlanıyor. bazel run robots_main -- robots.txt GPTBot https://ornek.com.tr/admin/ gibi bir komut, verdiğiniz bot ve URL için sonucu ALLOWED ya da DISALLOWED olarak yazar. Her kritik yol (/admin/, /api/, ödeme ve hesap sayfaları) için en az bir eğitim botuyla ve bir arama botuyla test yapmak, grup eşleşmesi tuzağını yayına çıkmadan yakalar.
4. Yansıma süresi. RFC 9309, önbellekteki robots.txt'in 24 saatten uzun kullanılmamasını öneriyor; Google önbelleği 24 saate kadar tutuyor. OpenAI değişikliğin sistemlerine yansımasının yaklaşık 24 saat, Perplexity ise 24 saate kadar sürebileceğini belirtiyor. Değişikliğin etkisini ertesi günün sunucu günlüklerinde kontrol etmek bu yüzden daha anlamlı.
İlk tarama için Sheltron'un ücretsiz robots.txt AI Bot Kontrolü aracı, hangi AI botlarının Disallow: / ile tamamen kapatıldığını hızlıca gösterir. Araç, grup eşleşmesinden kaynaklanan kısmi açıklıkları ayrıca raporlamıyor. Aracın önerdiği düzeltme satırı yalnız Allow: / içerir; sitenizin * grubunda yasaklar varsa bunları o gruba da kopyalayın. Sheltron'un Search Console verisine göre araç sayfası 9 Ağustos 2026'ya kadarki 12 ayda 221 gösterim ve 6 tık aldı; siteyi gösteren 11 bot ve robots.txt sorgusunun 4'ünde "official" kelimesi geçiyor. Başvuru tablosunun yalnız sağlayıcı belgelerine dayanmasının nedeni bu. Diğer ücretsiz kontroller araç seti rehberimizde, terim tanımları GEO terimleri sözlüğünde yer alıyor. Konunun araştırma boyutu için The GEO Authority, eğitim içerikleri için GEO Akademi de iyi birer başlangıç noktası.
robots.txt dosyanız, AI botlarına sitenizle ilgili verdiğiniz ilk ve en kısa talimattır; bir satırlık bir hata, yıllarca fark edilmeden kalabilir. Bot erişiminin yanında llms.txt ve yapılandırılmış veri katmanlarınızın AI yanıtlarındaki görünürlüğünüzü nasıl etkilediğini birlikte görmek isterseniz hızlı değerlendirme formunu doldurun; sitenize özgü bulguları ve öncelik sırasını birlikte netleştirelim.
Uygulamayı bir ajansla yürütmek isterseniz partner GEO ajansımız Lein Digital destek veriyor.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- robots.txt'te AI Bot Kuralları: RFC 9309 Eşleşme Tuzağı, 2026 User-Agent Listesi ve Doğru Şablon
- TL;DR
- RFC 9309'a göre bir bot robots.txt'te kendi adını taşıyan grubu bulursa * grubunu okumaz; yalnız Allow: / yazılan AI bot grupları /admin ve /api yasaklarını o botlar için kaldırır. Sheltron'un kendi denetimi bu durumu 16 AI botunda tespit etti. Eylül 2026 itibarıyla OpenAI 4, Anthropic 3, Perplexity 2 token belgeliyor. Cloudflare'e göre en popüler 10.000 alan adının yalnız %37'sinde robots.txt var.
- Ana Çıkarımlar (7)
- RFC 9309 ve Google spesifikasyonuna göre bota özel grup ile * grubu birleştirilmez; bot kendi grubunu bulursa * grubundaki yasakları okumaz.
- Yalnız 'User-agent: GPTBot / Allow: /' yazmak /admin ve /api yasaklarını GPTBot için kaldırır; Sheltron'un kendi denetimi bu durumu 16 AI botunda tespit etti.
- Aynı gruptaki çatışmada en uzun (en spesifik) kural kazanır; Allow: / tek karakterlik olduğu için altındaki Disallow: /api/ satırını geçersiz kılmaz.
- Eylül 2026 itibarıyla OpenAI 4, Anthropic 3, Perplexity 2, Meta 5 token belgeliyor; eğitim botunu kapatmak arama botunu kapatmıyor.
- anthropic-ai ve Claude-Web Anthropic'in güncel dokümanında yok; Claude eğitim taraması için kural ClaudeBot'a yazılmalı.
- robots.txt 5xx dönerse RFC 9309 tam yasak, 4xx dönerse kısıt yok varsayar; WAF'ın yalnız robots.txt isteğine 403 döndürüp sayfaları açık bırakması tüm yasakları düşürebilir.
- robots.txt değişikliğinin OpenAI ve Perplexity sistemlerine yansıması 24 saate kadar sürebilir; RFC önbellek için de 24 saat üst sınırı öneriyor.
- Kaynaklı Veriler
- %37 — Temmuz 2025'te en popüler 10.000 alan adının yalnız yaklaşık %37'sinde robots.txt dosyası vardı (Cloudflare Blog, 2025)
- %7,8 — Bu alan adlarında bulunan robots.txt dosyalarının %7,8'i GPTBot'u engelliyordu (Cloudflare Blog, 2025)
- %5,6 — Aynı robots.txt dosyalarının %5,6'sında Google-Extended geçiyordu; anthropic-ai, PerplexityBot, ClaudeBot ve Bytespider her biri %5'in altındaydı (Cloudflare Blog, 2025)
- %28 — 14.000 alan adını inceleyen çalışmaya göre 2023-2024'te C4 derlemindeki en kritik kaynakların %28'inden fazlası robots.txt ile tamamen kısıtlandı (Longpre ve ark., Consent in Crisis (arXiv 2407.14933), 2024)
- 16 AI botu — Sheltron verisi: sitenin teknik denetimi 16 AI botu için yalnız Allow: / yazıldığını ve /api, /admin, /studio yasaklarının bu botlar için geçersiz olduğunu tespit etti (Sheltron verisi — SEO-GEO Playbook §02 teknik denetimi (Ağustos 2026), 2026)
- 18 grup — Eylül 2026 itibarıyla sheltron.com.tr robots.txt dosyasını üreten kod bir * grubu ve 17 bot grubu yazıyor; her gruba aynı dört yasak (/api/, /admin/, /private/, /studio/) ekleniyor (Sheltron — sitenin robots.txt üreten kaynak kodu (Eylül 2026 incelemesi), 2026)
- 500 KiB — RFC 9309'a göre crawler'lar robots.txt'in en az 500 kibibaytını ayrıştırmalı; Google bu sınırdan sonrasını yok sayıyor (IETF RFC 9309 / Google Search Central, 2022)
- 24 saat — OpenAI robots.txt değişikliğinin sistemlerine yansımasının yaklaşık 24 saat sürebileceğini belirtiyor (OpenAI — Overview of OpenAI Crawlers, 2026)
- 12 saat — robots.txt 5xx döndürürse Google ilk 12 saat taramayı durduruyor, sonraki 30 gün son iyi sürümü kullanıyor (Google Search Central — robots.txt specification, 2026)
- 5 yönlendirme — RFC 9309'a göre crawler robots.txt için en az 5 ardışık yönlendirmeyi izlemeli (IETF RFC 9309, 2022)
- 221 gösterim — Sheltron verisi: robots.txt AI Bot Kontrolü sayfası 9 Ağustos 2026'ya kadarki 12 ayda 221 gösterim ve 6 tık aldı (Sheltron / Google Search Console, 2026)
- 08 — Eylül 2026 itibarıyla IETF AIPREF sözlük taslağı 08. revizyonda (14 Eylül 2026) ve henüz RFC değil (IETF Datatracker — draft-ietf-aipref-vocab, 2026)
- Arama Niyetleri
- robots.txt ai bot kuralları
- ai bot user agent listesi
- claudebot claude-searchbot robots.txt
- perplexitybot robots.txt
- gptbot oai-searchbot chatgpt-user farkı
- google-extended nedir
- rfc 9309 robots.txt
- robots.txt allow disallow önceliği
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz