
Prompt Araştırması Nasıl Yapılır? Anahtar Kelimeden Yapay Zekâya Sorulan Sorulara Geçiş
Yapay zekâya sorulan soruları bulmanın adım adım yolu: Search Console'da Türkçe uyumlu regex filtreleri, Bing ve Clarity grounding sorguları, niyet kümeleri, 20–40 prompt'luk sabit set ve test döngüsü.
💡Kısa Özet
ChatGPT prompt'larının %65–85'i hiçbir anahtar kelimeyle eşleşmiyor (Semrush, 2026). Prompt araştırması bu soruları Search Console regex filtreleri, Bing ve Clarity grounding sorguları ve destek kayıtlarıyla toplar, niyete göre gruplar ve 20–40 prompt'luk sabit bir sete çevirir. Türkçe desenlerde \b kullanılmamalı: Sheltron'un Search Console verisinde \b'li soru eki deseni 7, boşluk tabanlı desen 22 sorgu yakaladı.
Ana Çıkarımlar
- •Semrush'a göre (2026) ChatGPT prompt'larının %65–85'i hiçbir geleneksel anahtar kelimeyle eşleşmiyor; prompt araştırması hacim tablosundan değil, sorulan sorulardan başlar.
- •Search Console'un Üretken AI performans raporunda sorgu boyutu yok; prompt keşfi klasik Performans raporundaki regex filtreleriyle yapılır.
- •Search Console bir sorgunun insan, yapay zekâ yüzeyi ya da izleme aracı kaynaklı olduğunu etiketlemez; Sheltron verisinde 8 ve üzeri kelimeli sorguların tamamı 0 tık aldı, bu yüzden bu sorgular kanıt değil, prompt setine aday olarak ele alınmalı.
- •RE2'de \b yalnız ASCII sınırını tanır: aynı veride \b'li desen 7, boşluk tabanlı desen 22 Türkçe soru ekli sorgu yakaladı.
- •Aynı ihtiyacı yazan 142 kişinin prompt'ları arasındaki anlamsal benzerlik 0,081 (SparkToro, 2026); bu yüzden tekil cümle değil, niyet kümesi izlenir.
- •Başlangıç seti 20–40 prompt olmalı, en az 30 gün değiştirilmeden izlenmeli ve 30–60 günde bir sürüm numarasıyla revize edilmelidir.
- •Copilot grounding sorguları ortalama 6,43 kelime (Sheltron Clarity verisi); kullanıcı dili ve motor dili sette ayrı sütunlarda tutulmalı.
Prompt araştırması, anahtar kelime listesinden değil, yapay zekâya sorulan sorulardan başlar. Semrush'ın 1 milyar satırı aşan ABD clickstream analizine (Nisan 2026) göre ChatGPT prompt'larının %65–85'i, çalışma döneminin büyük bölümünde 27 milyar anahtar kelimelik veri tabanındaki hiçbir geleneksel anahtar kelimeyle eşleşmedi. Hacim tablosuna bakarak kurulan bir içerik planı, bu soruların büyük kısmını hiç görmez.
Prompt araştırması; hedef kitlenizin ChatGPT, Gemini, Copilot ve Google AI Mode'a sorduğu soruları toplamak, niyete göre gruplamak ve düzenli test edilecek sabit bir set hâline getirmektir. Yapay zekâ ile SEO rehberimiz stratejinin genel çerçevesini anlatır. Bu yazı ise o stratejinin girdisini üreten tek bir işi adım adım gösterir: Search Console'daki uzun sorgulardan, Bing ve Clarity'deki grounding sorgularından, destek ve satış kayıtlarından izlenecek prompt setini çıkarmak. Örneklerde sheltron.com.tr'nin 9 Ağustos 2026 tarihli Search Console export'u ve Clarity verisi kullanıldı; rakamlar dosyalardan birebir alındı.
Prompt araştırması nedir, anahtar kelime araştırmasından farkı ne?
Prompt araştırması, yapay zekâ asistanlarına sektörünüzde sorulan soruları bulup niyet kümelerine ayırma ve bu kümeleri temsil eden sabit bir prompt setini düzenli olarak test etme işidir. Anahtar kelime araştırması kısa ve hacimli ifadeleri bulur; prompt araştırması ise uzun, bağlamlı ve kişisel soruları bulur.
Uzunluk farkı ölçülmüş durumda. Google'ın Mayıs 2026'da yayımladığı AI Mode kullanım analizine göre ortalama bir AI Mode araması, klasik bir Google aramasının üç katı uzunluğunda. Girişte andığımız Semrush çalışmasında ise web aramasını tetikleyen ChatGPT prompt'larının ortalama uzunluğu, Ocak–Şubat 2025'ten Ocak–Şubat 2026'ya 4,7 kelimeden 8,7 kelimeye çıktı. Kullanıcı yalnızca "geo ajansı" yazmakla yetinmiyor; bütçesini, sektörünü ve kaygısını tek cümlede anlatıyor.
Kullanımın niteliği de değişiyor. NBER'in "How People Use ChatGPT" çalışması (Eylül 2025) mesajların yaklaşık %49'unu "sorma" (bilgi ya da tavsiye isteme), %40'ını "yaptırma" ve %11'ini "ifade etme" olarak sınıflandırıyor. Web aramasına en yakın kullanım olan bilgi arayışı, Temmuz 2024 ile Temmuz 2025 arasında tüm kullanımın %14'ünden %24'üne yükseldi. Araştırmacılar bu kullanımı web aramasının çok yakın bir ikamesi olarak niteliyor; yani bilgi arayışının bir bölümü artık arama kutusunda değil, sohbet penceresinde yapılıyor.
| Kriter | Anahtar kelime araştırması | Prompt araştırması |
|---|---|---|
| Birim | Kısa ifade ("geo ajansı") | Tam soru ("KOBİ bütçesine uygun GEO platformu seçerken nelere dikkat etmeliyim?") |
| Uzunluk | Çoğunlukla 1-4 kelime | ChatGPT'de aramalı prompt ortalaması 8,7 kelime (Semrush, 2026) |
| Veri kaynağı | Hacim araçları, otomatik tamamlama | Search Console regex, grounding sorguları, destek ve satış kayıtları |
| Hacim bilgisi | Aylık arama hacmi var | Doğrulanmış bir "prompt hacmi" verisi yok |
| Başarı ölçüsü | Sıralama ve tık | Atıf, marka anılması, Share of Authority |
| Takip birimi | Tek kelime | Niyet kümesi (temsilci prompt + varyantlar) |
| Güncelleme | Dönemsel | 30–60 günde bir, sürüm numarasıyla |
Bu, anahtar kelime araştırmasının bittiği anlamına gelmez. Semrush'a göre geleneksel arama diline benzeyen prompt'ların payı Ekim 2025 ile Şubat 2026 arasında %18,9'dan %34,9'a çıktı; iki dil birbirine yaklaşıyor. Kavramsal farkın daha geniş bir anlatımı için GEO Akademi'nin GEO için anahtar kelime araştırması yazısına bakabilirsiniz. Buradaki odak, bu farkı uygulanabilir bir listeye çevirmek.
Yapay zekâ bir prompt'u nasıl aramaya çevirir, siteniz neden farklı bir sorgu görür?
Yapay zekâ yüzeyleri kullanıcının prompt'unu olduğu gibi aramaz; onu birden çok kısa arama sorgusuna böler ve bu türetilmiş sorgularla kaynak toplar. Sitenizin panelinde gördüğünüz ifade çoğu zaman kullanıcının cümlesi değil, motorun ürettiği bu ara sorgudur. Bu yüzden prompt setinde kullanıcı dilini ve motor dilini ayrı tutmak gerekir.
Google bu davranışı resmî dokümanında açıkça yazıyor. Search Central'ın "AI features and your website" sayfasına göre AI Overviews ve AI Mode, yanıt oluştururken alt konular ve veri kaynakları üzerinde birden çok ilişkili arama yapan "query fan-out" tekniğini kullanabilir. Google'ın Mayıs 2025 AI Mode duyurusu Deep Search'ün tek bir soru için "yüzlerce arama" yapabildiğini belirtir.
ChatGPT tarafında da benzer bir tablo var. Nectiv'in 8.500'ü aşan prompt üzerindeki çalışmasında prompt'ların %31'i web aramasını tetikledi; arama yapılan prompt başına ortalama 2,17 arka plan sorgusu gönderildi ve bu sorgular ortalama 5,48 kelimeydi. Kullanıcının uzun cümlesi, motor tarafında kısa ve anahtar kelimeye yakın parçalara dönüşüyor.
Microsoft bu ara sorgulara "grounding query" diyor. Bing Webmaster Tools'un AI Performance duyurusu (Şubat 2026) bunu, yapay zekânın yanıtta atıf verilen içeriği getirirken kullandığı anahtar ifadeler olarak tanımlar. Sheltron'un 365 günlük Clarity verisinde listelenen 14 grounding sorgusunun ortalaması 6,43 kelime; en kısası 4, en uzunu 9 kelime. Search Console'daki sekiz ve üzeri kelimeli prompt benzeri sorgularla kıyaslandığında bu ifadeler belirgin biçimde kısa ve anahtar kelimeye yakın.
Bunun pratik sonucu şu: Prompt setinizde her küme için iki sütun tutun. Birinde kullanıcının doğal dille sorduğu soru, diğerinde motorun bu soruyu hangi kısa ifadelerle aradığı yer alsın. Birinci sütun ölçüm için, ikinci sütun sayfa başlıkları ve alt başlıklar için kullanılır. Yüzeylerin bu mantığı nasıl farklı uyguladığını AI Mode, AI Overviews ve ChatGPT Search katmanları yazımızda ayrıntılı olarak ele aldık.
Prompt adayları hangi kaynaklardan toplanır?
En güvenilir prompt adayları tahmin araçlarından değil, kendi verinizden çıkar. Search Console'daki uzun soru sorguları, Bing ve Clarity'deki grounding sorguları, destek kayıtları, satış görüşmesi notları ve "Diğer kullanıcılar şunları da sordu" kutuları birlikte kullanıldığında setin iskeleti oluşur. Her kaynağın kör noktası farklıdır.
Eylül 2026 itibarıyla kaynakların verdiği ve vermediği şeyler şöyle:
| Kaynak | Ne verir | Ne vermez | Erişim (Eylül 2026) |
|---|---|---|---|
| Search Console Performans raporu, Sorgu filtresi "Özel (normal ifade)" | Google'a gelen uzun ve soru biçimli sorgular, gösterim, pozisyon | Sorgunun AI Mode ya da AI Overviews'tan geldiğini ayırmaz; dışa aktarımda 1.000 satır sınırı var | Tüm siteler |
| Search Console Üretken AI performans raporu | AI özelliklerindeki gösterimler; sayfa, ülke, tarih, cihaz kırılımı | Sorgu boyutu ve tık verisi yok | 31 Ağustos 2026'dan beri tüm siteler |
| Search Console Insights, Query groups | Aynı niyetin farklı yazımlarını gruplar | Küçük sitelerde görünmez | Yüksek sorgu hacimli siteler |
| Bing Webmaster Tools, AI Performance | Copilot grounding sorguları, atıf sayısı, niyet sınıfı, konu, Citation Share | Kullanıcının asıl prompt'u | Önizleme |
| Microsoft Clarity, Citations | Grounding sorguları, Share of Authority, atıf alan sayfalar | Yalnız Copilot/Bing ve iş ortakları | Clarity kurulu siteler |
| Destek kayıtları, satış görüşmesi notları, teklif e-postaları | Müşterinin kendi cümlesiyle sorduğu sorular ve itirazlar | Hacim | Şirket içi |
| "Diğer kullanıcılar şunları da sordu", otomatik tamamlama, forumlar | Takip soruları ve alt sorular | Yapay zekâda sorulma sıklığı | Açık |
Tablodaki en önemli satır ikincisi. Search Console'un Üretken AI performans raporu yalnız dört boyut sunuyor: sayfalar, ülkeler, tarihler ve cihazlar. Sorgu boyutu ve tık verisi yok. Bu rapor bir sayfanın AI özelliklerinde göründüğünü doğrulamaya yarar, ama prompt keşfine yaramaz. Google'ın AI özelliklerindeki gösterimleri klasik Performans raporunda "Web" arama türü içinde saydığını da hatırlatalım; keşif hâlâ oradan yapılıyor. Bu bilgiler Eylül 2026 itibarıyla geçerlidir; raporun kapsamı değişebileceği için kurulumu yaparken yardım sayfasının güncel hâline bakın.
ChatGPT için site sahiplerine sorgu ya da prompt verisi veren resmî bir panel Eylül 2026 itibarıyla yok. Bu yüzden ChatGPT tarafı, kurduğunuz setin düzenli testiyle ölçülür. Referans trafiğini GA4 ve Search Console üzerinden nasıl ayrıştıracağınızı GA4 ve Search Console atıf modeli yazımızda anlattık.
Destek ve satış kayıtları, hacim vermese de setin en değerli kaynağıdır; çünkü karar anındaki gerçek cümleyi taşır. "Mevcut ajansımızla devam etsek mi?" ya da "Bu hizmet e-ticaret sitesinde de işe yarar mı?" gibi sorular hiçbir hacim aracında görünmez. Bu kayıtları kullanırken ad, telefon, firma adı gibi kişisel verileri ayıklayın ve yalnız soru kalıbını saklayın; KVKK açısından ham kaydı prompt tablosuna taşımayın.
Search Console'dan prompt adayları regex ile nasıl ayıklanır?
Performans raporunda Sorgu filtresini "Özel (normal ifade)" yapıp soru kelimelerini, sekiz ve üzeri kelimeli sorguları ve birinci tekil ihtiyaç kalıplarını ayrı desenlerle aratmak, prompt adaylarını dakikalar içinde ayıklar. Türkçedeki asıl tuzak \b'dir: RE2'de yalnız ASCII kelime sınırını tanıdığı için "mı, mi, mu, mü" eklerini kaçırır. Desenleri boşluk tabanlı kurun.
Google, Performans raporundaki regex filtresinin hem eşleşen hem eşleşmeyen modda çalıştığını ve RE2 sözdizimini kullandığını Search Central blogundaki regex yazısında anlatır. Aynı yazı, niyet analizi için "what|how|when|why" gibi soru kelimeleriyle filtre kurmayı öneriyor. Türkçe için aşağıdaki desenler RE2 ile uyumludur:
Soru kalıbı:
(^| )(nasıl|nedir|neler|nelerdir|hangi|hangisi|hangileri|neden|niçin|kaç|mı|mi|mu|mü)( |\?|$)

8 ve üzeri kelime:
^(\S+\s+){7,}\S+

Soru işareti:
\?

Karşılaştırma niyeti:
( vs |karşılaştır|alternatif|fark)

Birinci tekil ihtiyaç anlatımı:
(arıyorum|istiyorum|etmeliyim|yapmalıyım|seçmeliyim|önerir misiniz|tavsiye|öneriniz|önerileriniz|işletmem|firmam|markam|ekibim)

Araç son eki:
 in tr$
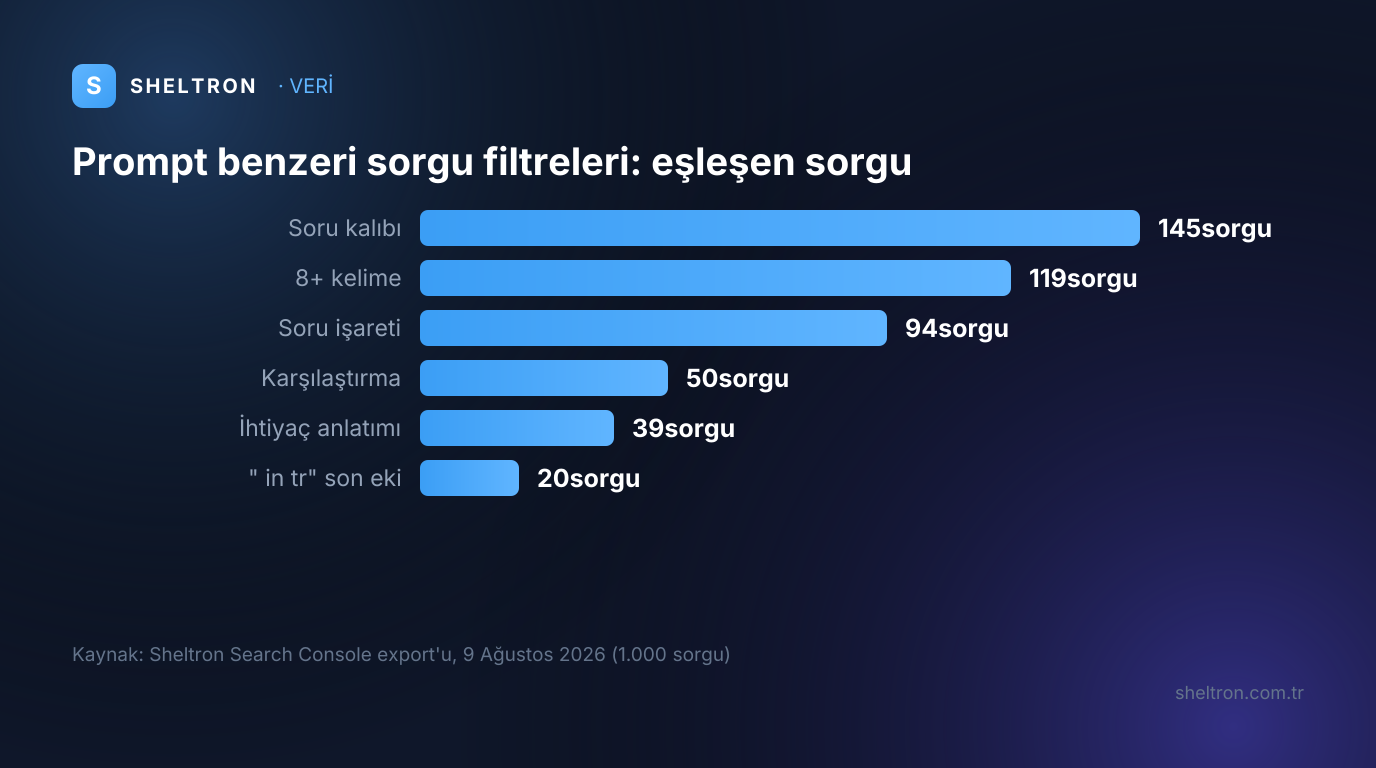
Bu desenleri, Search Console'un "Son 12 ay" filtresiyle 9 Ağustos 2026'da alınan, 1.000 sorgu, 22.459 gösterim ve 299 tıklık sheltron.com.tr export'una uyguladığımızda şu tablo çıktı. Mülkün verisi fiilen 27 Aralık 2025 ile 7 Ağustos 2026 arasındaki 224 günü kapsıyor:
| Filtre | Sorgu | Gösterim | Tık |
|---|---|---|---|
| Soru kalıbı | 145 | 5.681 | 12 |
| 8 ve üzeri kelime | 119 | 1.936 | 0 |
| Soru işareti | 94 | 1.856 | 1 |
| Karşılaştırma niyeti | 50 | 1.684 | 3 |
| Birinci tekil ihtiyaç anlatımı | 39 | 763 | 0 |
| " in tr" son eki | 20 | 509 | 0 |
Soru kalıbı satırındaki gösterimin büyük kısmını tek başına "geo nedir" sorgusu (2.926 gösterim) taşıyor; bu satır prompt benzeri değil, klasik tanım aramasıdır. Asıl aday havuzu 8 ve üzeri kelimeli sorgulardır. Bunların 68'i "platform, çözüm, servis, araç ya da yazılım" arayışı içeriyor. En çok gösterim alan örnek şu: "kobi bütçesine uygun ama ai arama görünürlüğü sağlayan platformlarda nelere dikkat etmeliyim? in tr" (75 gösterim). Aynı sorgunun son eksiz hâli ayrıca 64 gösterim aldı.
Türkçe \b tuzağının nedeni teknik. RE2 sözdizimi belgesine göre \b yalnız ASCII kelime sınırını tanır ve \w yalnız [0-9A-Za-z_] karakterlerini kapsar. Bu yüzden \bmı\b deseni "bu doğru mı" içinde eşleşmez; "ı" ASCII değildir. Aynı veride \b(mı|mi|mu|mü)\b 7 sorgu yakalarken boşluk tabanlı (^| )(mı|mi|mu|mü)( |\?|$) deseni 22 sorgu yakaladı. Türkçe desenlerde \b yerine boşluk ve satır başı/sonu kullanın. RE2 geriye bakma ((?<=) desteklemez; büyük/küçük harf duyarsızlığı için desenin başına (?i) ekleyebilirsiniz.
Bu sorguların kaynağı konusunda dikkatli olmak gerekir. Search Console bir sorgunun insan tarafından mı, bir yapay zekâ asistanı ya da izleme aracı tarafından mı gönderildiğini etiketlemez. Uzun sorguların hepsinde tık sıfır ve 20'si " in tr" son ekiyle bitiyor. Bu yüzden bunları Copilot, LLM yüzeyleri ya da izleme araçları kaynaklı olduğu düşünülen sorgular olarak ele alıyoruz. Prompt setine aday olarak girerler, kanıt olarak girmezler.
Bing ve Clarity'deki grounding sorguları prompt setine nasıl eklenir?
Grounding sorguları, Copilot'un sayfanızı bulmak için kullandığı kısa ifadelerdir; kullanıcı prompt'u değil, prompt'un arama dilindeki izidir. Bu ifadeler hangi niyet kümesinde zaten atıf aldığınızı ve hangisinde rakibe kaybettiğinizi gösterir. Sete "motor dili" sütunu olarak girer ve önceliklendirmeyi besler.
Microsoft Clarity bu veriyi atıf payıyla birlikte sunar. Clarity'nin Şubat 2026 duyurusuna göre Share of Authority, örtüşen grounding sorgularında atıfların sizin alan adınızla diğer kaynaklar arasında nasıl bölündüğünü gösterir. Sheltron'un 9 Ağustos 2026 tarihli, 365 günlük Clarity verisinde 1.422 atıf ve %29,54 Share of Authority görünüyor. Bu pano yalnız Copilot/Bing yüzeyini ölçer; ChatGPT ya da Gemini hakkında bilgi vermez.
Aynı verideki grounding sorguları, kümeleri önceliklendirmek için iyi bir başlangıç noktasıdır:
| Grounding sorgusu (Clarity, 365 gün) | Atıf | Share of Authority | Prompt setindeki anlamı |
|---|---|---|---|
| yapay zeka seo yatırımı roi rehberi | 126 | %59,15 | Güçlü küme; korunmalı |
| chatgpt aramaları için görünürlük yazılımı | 12 | %66,67 | Güçlü küme; araç seçimi niyeti |
| işletmeyi chatgpt ve gemini'de görünür yapmak | 23 | %41,82 | Orta; nasıl yapılır niyeti |
| yapay zeka arama motoru görünürlük ölçüm araçları | 36 | %37,11 | Orta; ölçüm niyeti |
| top ai seo agencies | 6 | %0,69 | Zayıf küme; rakip baskın |
Bing, Haziran 2026'da bu veriyi bir adım ileri taşıdı. Bing'in AI Visibility Insights duyurusuna göre grounding sorguları artık Informational, Commercial, Navigational, Learn and Solve, Research, Creation ve Local gibi niyet sınıflarına ayrılıyor; Topics görünümü ilgili sorguları tematik kümelere topluyor, Citation Share ise aynı sorgudaki atıf payını yüzde olarak veriyor. Bu özellikler Eylül 2026 itibarıyla önizlemede; adları ve kapsamları sonraki sürümlerde değişebilir.
Uygulamada her grounding sorgusunu kendi niyet kümesine bağlayın. Bir kümede hiç grounding sorgusu yoksa, Copilot o niyette sayfanızı henüz kaynak olarak seçmemiş demektir. Bunun içerik eksikliğinden mi, rakiplerin gücünden mi kaynaklandığını ancak test gösterir; bu kümeleri prompt setinde "test edilecek" diye işaretleyin.
Prompt'lar niyete göre nasıl gruplanır?
Tek tek cümleleri değil, niyet kümelerini izleyin. SparkToro'nun araştırmasında aynı ihtiyacı kendi cümlesiyle yazan 142 kişinin prompt'ları arasındaki anlamsal benzerlik yalnızca 0,081 çıktı. İnsanlar aynı şeyi çok farklı sözcüklerle soruyor; her kümeye bir temsilci prompt ve iki varyant çoğu zaman yeterlidir.
SparkToro'nun Ocak 2026 çalışması bu farkın ölçümü nasıl etkilediğini de gösteriyor. Prompt'lar birbirine benzemese de kulaklık niyetinde Bose, Sony, Sennheiser ve Apple cevapların %55–77'sinde yer aldı. Yani yapay zekâ cümleyi değil niyeti yanıtlıyor; ölçmeniz gereken de niyet düzeyindeki görünürlük.
Google da gruplamayı niyet üzerinden yapıyor. Search Console Insights'taki Query groups özelliği (Ekim 2025), "best running shoes" ile "which shoes are good for jogging" gibi farklı yazımları tek grupta topluyor; ancak yalnız yüksek sorgu hacmine sahip sitelerde görünüyor. Küçük ve orta ölçekli sitelerde gruplamayı elle yapmak gerekiyor.
Türkçe B2B ve hizmet sitelerinde işe yarayan altı kümelik bir şablon:
| Küme | Temsilci prompt (örnek) | Adayın tipik kaynağı | Yolculuk aşaması |
|---|---|---|---|
| Tanım | "GEO nedir, SEO'dan farkı ne?" | Search Console soru kalıbı | Farkındalık |
| Nasıl yapılır | "İşletmemi ChatGPT ve Gemini'de nasıl görünür yaparım?" | Clarity grounding sorgusu | Farkındalık |
| Seçim ve karşılaştırma | "KOBİ bütçesine uygun AI görünürlük platformu seçerken nelere dikkat etmeliyim?" | Search Console (Sheltron export'unda 75 + 64 gösterim) | Değerlendirme |
| Fiyat ve bütçe | "Yapay zekâ görünürlük hizmetinin aylık maliyeti ne kadar?" | Satış görüşmesi notları | Değerlendirme |
| Güven ve yorum | "Bu platformu kullanan şirketler memnun mu?" | Destek kayıtları | Karar |
| Yerel | "İstanbul'da GEO danışmanlığı veren firmalar hangileri?" | "Diğer kullanıcılar şunları da sordu" | Karar |
Tablodaki prompt'lar örnektir. Kaynak sütunu, o kümenin adaylarının genellikle nereden çıktığını gösterir; tanım, nasıl yapılır ve seçim satırlarındaki kalıplar sheltron.com.tr'nin kendi Search Console ve Clarity verisinde görülen sorgulardan uyarlandı. Bing'in niyet sınıflarını ya da SE Ranking'in beş prompt tipini (bilgi, karşılaştırma, talimat, marka, işlem) de kullanabilirsiniz. Önemli olan, her kümenin satın alma yolculuğunda bir aşamaya bağlanmasıdır. Türkçe sorguların "X için Y" gibi kalıplarına göre içerik yazmayı Türkçe long-tail sorgular yazımızda ele aldık; o kalıplar küme içindeki varyantları seçerken de işe yarar.
Seti bir tabloda tutun. Önerdiğimiz sütunlar şöyle (satırdaki değerler örnektir):
kume,temsilci_prompt,varyant_1,varyant_2,motor_dili,niyet,kaynak,kaynak_kaniti,yolculuk_asamasi,oncelik
platform-secimi,"KOBİ bütçesine uygun AI görünürlük platformu seçerken nelere dikkat etmeliyim?","e-ticaret için ai görünürlük platformu önerisi","ai arama görünürlüğü platformları karşılaştırma","chatgpt aramaları için görünürlük yazılımı",karşılaştırma-seçim,GSC,"9 Ağu 2026 export: 75+64 gösterim",değerlendirme,yüksek
İzlenecek prompt seti kaç prompt olmalı ve nasıl önceliklendirilir?
Başlangıç için 20–40 prompt yeterlidir. Set en az 30 gün değiştirilmeden izlenmeli ve 30–60 günde bir gözden geçirilmelidir. Önceliği üç şey belirler: kümenin satın alma yolculuğundaki yeri, Search Console'daki gösterim kanıtı ve grounding sorgularında rakibin atıf payı.
Bu aralıklar SE Ranking'in prompt seçimi rehberinden (Nisan 2026) geliyor: 20–40 prompt ile başlamayı, sonuç çıkarmadan önce en az 30 gün izlemeyi ve seti 30–60 günde bir gözden geçirmeyi öneriyor. Kısa bir sürede sonuç çıkarmamanın nedeni cevapların değişkenliği. SparkToro'nun 600 gönüllü ve 2.961 çalıştırmalık testinde aynı prompt'a aynı marka listesinin dönme ihtimali 100'de 1'in altında kaldı. Tek bir çalıştırma bir fotoğraftır; eğilim için aynı seti tekrar tekrar çalıştırmak gerekir.
Önceliklendirme için basit bir puanlama yeterli:
- Yolculuk aşaması: Değerlendirme ve karar kümeleri, farkındalık kümelerinden önce gelir; satın alma kararı orada verilir.
- Gösterim kanıtı: Search Console'da uzun sorgu olarak görünen kümeye ek puan verin; bu, konunun Google'a uzun ve prompt benzeri biçimde zaten geldiğine işaret eder.
- Rakip payı: Grounding sorgusunda Share of Authority düşükse ("top ai seo agencies" örneğindeki %0,69 gibi) küme yüksek önceliklidir, ama beklenti gerçekçi tutulmalıdır.
- İçerik varlığı: Kümeye cevap veren bir sayfanız yoksa, önce ölçüm değil içerik gerekir.
Bu denetimi kendi setimize de uyguladık. Sheltron'un Nisan 2026'da kurduğu atıf izleme seti 15 sabit sorgudan oluşuyor ve haftalık çalışacak şekilde Gemini 2.5 Flash ve Google Search grounding ile kurgulandı. Set editoryal kategorilerle yukarıdan aşağı kurulmuştu: 5 pillar ve kategori, 5 sektörel, 3 lokasyon ve 2 teknik/karar sorgusu. Search Console kanıtıyla karşılaştırınca bir boşluk çıktı: 8 ve üzeri kelimeli 119 sorgunun 68'i platform ya da çözüm arayışındayken, sette bu niyete en yakın satır, kısa ve liste isteyen "KOBİ için bütçe dostu yapay zekâ görünürlük çözümleri" sorgusu; "seçerken nelere dikkat etmeliyim" tipinde seçim kriteri soran bir prompt yok. Setin kanıtla denetlenmesi gerektiğini gösteren en somut örnek bu.
Seti değiştirdiğinizde eğilim çizgisi kırılır. Bu yüzden her revizyonu sürüm numarasıyla kaydedin ve eski sürümün son ölçümünü yeni sürümün ilk ölçümüyle birlikte arşivleyin. Sabit setin nasıl ölçüleceğini ve Share of Voice'un nasıl hesaplanacağını AI Share of Voice metodolojisi yazımızda anlattık; bu yazı o metodolojinin girdisini üretir.
Prompt seti nasıl test edilir ve içerik planına nasıl dönüşür?
Seti ilk kez test etmek için hızlı bir görünürlük fotoğrafı, ardından rakip karşılaştırması ve sonunda kalıcı izleme gerekir. Açık çıkan her niyet kümesi bir içerik brief'ine dönüşür; içerik yayımlandıktan sonra aynı küme yeniden ölçülür. Döngü, prompt araştırmasını tek seferlik bir listeden sürekli bir sürece çevirir.
Sheltron'un ücretsiz araçları bu döngünün ilk iki adımında işe yarar, ama ne yaptıklarını doğru bilmek gerekir. AI Görünürlük Spot Check, seçtiğiniz sektöre göre 5 sabit şablon sorguyu Gemini 2.5 Flash ve Google Search grounding ile çalıştırır. Sizin prompt setinizi çalıştırmaz; hızlı bir başlangıç ölçümü verir. Aracın iş akışını Spot Check ile hızlı denetim yazımızda adım adım gösterdik. İçerik Açığı Analizi ise girdiğiniz kategori için 6 niyet sorgusunu Gemini ile üretir ve rakiplerin atıf aldığı ama sizin almadığınız sorguları bir matriste gösterir. Bu sorguları kendi kümelerinizle karşılaştırmak, setinizde eksik kalan bir niyeti yakalamanın hızlı yoludur.
Açık çıkan kümeleri içerik planına bağlamak için içerik açığı analizi ve rakip pozisyon tespiti yazımızdaki çerçeveyi kullanabilirsiniz; aracın farklı kullanım senaryoları beş kullanım senaryosu yazısında yer alıyor. İçeriğin kendisi de fark yaratır: GEO üzerine KDD 2024 makalesi, kaynak gösterme ve istatistik ekleme gibi yöntemlerin üretken motor yanıtlarındaki görünürlüğü %40'a kadar artırabildiğini gösterdi.
Kalıcı izleme için setin aynı sorgularla, düzenli aralıklarla ve birden çok yüzeyde çalıştırılması gerekir. Sheltron AiSEO bu işi niyet bazlı raporlarla yapar; marka anılmalarını ayrıca izlemek isterseniz marka takibi aracı başlangıç için yeterlidir. Hazır prompt kalıplarına ihtiyaç duyarsanız The GEO Authority'nin prompt şablonları kümelerinizi doldururken fikir verebilir.
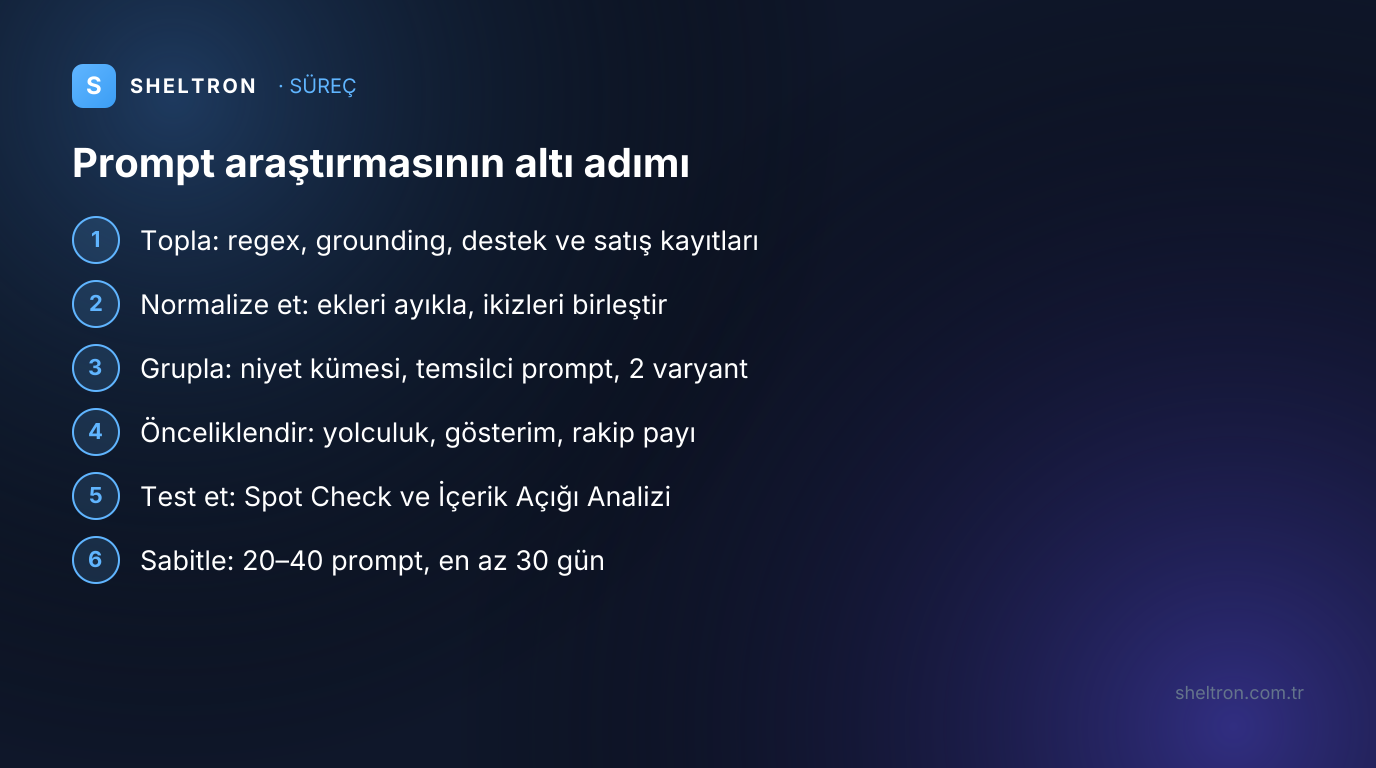
Özetle süreç altı adımdan oluşur:
- Topla: Search Console regex filtreleri, Bing ve Clarity grounding sorguları, destek ve satış kayıtları, "Diğer kullanıcılar şunları da sordu" kutuları.
- Normalize et: Satır sonlarını tek boşluğa çevirin, " in tr" gibi araç eklerini ayıklayın ama kaynağı not edin, ikiz satırları birleştirin. Export, 76 karakteri aşan sorguları satır sonuyla bölüyor; bu bir kaynak sinyali değil, biçim hatasıdır.
- Grupla: Her niyet kümesi için bir temsilci prompt, iki varyant ve bir motor dili ifadesi seçin.
- Önceliklendir: Yolculuk aşaması, gösterim kanıtı ve rakip atıf payına göre puanlayın.
- Test et: Spot Check ile ilk fotoğrafı, İçerik Açığı Analizi ile rakip matrisini çıkarın.
- Sabitle ve tekrarla: 20–40 prompt'luk seti en az 30 gün değiştirmeden izleyin, 30–60 günde bir sürüm numarasıyla revize edin.
Setinizi kurmadan önce sitenizin mevcut AI görünürlüğünü bir uzman gözüyle görmek isterseniz hızlı değerlendirme formunu doldurun; Sheltron ekibi hangi niyet kümelerinde görünür olduğunuzu ve hangilerinde rakiplerin öne geçtiğini sizinle paylaşsın.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Prompt Araştırması Nasıl Yapılır? Anahtar Kelimeden Yapay Zekâya Sorulan Sorulara Geçiş
- TL;DR
- ChatGPT prompt'larının %65–85'i hiçbir anahtar kelimeyle eşleşmiyor (Semrush, 2026). Prompt araştırması bu soruları Search Console regex filtreleri, Bing ve Clarity grounding sorguları ve destek kayıtlarıyla toplar, niyete göre gruplar ve 20–40 prompt'luk sabit bir sete çevirir. Türkçe desenlerde \b kullanılmamalı: Sheltron'un Search Console verisinde \b'li soru eki deseni 7, boşluk tabanlı desen 22 sorgu yakaladı.
- Ana Çıkarımlar (7)
- Semrush'a göre (2026) ChatGPT prompt'larının %65–85'i hiçbir geleneksel anahtar kelimeyle eşleşmiyor; prompt araştırması hacim tablosundan değil, sorulan sorulardan başlar.
- Search Console'un Üretken AI performans raporunda sorgu boyutu yok; prompt keşfi klasik Performans raporundaki regex filtreleriyle yapılır.
- Search Console bir sorgunun insan, yapay zekâ yüzeyi ya da izleme aracı kaynaklı olduğunu etiketlemez; Sheltron verisinde 8 ve üzeri kelimeli sorguların tamamı 0 tık aldı, bu yüzden bu sorgular kanıt değil, prompt setine aday olarak ele alınmalı.
- RE2'de \b yalnız ASCII sınırını tanır: aynı veride \b'li desen 7, boşluk tabanlı desen 22 Türkçe soru ekli sorgu yakaladı.
- Aynı ihtiyacı yazan 142 kişinin prompt'ları arasındaki anlamsal benzerlik 0,081 (SparkToro, 2026); bu yüzden tekil cümle değil, niyet kümesi izlenir.
- Başlangıç seti 20–40 prompt olmalı, en az 30 gün değiştirilmeden izlenmeli ve 30–60 günde bir sürüm numarasıyla revize edilmelidir.
- Copilot grounding sorguları ortalama 6,43 kelime (Sheltron Clarity verisi); kullanıcı dili ve motor dili sette ayrı sütunlarda tutulmalı.
- Kaynaklı Veriler
- %65–85 — ChatGPT prompt'larının 27 milyar anahtar kelimelik veri tabanında hiçbir geleneksel anahtar kelimeyle eşleşmeyen payı (Semrush, ChatGPT traffic analysis (L. Harsel), 2026)
- 8,7 kelime — web aramasını tetikleyen ChatGPT prompt'larının Ocak–Şubat 2026 ortalama uzunluğu (bir yıl önce 4,7) (Semrush, ChatGPT traffic analysis, 2026)
- 3 kat — ortalama AI Mode aramasının klasik Google aramasına göre uzunluğu (Google, How AI Mode is changing the way people search, 2026)
- 0,081 — aynı niyeti kendi cümlesiyle yazan 142 kişinin prompt'ları arasındaki anlamsal benzerlik (SparkToro (R. Fishkin, Gumshoe.ai ile), 2026)
- %55–77 — farklı prompt'lara rağmen kulaklık niyetinde ilk markaların cevaplarda görünme oranı (SparkToro, 2026)
- %31 — web aramasını tetikleyen ChatGPT prompt'larının payı; arama yapılan prompt başına ortalama 2,17 arka plan sorgusu (Nectiv (C. Long), 2025)
- %49 — ChatGPT mesajlarında bilgi ya da tavsiye isteme ("Asking") payı; %40 görev, %11 ifade (NBER Working Paper w34255, How People Use ChatGPT, 2025)
- %14'ten %24'e — bilgi arayışının Temmuz 2024–Temmuz 2025 arasında ChatGPT kullanımındaki payı (NBER Working Paper w34255, 2025)
- 20–40 prompt — başlangıç seti için önerilen büyüklük; en az 30 gün izleme, 30–60 günde bir revizyon (SE Ranking (Y. Khromova), 2026)
- 119 sorgu — sheltron.com.tr'nin 9 Ağustos 2026 Search Console export'unda 8 ve üzeri kelimeli sorgular; 1.936 gösterim, 0 tık (Sheltron Search Console verisi (9 Ağustos 2026 export'u, 'Son 12 ay' filtresi; veri 27 Aralık 2025–7 Ağustos 2026, Web), 2026)
- 22 sorgu — boşluk tabanlı Türkçe soru eki deseninin yakaladığı sorgu; \b'li desen aynı veride 7 sorgu buldu (Sheltron Search Console verisi (9 Ağustos 2026 export'u), RE2 tanımına göre hesaplandı, 2026)
- %29,54 — sheltron.com.tr'nin 365 günlük Clarity verisinde Copilot atıflarındaki Share of Authority; 1.422 atıf (Sheltron Microsoft Clarity Citations verisi (9 Ağustos 2026, 365 gün), 2026)
- 6,43 kelime — Sheltron Clarity verisindeki 14 Copilot grounding sorgusunun ortalama uzunluğu (Sheltron Microsoft Clarity Citations verisi (9 Ağustos 2026, 365 gün), 2026)
- %40'a kadar — GEO yöntemlerinin üretken motor yanıtlarındaki görünürlüğü artırma potansiyeli (Aggarwal vd., GEO: Generative Engine Optimization (KDD 2024), 2024)
- 4 boyut — Search Console Üretken AI performans raporunun sunduğu kırılım (sayfa, ülke, tarih, cihaz); sorgu boyutu yok (Search Console Yardım, Generative AI performance report, 2026)
- Arama Niyetleri
- prompt araştırması nasıl yapılır
- ai'a sorulan soruları bulma
- geo için prompt listesi oluşturma
- anahtar kelime araştırması yerine prompt araştırması
- prompt keşfi geo
- izlenecek prompt seti nasıl seçilir
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz