
ProfilePage ve Person Şeması: Yazar Sayfasını AI İçin Doğrulanabilir Kimliğe Çevirmek
ProfilePage şeması, yazar sayfasının tek bir kişiyi anlattığını makineye söyler. Yazı; Google'ın ProfilePage ve Article kurallarını, yazar sayfasından makaleye @id ile kimlik grafiği kurulumunu, hasPart ile son yazıların listelenmesini ve kendi yazar sayfamızın Eylül 2026 öz-denetimini anlatıyor.
💡Kısa Özet
ProfilePage bir sayfa tipidir, Person ise o sayfanın anlattığı kişi. Kişi yazar sayfasında bir kez tanımlanır, makaleler onu @id ve url ile çağırır. schema.org'un Ağustos 2026 sayımına göre Person 10 milyondan fazla, ProfilePage 1-10 milyon alan adında kullanılıyor. Web Almanac 2024'e göre mobil sayfaların yalnızca %1,11'i sameAs ile LinkedIn'e bağlanıyor. Google, AI özellikleri için özel şema gerekmediğini yazıyor; yazar şeması atıf garantisi değil, tutarlı kimlik aracıdır.
Ana Çıkarımlar
- •ProfilePage bir sayfa tipidir, Person ise varlıktır; Google'da tek zorunlu alan mainEntity, onun tek zorunlu alanı name.
- •Google'ın Article dokümanı, author.url dahili bir profil sayfasıysa yazarın ProfilePage ile işaretlenmesini öneriyor; sameAs alternatif olarak kabul ediliyor.
- •schema.org'un Ağustos 2026 sayımına göre Person 10 milyondan fazla, ProfilePage ve knowsAbout 1-10 milyon, hasCredential 100 bin-1 milyon alan adında kullanılıyor.
- •Web Almanac 2024'e göre mobil sayfaların yalnızca %1,11'i sameAs ile LinkedIn'e, %0,17'si Wikidata'ya bağlanıyor.
- •JSON-LD işlemcileri @id'leri dize olarak eşler; RFC 3987 de kod noktası bazında karşılaştırma ister, bu yüzden #eren-çöp ile #eren-cop iki ayrı Person düğümü üretir.
- •Eylül 2026 öz-denetimimizde aynı yazar @id'si ekip sayfasında 11, blog sayfalarında 5 knowsAbout öğesi taşıyordu; yalnız 2'si ortaktı.
- •Google, AI Overviews ve AI Mode için özel şema gerekmediğini yazıyor; AirOps'a göre ChatGPT'nin getirdiği sayfaların yalnızca %15'i atıf alıyor.
ProfilePage şeması, bir sayfanın tek bir kişiyi ya da kurumu anlattığını makineye söyleyen schema.org tipidir. Person düğümü ise o kişinin kendisidir. İkisi sabit bir @id ile makalelerdeki author alanına bağlandığında, byline'daki isim doğrulanabilir bir kimliğe dönüşür. schema.org'un Google dizinine dayanan Ağustos 2026 sayımına göre ProfilePage 1 ile 10 milyon arasında alan adında kullanılıyor, Person ise 10 milyondan fazla alan adında.
Bu iki aralık, sahada sık görülen bir durumu özetliyor: kişiyi şemayla tanımlayan site çok, o kişiyi kendine ait bir profil sayfasına bağlayan site daha az. Aşağıda Google'ın ProfilePage ve Article dokümanlarını tek bir yazar sayfası–makale kurgusunda birleştiriyor, Türkçe karakterli @id gibi gerçek hataları gösteriyor ve kendi sitemizde Eylül 2026'da yaptığımız öz-denetimin sonuçlarını paylaşıyoruz. Kaynaklardaki bilgiler Eylül 2026 itibarıyla geçerlidir.
ProfilePage şeması nedir, Person'dan farkı ne?
ProfilePage bir sayfa tipidir, Person ise bir varlıktır. schema.org hiyerarşisinde ProfilePage, WebPage'in alt tipidir ve "bu URL bir kişiyi anlatıyor" der. Person, anlatılan kişinin kendisidir. Google'ın ProfilePage dokümanında tek zorunlu alan mainEntity, onun tek zorunlu alanı da name. Bir yazar sayfasında ikisi birlikte, iç içe kullanılır.
Bu ayrım pratikte önemlidir. Bir yazar sayfasının kendisi ProfilePage'dir: bir URL'si, oluşturulma ve güncellenme tarihi vardır. Sayfanın konusu olan kişi ise Person düğümüdür ve aynı kişi sitenin başka yüzlerce sayfasında, örneğin her makalenin author alanında yeniden karşımıza çıkar. ProfilePage kişiyi tanıtan belgeyi, Person ise tanıtılan varlığı işaretler. GEO terimleri sözlüğümüzde "entity" olarak geçen kavram, burada Person düğümüne karşılık gelir.
Google, ProfilePage desteğini 27 Kasım 2023'te Search Central Blog'da duyurdu ve işaretlemeyi "yaratıcıların, yani kişilerin ya da kurumların, birinci elden bakış açılarını paylaştığı her site" için tasarladığını yazdı. Aynı duyuruya göre işaretleme, Google'ın kişinin adını, sosyal medya kullanıcı adını, profil fotoğrafını ve takipçi sayısını daha iyi tanımasına yardım ediyor; Search Console'a da bunun için yeni raporlar eklendi. Bu yazının yayımlandığı 27 Kasım 2026, o duyurunun üçüncü yılına denk geliyor.
Google'ın dokümanı ProfilePage için ayrı bir arama sonucu görünümü tarif etmiyor. Güncel doküman işaretlemeyi Discussions and forums özelliğinde ve Article, Recipe gibi türlerden gelen yazar bağlantılarında kullandığını söylüyor; 2023 duyurusu buna Perspectives özelliğini de ekliyordu. Kısacası ProfilePage görünür bir süs değil, kimlik altyapısıdır.
Sık karıştırılan bir ayrım da AboutPage ile ilgilidir. AboutPage bir kurumun "hakkımızda" sayfası için tasarlanmıştır. Yazar ya da çalışan sayfası için doğru tip ProfilePage'dir. Google, bir blogdaki "Hakkımda" sayfasını da ProfilePage için geçerli örnekler arasında sayıyor, çünkü o sayfanın odağı tek bir kişidir.
Yazar kutusu neden makine için yalnızca bir isimdir?
Sayfada "Yazar: Ayşe Yılmaz" yazması, bir makinenin bu ismi belirli bir kişiye bağlaması için yetmez. Aynı adı taşıyan başka insanlar olabilir; unvan, kurum ve dış profiller metnin farklı yerlerinde dağınık durur. Şema bu bilgiyi tek bir tanımlayıcı altında toplar ve makalenin yazarını yazar sayfasındaki kişiyle eşler.
Google bu ihtiyacı kendi içerik rehberinde sorular hâlinde dile getiriyor. Yararlı ve güvenilir içerik rehberi site sahiplerine "İçeriği kimin yazdığı ziyaretçileriniz için açık mı?", "Sayfalarda beklenen yerde bir byline var mı?" ve "Byline'lar yazar hakkında daha fazla bilgiye götürüyor mu?" diye sormalarını öneriyor. Aynı rehber E-E-A-T bileşenleri arasında en önemlisinin güven olduğunu, E-E-A-T'nin ise kendi başına bir sıralama faktörü olmadığını da açıkça yazıyor.
İnsan değerlendiricilerin kullandığı Search Quality Rater Guidelines aynı konuya daha net bir çerçeve çiziyor. 11 Eylül 2025 tarihli, 182 sayfalık sürümün 2.5.2 numaralı bölümü, web sitesinden kimin sorumlu olduğunu ve sayfadaki içeriği kimin yarattığını bulmayı anlatıyor. Yönergeye göre sitenin ya da içerik üreticisinin kendisi hakkında söyledikleri ile saygın bağımsız kaynakların söyledikleri çelişirse, değerlendirici bağımsız kaynaklara güveniyor.
Bu iki metin birlikte okunduğunda yazar kutusunun görevi netleşir: kişiyi adlandırmak yetmez, onu doğrulanabilir bilgiye bağlamak gerekir. Google, yapılandırılmış veriye giriş dokümanında işaretlemeyi yalnız sayfayı anlamak için değil, işaretlemede geçen kişiler, kitaplar ve şirketler hakkında bilgi toplamak için de kullandığını söylüyor. Person şeması tam bu bilgi toplama işine girdi verir.
E-E-A-T ve yapay zeka yazımız, yazar şemasının neden önemli olduğunu kavramsal düzeyde anlatıyor. Buradaki soru ise daha teknik: bu kimliğin, sitenin yüzlerce sayfasında tek ve çelişkisiz kalması nasıl sağlanır?
Google yazar sayfası için tam olarak ne istiyor?
Google'ın iki dokümanı birbirini tamamlıyor. Article dokümanı, author.url dahili bir profil sayfasını gösteriyorsa o yazarın ProfilePage ile işaretlenmesini öneriyor. ProfilePage dokümanı da sayfanın asıl odağının, web sitesiyle ilişkili tek bir kişi ya da kurum olmasını şart koşuyor. Yazar sayfası, bu iki kuralın buluştuğu yerdir.
ProfilePage dokümanının resmi Türkçe sürümü (son güncelleme 15 Eylül 2026) geçerli örnekler olarak haber sitesindeki yazar sayfasını, blog sitesindeki "Hakkımda" sayfasını ve şirket web sitesindeki çalışan sayfasını sayıyor. Mağazanın ana sayfası ve kuruluş inceleme siteleri ise geçersiz örnekler arasında. Kural basit: sayfanın konusu tek bir kişi ya da kurum değilse ProfilePage uygun tip değildir.
Google'ın zorunlu ve önerilen alanları, bir yazar sayfasında şu karşılıkları buluyor:
| Alan | Nerede | Google'daki durumu | Yazar sayfasındaki karşılığı |
|---|---|---|---|
mainEntity |
ProfilePage | Zorunlu | Sayfanın anlattığı Person düğümü |
name |
mainEntity (Person) | Zorunlu | Sayfada görünen ad soyad (Article kuralı gereği unvan ve onur unvanı yazılmaz) |
dateCreated, dateModified |
ProfilePage | Önerilen | Profilin oluşturulduğu ve içeriğinin son değiştiği tarih |
alternateName |
mainEntity | Önerilen | Takma ad ya da kullanıcı adı |
identifier |
mainEntity | Önerilen | Site içindeki benzersiz yazar kimliği |
description |
mainEntity | Önerilen | Sayfada görünen biyografi metni |
image |
mainEntity | Önerilen | Profil fotoğrafı |
sameAs |
mainEntity | Önerilen | LinkedIn, ORCID gibi dış profil bağlantıları |
interactionStatistic, agentInteractionStatistic |
mainEntity | Önerilen | Takipçi, yazı sayısı gibi sayaçlar; daha çok forum ve sosyal profillerde anlamlı |
Makale tarafındaki kurallar Article yapılandırılmış veri dokümanında yer alıyor. Google author.url alanını "makalenin yazarını benzersiz biçimde tanımlayan bir web sayfasına bağlantı" olarak tanımlıyor ve bu URL dahili bir profil sayfasıysa yazarın ProfilePage ile işaretlenmesini öneriyor. sameAs bir alternatif olarak geçiyor; Google, yazarları birbirinden ayırt ederken hem sameAs'i hem url'yi anlayabildiğini yazıyor.
Aynı dokümandaki üç pratik kural da yazar kimliğini doğrudan etkiliyor:
- Bütün yazarlar işaretlenir. Birden fazla yazar varsa her biri ayrı bir
authornesnesi olarak yazılır. - Yazarlar tek alanda birleştirilmez. "Ayşe Yılmaz, Can Kaya" gibi tek bir
namedeğeri, iki kişiyi tek kişiye çevirir. nameyalnız isim taşır. Unvan, yayıncı adı ya da onur unvanı isim alanına yazılmaz; unvan içinjobTitlekullanılır.
Son olarak Google'ın genel yapılandırılmış veri yönergeleri okuyucunun göremediği içeriğin işaretlenmemesini ve şemanın sayfa içeriğinin doğru bir temsili olmasını istiyor. Yazar sayfası için bunun anlamı açık: şemadaki unvan, biyografi ve uzmanlık alanları sayfada da görünmelidir.
Yazar sayfasından makaleye kimlik grafiği nasıl kurulur?
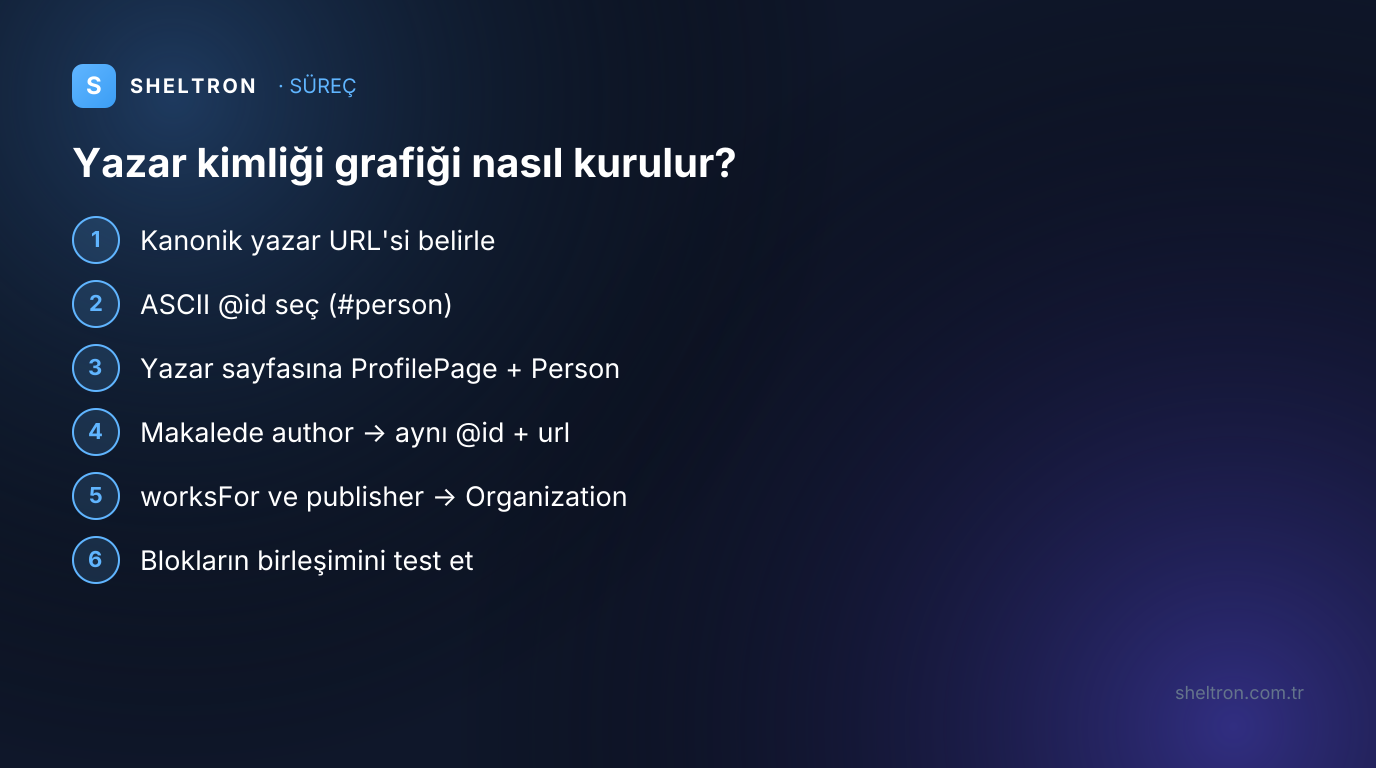
Kişi bir kez, yazar sayfasında eksiksiz tanımlanır; makaleler onu @id ve url ile çağırır. Böylece yüzlerce yazı, sayfada görünen tek bir biyografiye bağlanır ve hiçbir makale kişiyi yeniden, belki de farklı biçimde tarif etmek zorunda kalmaz. Aşağıdaki altı adım ve iki JSON-LD örneği kurgunun tamamını gösteriyor.
- Kanonik yazar URL'sini belirleyin. Her yazarın tek, kalıcı bir sayfası olsun. Bu URL hem
author.urlhem de@id'nin temeli olacak. - ASCII bir
@idseçin. Yazar sayfası URL'sine#persongibi bir parça ekleyin ve Türkçe karakter kullanmayın. JSON-LD işlemcileri@id'leri basit dize karşılaştırmasıyla eşler; RFC 3987 §5.3.1 de bu karşılaştırmanın kod noktası bazında yapılmasını ve IRI'lerin URI'ye çevrilmemesini ister. Bu yüzden ç ile c farklı düğüm üretir: Ağustos 2026 tarihli iç playbook'umuz, makalelerdeki#eren-çöpile ekip sayfasındaki#eren-cop'un "iki ayrı Person entity, bölünmüş E-E-A-T" yarattığını kayda geçirdi ve çözüm bütün kimlikleri tek bir dönüştürme fonksiyonuyla (ç→c, ğ→g, ı→i, ö→o, ş→s, ü→u) üretmek oldu. - Yazar sayfasına ProfilePage ve Person ekleyin. Tam tanım, yani unvan, biyografi, uzmanlık alanları ve dış profiller, yalnız burada yer alır.
- Makalede yazara referans verin.
authoralanına aynı@id'yi,name'i veurl'yi yazın. - Kurumu bağlayın. Person'daki
worksForve makaledekipublisheralanları, sitedeki Organization düğümünün@id'sini göstersin. - Birleşimi test edin. Hem yazar sayfasını hem bir makaleyi doğrulayıcıdan geçirin ve aynı kişinin tek düğüm olarak kaldığını kontrol edin.
Yazar sayfası için bir örnek aşağıda. Kişi ve alan adı kurgusaldır, yalnız yapıyı göstermek için kullanılıyor:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "ProfilePage",
      "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#profilepage",
      "url": "https://ornek.com.tr/yazarlar/ayse-yilmaz/",
      "dateCreated": "2025-03-01T09:00:00+03:00",
      "dateModified": "2026-09-15T10:00:00+03:00",
      "mainEntity": { "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#person" }
    },
    {
      "@type": "Person",
      "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#person",
      "name": "Ayşe Yılmaz",
      "jobTitle": "Kıdemli Veri Analisti",
      "description": "Sayfada görünen biyografinin aynısı.",
      "image": "https://ornek.com.tr/img/ayse-yilmaz.jpg",
      "worksFor": { "@id": "https://ornek.com.tr/#organization" },
      "knowsAbout": ["Yapılandırılmış veri", "Web analitiği"],
      "sameAs": [
        "https://www.linkedin.com/in/ornek-profil/",
        "https://orcid.org/0000-0000-0000-0000"
      ]
    }
  ]
}
Aynı kişinin bir blog yazısındaki karşılığı ise yalnız referans ve ayırt edici alanlardan oluşur:
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Yapılandırılmış veri denetimi nasıl yapılır?",
  "author": {
    "@type": "Person",
    "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#person",
    "name": "Ayşe Yılmaz",
    "url": "https://ornek.com.tr/yazarlar/ayse-yilmaz/"
  },
  "publisher": { "@id": "https://ornek.com.tr/#organization" }
}
Buradaki temel kural şudur: makale sayfasında jobTitle, description ve knowsAbout yeniden yazılmaz. Yazılacaksa CMS'teki tek yazar kaydından, yazar sayfasındakiyle birebir aynı değerle gelmelidir. Google'ın makale için beklediği name ve url ikilisi bu yapıda zaten karşılanıyor.
JSON-LD sözdizimine yeniyseniz önce JSON-LD teknik rehberimize, şemanın AI görünürlüğündeki genel rolü için schema.org ve JSON-LD rehberimize bakabilirsiniz. İlk taslağı Sheltron'un ücretsiz Schema Markup Üretici aracıyla oluşturup, sonucu Şema Doğrulayıcı ile kontrol edebilirsiniz.
jobTitle, knowsAbout ve sameAs hangi soruyu cevaplar?
jobTitle kişinin ne iş yaptığını, knowsAbout hangi konularda söz sahibi olduğunu, sameAs ise kimliğinin başka nerede doğrulanabileceğini söyler. schema.org knowsAbout'u uzmanlığı ima eden ama garanti etmeyen bir alan olarak tanımlıyor. Bu yüzden güvenin asıl yükünü sameAs'in gösterdiği bağımsız profiller taşır.
Yazar kimliğinde en sık kullanılan özellikleri, cevapladıkları soruya ve schema.org'un Ağustos 2026 kullanım aralıklarına göre şöyle sıralayabiliriz:
| Özellik | Cevapladığı soru | Sayfada görünür karşılığı | Kullanan alan adı (schema.org, Ağustos 2026) |
|---|---|---|---|
author (makalede) |
Bu içeriği kim yazdı? | Byline | 10M+ |
sameAs |
Bu kişi başka nerede doğrulanır? | Profil bağlantıları | 10M+ |
jobTitle |
Ne iş yapıyor? | Unvan satırı | 1M–10M |
worksFor |
Hangi kurumda çalışıyor? | Kurum adı ve bağlantısı | 1M–10M |
knowsAbout |
Hangi konularda söz sahibi? | Uzmanlık alanları listesi | 1M–10M |
hasCredential |
Hangi belge ya da yetkinliğe sahip? | Sertifika, diploma, lisans | 100K–1M |
Tablo bir boşluğu gösteriyor: yazarı işaretleyen site çok, kişinin akreditasyonunu makinece okunur biçimde yazan site az. hasCredential 100 bin ile 1 milyon arasında alan adında kullanılıyor. Sağlık, hukuk ya da finans gibi yetkinliğin belgeyle kanıtlandığı alanlarda bu alan, gerçek bir belgeye bağlandığında ayırt edici olabilir.
sameAs için schema.org'un tanımı ölçüt olarak kullanılabilir: kişinin kimliğini "tartışmasız biçimde gösteren" bir referans sayfa. LinkedIn profili, ORCID kaydı, varsa Wikidata öğesi ve kişinin konuşmacı ya da yazar olarak yer aldığı bağımsız sayfalar bu tanıma uyar. Şirketin kendi sayfaları uymaz, çünkü bağımsız değildir.
Bu alanın sahada ne kadar boş kaldığını HTTP Archive'ın Web Almanac 2024 raporu gösteriyor. Rapora göre JSON-LD barındıran sayfaların oranı 2022'deki %34'ten 2024'te %41'e çıktı. Ancak mobil sayfaların yalnızca %1,11'i sameAs ile LinkedIn'e, %0,17'si Wikidata'ya, %0,13'ü Wikipedia'ya bağlanıyor. Almanac, yöneticiler, yazarlar ve uzmanlar gibi kişisel varlıklarda sameAs'in otorite kurmaya yardım ettiğini ayrıca not ediyor.
knowsAbout için ölçülü olmak gerekir. Uzun bir anahtar kelime listesi hiçbir şey kanıtlamaz. Kişinin gerçekten yazdığı, konuştuğu ve biyografisinde görünen birkaç konu yeterlidir. Kurucu ve yöneticiler için bu zincirin LinkedIn tarafını kurucu kişisel markası ve AI görünürlüğü yazımızda, profil stratejisini de CEO ve kurucular için LinkedIn rehberimizde ele aldık.
Şema, kişinin kendi hakkında söylediğidir. Kimliği asıl sağlamlaştıran, başkalarının söyledikleridir. Bu yüzden sameAs zincirinin ucundaki profiller güncel ve tutarlı olmalı, kişinin adı sitede ve dış kaynaklarda aynı biçimde geçmelidir. Şema dışı bu doğrulama katmanını marka bahsi yazımızda anlattık. Varlık otoritesi ve entity sinyalleri üzerine ek okuma için The GEO Authority sitesine de bakabilirsiniz.
Yazar sayfası son yazılarını hasPart ile nasıl gösterir?
Yazar sayfası kişinin son yazılarını listeliyorsa, bu listeyi ProfilePage'in hasPart alanıyla işaretlemek Google'ın dokümanında gösterdiği yoldur. Her liste öğesi, tam içeriğin bulunduğu makale URL'sini ve author alanında aynı Person @id'sini taşır. Böylece profil sayfası ile makaleler birbirini iki yönden aynı kişiye bağlar.
Google'ın ProfilePage dokümanı "Technical guidelines" kısmında bunu tek cümleyle anlatıyor: profil sayfası yaratıcının son etkinliklerini de içeriyorsa, bu nesneleri tam içeriğin ve işaretlemenin bulunduğu sayfaya giden URL'lerle işaretleyebilirsiniz. Dokümandaki örnekte mainEntity bir Person, hasPart ise başlık, URL, yayın tarihi ve yazar referansı taşıyan bir Article dizisidir. Aynı yapı, yukarıdaki kurgusal yazar sayfasına şöyle uyarlanır:
{
  "@context": "https://schema.org",
  "@type": "ProfilePage",
  "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#profilepage",
  "mainEntity": { "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#person" },
  "hasPart": [
    {
      "@type": "BlogPosting",
      "headline": "Yapılandırılmış veri denetimi nasıl yapılır?",
      "url": "https://ornek.com.tr/blog/yapilandirilmis-veri-denetimi/",
      "datePublished": "2026-09-10T09:00:00+03:00",
      "author": { "@id": "https://ornek.com.tr/yazarlar/ayse-yilmaz/#person" }
    }
  ]
}
Bu işaretlemede üç kural işi kolaylaştırır:
- Yalnız listede görünen yazıları işaretleyin. Sayfada son 10 yazı görünüyorsa
hasPartde 10 öğe taşır. Google'ın genel yönergeleri, okuyucunun göremediği içeriğin işaretlenmemesini istiyor. - Liste öğelerini kısa tutun. Makalenin tam işaretlemesi makale sayfasında durur; profil sayfasındaki öğe başlık, URL, tarih ve yazar referansıyla yetinir.
- Yazar referansını tekrar tarif etmeyin. Öğelerdeki
authoryalnız{"@id": …}olur; unvan ve biyografi Person düğümünde bir kez yazılır.
Çok yazarlı sitelerde aynı mantık şablona taşınır. Google'ın dokümanı bu durum için ayrı bir kural koymuyor, ama "tek kişi ya da kurum odağı" şartı bir sonuç doğuruyor: her yazarın kendi URL'si ve kendi ProfilePage'i olmalı, bütün yazarları sıralayan dizin sayfası ise ProfilePage olarak işaretlenmemeli. Şablon tek bir yazar kaydını okur; @id'yi aynı ASCII fonksiyonuyla üretir, hasPart listesini de o yazarın sayfada görünen son yazılarından doldurur.
Yazar sayfası ile makaleler aynı kişiyi mi anlatıyor? Eylül 2026 öz-denetimimiz
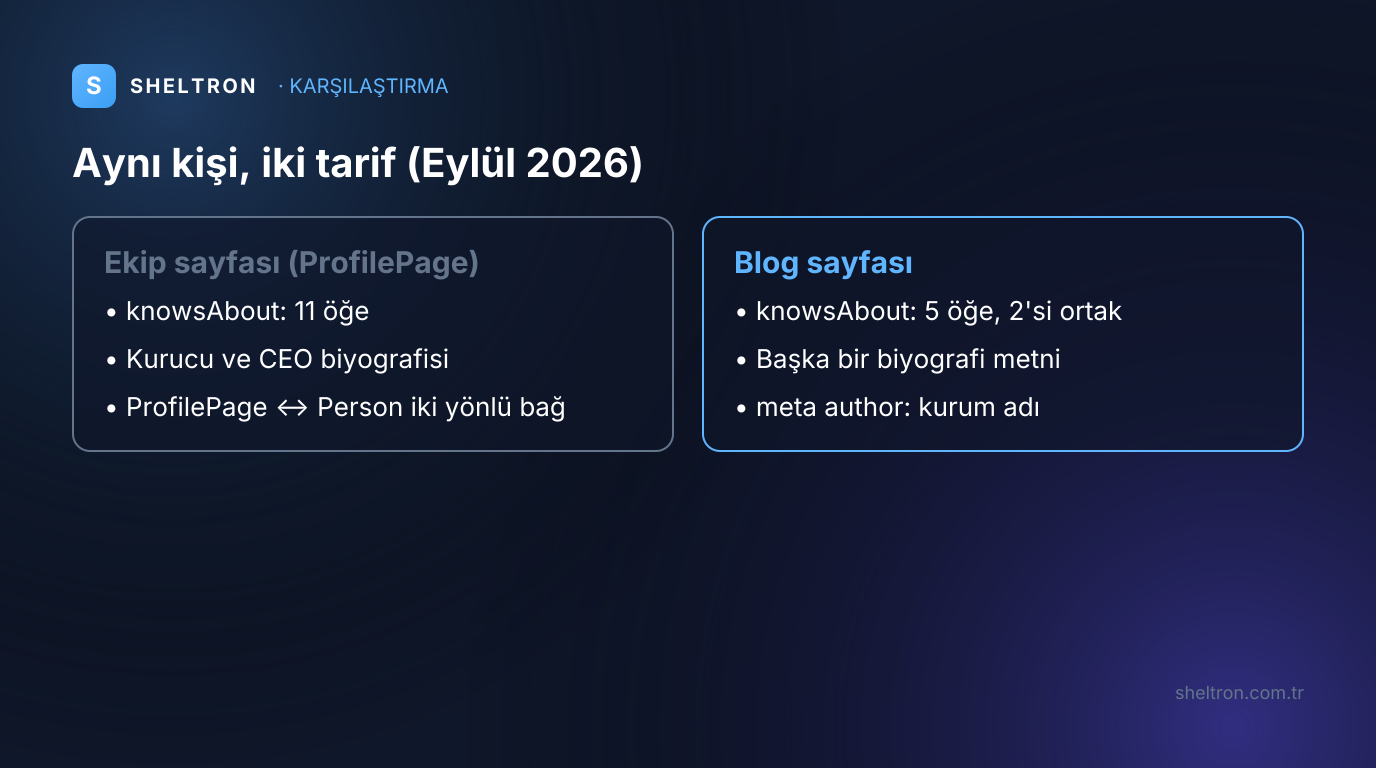
Kısmen. Eylül 2026'da ekip sayfamızı ve iki blog yazımızı curl ile çekip JSON-LD bloklarını karşılaştırdık. Üç sayfada da yazarın @id'si aynıydı: https://sheltron.com.tr/ekip/#eren-cop. Ancak bu kimliğin arkasındaki tarif sayfa türüne göre değişiyordu. Kimlik tekti, kişinin tanımı değildi.
Önce doğru kurulanlar. Ekip sayfamızda ProfilePage var; mainEntity yazara, yazarın mainEntityOfPage alanı da ProfilePage'e dönüyor, yani iki yönlü bir bağ kurulu. @id ASCII'ye normalize edilmiş. Makaledeki author alanı @id, url ve sameAs taşıyor; bu, Google'ın Article önerisiyle uyumlu. Görünür byline da ekip sayfasına bağlanıyor.
Aynı kişinin iki sayfa türündeki tarifi ise şöyleydi:
| Alan | Ekip sayfası (ProfilePage) | Blog yazıları (E-E-A-T yazısı ve schema.org rehberi) |
|---|---|---|
knowsAbout |
11 öğe | 5 öğe; yalnız 2'si ekip sayfasıyla ortak |
description |
Kurucu ve CEO rolüyle başlayan biyografi | SEO ve GEO deneyimiyle başlayan başka bir biyografi |
jobTitle |
"Kurucu & CEO" | "Kurucu & CEO" ve "Kurucu & GEO Stratejisti" |
Person image |
Yok | Yok |
meta name="author" |
Kurum adı | Kurum adı; şemadaki author ise kişi |
ProfilePage dateCreated / dateModified |
Yok | Uygulanmaz |
Açık kalanları yazar kimliği açısından şöyle özetleyebiliriz:
- İki uzmanlık listesi. Ortak iki öğe "Generative Engine Optimization" ve "AI Visibility". Birleşik küme 14 öğeye çıkıyor. Ekip sayfasındaki listede TÜBİTAK BİGG ve NVIDIA Inception gibi program adları da var; bunlar bir uzmanlık konusu değil, katılınan programlardır ve
knowsAboutyerine biyografide anlatılmaları daha doğrudur. - İki biyografi. Şemadaki
description, sayfa türüne göre farklı bir metinden geliyor. Google, şemanın sayfa içeriğinin doğru bir temsili olmasını istiyor; bu yüzden her sayfadakidescription, o sayfada görünen biyografiyle eşleşmeli. - Meta ile şema arasında fark. Blog sayfalarındaki
meta name="author"etiketi kurum adını, şemadakiauthorise kişiyi gösteriyor. - Eksik önerilen alanlar. Google'ın önerdiği ProfilePage tarihleri ve Person'daki profil fotoğrafı yok. 2023 duyurusu, profil fotoğrafını Google'ın işaretlemeden tanımaya çalıştığı bilgiler arasında sayıyordu.
Unvan farkı da aynı kökten geliyor: sayfa iskeletindeki kurucu tanımı ile CMS'teki yazar kaydı aynı @id'ye farklı unvan yazıyor ve JSON-LD 1.1 bir sayfadaki blokları tek veri kümesinde birleştirdiği için Eylül 2026 site taramamızda 235 blog yazısının 222'sinde kişi iki unvan taşıyordu. Bütün bu farkların ortak nedeni, kişinin üç ayrı kaynaktan tarif edilmesi: site yapılandırması, CMS'teki yazar kaydı ve blog şablonundaki sabit liste. Kalıcı çözüm, tarifi tek bir yazar kaydına indirmek ve diğer her yerde yalnız @id referansı vermektir.
Bir ödünleşimi de açıkça yazmak gerekiyor. Ekip sayfamızda ProfilePage'in name alanı "Eren Çöp & Ekip — Sheltron Teknoloji" diyor, ama görünür başlık ve H1 ekibi anlatıyor; sayfada departman listesi de var. Google'ın "tek kişi ya da kurum odağı" kuralına göre bu sınırda bir durum. İki yol var: her yazar için ayrı bir kişi sayfası açmak ya da ekip sayfasında tek bir kişiyi açık odak hâline getirmek. İlki daha temiz bir kimlik grafiği, ikincisi daha az sayfa ve bakım demek.
Bu bulgular Eylül 2026'ya ait; yazının yayımlandığı tarihte bir kısmı düzeltilmiş olabilir. Uzmanlık listelerini herkes şu komutla karşılaştırabilir:
for u in ekip/ blog/eeat-ve-yapay-zeka-ai-markaniza-neden-guvenir/; do
  curl -s "https://sheltron.com.tr/$u" | grep -o '"knowsAbout":\[[^]]*\]'
done
Eylül 2026'daki çıktıda her iki sayfada kurumun 8 öğelik listesinin yanında kişinin listesi görünüyordu: ekip sayfasında 11, blog yazısında 5 öğe. İki kişi listesi aynıysa sorun kapanmıştır.
Yazar şeması AI atfını garanti eder mi?
Hayır. Google, AI Overviews ve AI Mode'da görünmek için eklenmesi gereken özel bir schema.org işaretlemesi olmadığını açıkça yazıyor. Yazar şemasının işi atıf kazandırmak değil, görünür kimliği tutarlı ve makinece okunur kılmaktır. Atıf kararı büyük ölçüde içeriğin kendisine bağlı kalır. Aşağıdaki araştırmalar ve kendi Search Console verimiz de bu ayrımı destekliyor.
Google'ın AI özellikleri dokümanı bu konuda iki şey söylüyor: özel bir şema gerekmiyor ve yapılandırılmış verinin sayfadaki görünür metinle eşleşmesi gerekiyor. İkinci cümle, yazar şemasının asıl değerini tarif ediyor: görünür bilgiyle aynı olan, çelişmeyen bir kimlik.
Atıf tarafındaki araştırmalar da temkinli okunmalı. AirOps'un 1 Nisan 2026 tarihli "From Retrieved to Cited" raporu 7.500 ticari prompt üzerinden 217.508 getirilen sayfayı inceliyor ve ChatGPT'nin getirdiği sayfaların yalnızca %15'inin yanıtta atıf aldığını aktarıyor. Yani bir sayfanın okunması ile alıntılanması arasında büyük bir eleme var. Aynı şirketin 2025 çalışmaları, zengin şemanın ChatGPT'nin atıf verdiği sayfaların %61'inde, Google'ın ilk sayfa sonuçlarında ise %25'inde görüldüğünü; üç ya da daha fazla şema tipi kullanan sayfaların atıf alma olasılığının %13 daha yüksek olduğunu raporluyor. Bunlar korelasyon bulgularıdır, şemanın atıfa yol açtığını göstermez.
Sektörde yazar biyografisi ve Person şemasının AI atfını belirli bir yüzde artırdığı yönünde rakamlar da dolaşıyor. AirOps'un incelediğimiz üç raporunda (Temmuz 2025, Aralık 2025, Nisan 2026) yazar sinyalini ölçen bir bulgu yok; bu nedenle böyle bir yüzde kullanmıyoruz.
Sheltron verisi de aynı ayrımı gösteriyor. Search Console'a göre 9 Ağustos 2026'ya kadarki 12 ayda ekip sayfamız 702 gösterim ve 27 tık aldı, ortalama pozisyonu 3,12 oldu; "eren çöp" sorgusu ise 32 gösterimde 3,25 ortalama pozisyonla göründü. Microsoft Clarity'nin Ağustos 2026'da dışa aktarılan 365 günlük Copilot atıf listesinde 76 sayfamız yer alıyor, ancak ekip sayfası bu listede yok. Buna karşılık kurucuların LinkedIn görünürlüğünü anlatan rehberimiz 41 atıf aldı. Yorum basit: profil sayfası markalı aramada kimliği taşıyor, atıfı ise bir soruyu cevaplayan içerik alıyor. Bu veriden nedensellik çıkarmıyoruz.
Hangi içerik yapısının alıntılandığını LLM'lerin sayfanın neresinden alıntı yaptığını anlatan yazımızda inceledik. Yazar şeması o yapının yerini tutmaz; iyi bir içeriğin kimin elinden çıktığını doğrulanabilir kılar.
Yayından önce yazar kimliğini nasıl denetlersiniz?
Denetim üç soruya iner: kişi sitede tek bir @id ile mi tanımlı, şemadaki her bilgi sayfada görünüyor mu ve kimlik birkaç bağımsız profille doğrulanıyor mu? Aşağıdaki kontrol listesi ve hata tablosu, bu soruları her yayın öncesinde kısa bir rutine çevirir.
Kontrol listesi:
- Her yazarın tek, kalıcı bir yazar sayfası ve bu sayfada ProfilePage ile Person işaretlemesi var.
- Yazarın
@id'si mutlak URL, ASCII karakterli ve sitenin her yerinde aynı fonksiyonla üretiliyor. - Makalelerde
authoryalnız@id,nameveurltaşıyor; unvan ve biyografi yazar sayfasından tekrar edilmiyor. namealanında unvan ya da kurum adı yok; birden fazla yazar dizi olarak yazılıyor.- Şemadaki
jobTitle,descriptionveknowsAboutsayfada görünen metinle birebir aynı. sameAsen az birkaç bağımsız profili gösteriyor ve bu profiller güncel.- Sayfa düzeyindeki bütün JSON-LD blokları birleştirildiğinde kişinin tek bir unvanı kalıyor.
En sık karşılaşılan hatalar ve düzeltmeleri:
| Yanlış | Neden sorun | Doğru |
|---|---|---|
Makalede #ayse-yılmaz, yazar sayfasında #ayse-yilmaz |
JSON-LD işlemcisi @id'leri dize olarak eşler; iki ayrı düğüm, iki kişi |
Tek bir ASCII slug fonksiyonu |
"name": "Dr. Ayşe Yılmaz, Kıdemli Analist" |
Google, author.name içine unvan yazılmamasını istiyor |
name, jobTitle ve honorificPrefix ayrı alanlarda |
"author": {"name": "Ayşe Yılmaz, Can Kaya"} |
İki yazar tek kişiye dönüşüyor | author dizisi, her yazar ayrı nesne |
Aynı sayfada üç blokta aynı yazar @id'si, farklı jobTitle |
Bloklar birleşir, kişi iki unvan taşır | Tek tam tanım, diğer bloklarda yalnız {"@id": …} |
Şemada knowsAbout var, sayfada uzmanlık alanı yok |
Görünmeyen içerik işaretlenmez | Biyografide aynı alanlar görünür |
sameAs boş ya da yalnız şirket sayfaları |
Bağımsız doğrulama zinciri kurulmuyor | LinkedIn, ORCID, varsa Wikidata ve bağımsız yayın sayfaları |
Test için üç katman yeterli. Google'ın Zengin Sonuçlar Testi sözdizimini ve zorunlu alanları gösterir. Sheltron Şema Doğrulayıcı ikinci bir kontrol sağlar; sık görülen şema hatalarını ve düzeltmelerini şema hataları rehberimizde tek tek açıkladık. Birleşim sorunlarını ise ancak sayfanın bütün bloklarını bir JSON-LD işlemcisinde birlikte düzleştirerek ya da yukarıdaki gibi yazar sayfasıyla bir makalenin çıktısını yan yana koyarak görebilirsiniz. Ekibinizin yapılandırılmış veriyi sistematik öğrenmesi gerekiyorsa GEO Akademi bu konuda eğitim içerikleri sunuyor.
Yazar kimliği bir kez doğru kurulduğunda, her yeni makale kendiliğinden aynı kişiye bağlanır. Markanızın ve yazarlarınızın yapay zeka yanıtlarında nasıl tanındığını görmek isterseniz, Sheltron'un hızlı değerlendirmesiyle başlayabilir, sürekli izleme için AiSEO platformuna göz atabilirsiniz.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- ProfilePage ve Person Şeması: Yazar Sayfasını AI İçin Doğrulanabilir Kimliğe Çevirmek
- TL;DR
- ProfilePage bir sayfa tipidir, Person ise o sayfanın anlattığı kişi. Kişi yazar sayfasında bir kez tanımlanır, makaleler onu @id ve url ile çağırır. schema.org'un Ağustos 2026 sayımına göre Person 10 milyondan fazla, ProfilePage 1-10 milyon alan adında kullanılıyor. Web Almanac 2024'e göre mobil sayfaların yalnızca %1,11'i sameAs ile LinkedIn'e bağlanıyor. Google, AI özellikleri için özel şema gerekmediğini yazıyor; yazar şeması atıf garantisi değil, tutarlı kimlik aracıdır.
- Ana Çıkarımlar (7)
- ProfilePage bir sayfa tipidir, Person ise varlıktır; Google'da tek zorunlu alan mainEntity, onun tek zorunlu alanı name.
- Google'ın Article dokümanı, author.url dahili bir profil sayfasıysa yazarın ProfilePage ile işaretlenmesini öneriyor; sameAs alternatif olarak kabul ediliyor.
- schema.org'un Ağustos 2026 sayımına göre Person 10 milyondan fazla, ProfilePage ve knowsAbout 1-10 milyon, hasCredential 100 bin-1 milyon alan adında kullanılıyor.
- Web Almanac 2024'e göre mobil sayfaların yalnızca %1,11'i sameAs ile LinkedIn'e, %0,17'si Wikidata'ya bağlanıyor.
- JSON-LD işlemcileri @id'leri dize olarak eşler; RFC 3987 de kod noktası bazında karşılaştırma ister, bu yüzden #eren-çöp ile #eren-cop iki ayrı Person düğümü üretir.
- Eylül 2026 öz-denetimimizde aynı yazar @id'si ekip sayfasında 11, blog sayfalarında 5 knowsAbout öğesi taşıyordu; yalnız 2'si ortaktı.
- Google, AI Overviews ve AI Mode için özel şema gerekmediğini yazıyor; AirOps'a göre ChatGPT'nin getirdiği sayfaların yalnızca %15'i atıf alıyor.
- Kaynaklı Veriler
- 10M+ — Person tipini kullanan alan adı aralığı (Google web dizini, Ağustos 2026) (schema.org — Person, 2026)
- 1M–10M — ProfilePage tipini kullanan alan adı aralığı (Google web dizini, Ağustos 2026) (schema.org — ProfilePage, 2026)
- 100K–1M — hasCredential özelliğini kullanan alan adı aralığı (Ağustos 2026) (schema.org — hasCredential, 2026)
- %41 — JSON-LD barındıran web sayfalarının oranı (2022'de %34) (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %1,11 — sameAs ile LinkedIn'e bağlanan mobil sayfa oranı (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %0,17 — sameAs ile Wikidata'ya bağlanan mobil sayfa oranı (Wikipedia: %0,13) (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %15 — ChatGPT'nin getirdiği sayfalardan yanıtta atıf alanların payı (217.508 sayfa, 7.500 ticari prompt) (AirOps — From Retrieved to Cited, 2026)
- %61 — zengin şemanın ChatGPT'nin atıf verdiği sayfalarda görülme oranı (Google ilk sayfa URL'lerinde %25; korelasyon) (AirOps — Structuring Content for LLMs, 2025)
- %13 — üç ya da daha fazla şema tipi kullanan sayfaların daha yüksek atıf alma olasılığı (korelasyon) (AirOps — The 2026 State of AI Search, 2025)
- 702 — sheltron.com.tr ekip sayfasının 12 aylık Google gösterimi (27 tık, ortalama pozisyon 3,12; 9 Ağustos 2026'ya kadar) (Sheltron verisi — Google Search Console, Sayfa sayısı.csv (Ağustos 2026), 2026)
- 41 — kurucular için LinkedIn görünürlük rehberimizin Microsoft Copilot'tan aldığı atıf (365 gün; ekip sayfası 76 sayfalık atıf listesinde yok) (Sheltron verisi — Microsoft Clarity, Copilot atıf dışa aktarımı (Ağustos 2026), 2026)
- Arama Niyetleri
- profilepage schema
- person schema yazar
- author schema nasıl eklenir
- yazar sayfası e-e-a-t
- knowsabout schema
- article author @id
- yazar sayfası yapılandırılmış veri
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz