LLM Eğitim Verisinde Türkçe Oranı: Common Crawl'da %1,28 ve 425 Türk Sitesinin Eylül 2026 Ölçümü
LLM'lerin en yaygın ham kaynağı Common Crawl'da Türkçenin payını 2018-2026 arasındaki 77 taramada izledik; Türkiye'nin en çok ziyaret edilen 425 sitesinin Eylül 2026 taramasındaki kayıtlarını ve robots.txt'teki CCBot kararlarını ölçtük.
💡Kısa Özet
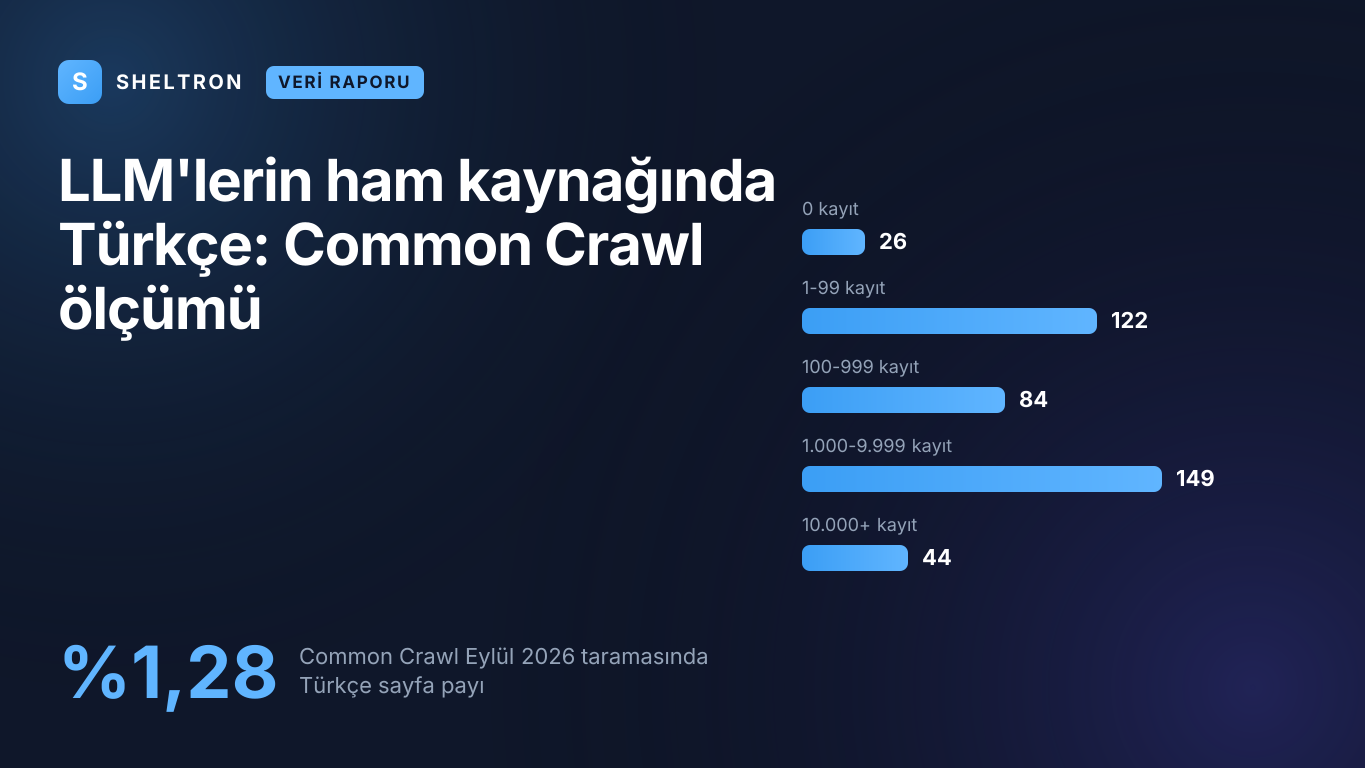
Common Crawl'ın Eylül 2026 taramasında sayfaların %1,28'i (27,7 milyon) Türkçe; İngilizce bunun 32,8 katı. Dil dağılımını yayımlayan modellerde pay çok daha düşük: GPT-3'te %0,059, Llama 2'de %0,005'in altında. Türkiye'nin en çok ziyaret edilen 425 sitesinin medyanı 598 kayıt, %34,8'i 100'den az kayıtla temsil ediliyor; geçerli robots.txt'i olan 350 siteden yalnız 15'i CCBot'u engelliyor.
Ana Çıkarımlar
- •Common Crawl'ın Eylül 2026 taramasında (CC-MAIN-2026-39) birincil dili Türkçe olan sayfaların payı %1,28 (27,7 milyon sayfa); Türkçe diller arasında 12. sırada ve İngilizce 32,8 kat fazla.
- •Türkçenin Common Crawl'daki yıllık ortalama payı 2023'te %0,84 iken 2026'da %1,27; ancak tarama başına Türkçe sayfa sayısı yıllardır 20-36 milyon aralığında.
- •Dil dağılımını yayımlamış modellerde Türkçe çok daha az: GPT-3'te kelimelerin %0,059'u, Llama 2'de %0,005 listelenme eşiğinin altında; güncel modellerin dağılımı bilinmiyor.
- •Türkiye'nin en çok ziyaret edilen 425 sitesinin Eylül 2026 taramasındaki medyan kaydı 598; %34,8'i 100'den az kayıtla temsil ediliyor, kayıtların %64,2'si en büyük 43 sitede.
- •Geçerli robots.txt'i olan 350 siteden yalnız 15'i (%4,3) CCBot'u engelliyor; GPTBot'u engelleyen 24 sitenin 14'ü CCBot'u açık bırakıyor.
- •sheltron.com.tr CCBot'a açık olmasına rağmen canlıdaki 234 blog yazısından yalnız 40'ı (%17,1) Eylül 2026 taramasında yakalandı: izin vermek taranmayı garanti etmiyor.
Eylül 2026 itibarıyla Common Crawl'ın en güncel taraması olan CC-MAIN-2026-39'da birincil dili Türkçe olan HTML sayfaların payı %1,28: 2,17 milyar sayfanın 27,7 milyonu. Common Crawl, açık ve ticari dil modellerinin büyük bölümünün ön eğitimde kullandığı ham web arşividir. Bu yüzden %1,28, "LLM eğitim verisinde Türkçe oranı" sorusuna verilebilecek en yakın ölçülebilir cevaptır; ancak herhangi bir modelin eğitim karışımıyla aynı şey değildir. Dil dağılımını yayımlamış modellerde Türkçenin payı çok daha düşüktür: GPT-3'te kelimelerin %0,059'u, Llama 2'de ise listelenme eşiği olan %0,005'in altı.
Sheltron olarak bu yazı için Eylül 2026'da üç ölçüm yaptık. Common Crawl'ın 2018-2026 arasındaki 77 taramasına ait dil istatistiğinden Türkçe payının seyrini çıkardık. Türkiye'nin en çok ziyaret edilen 425 sitesinin Eylül 2026 taramasında kaç kayıtla yer aldığını Common Crawl'ın indeks dosyalarından tek tek saydık. Aynı sitelerin robots.txt dosyalarında CCBot kararını okuduk. Yazı, "Türkçe AI cevapları neden zayıf kalıyor?" sorusuna eğitim verisi tarafından bakıyor. Cevap anında hangi kaynakların gösterildiğini ise Türkçe sorgularda LLM'lerin hangi kaynakları gösterdiği yazısında ayrıca ele aldık.
LLM'lerin eğitim verisinde Türkçe ne kadar yer tutuyor?
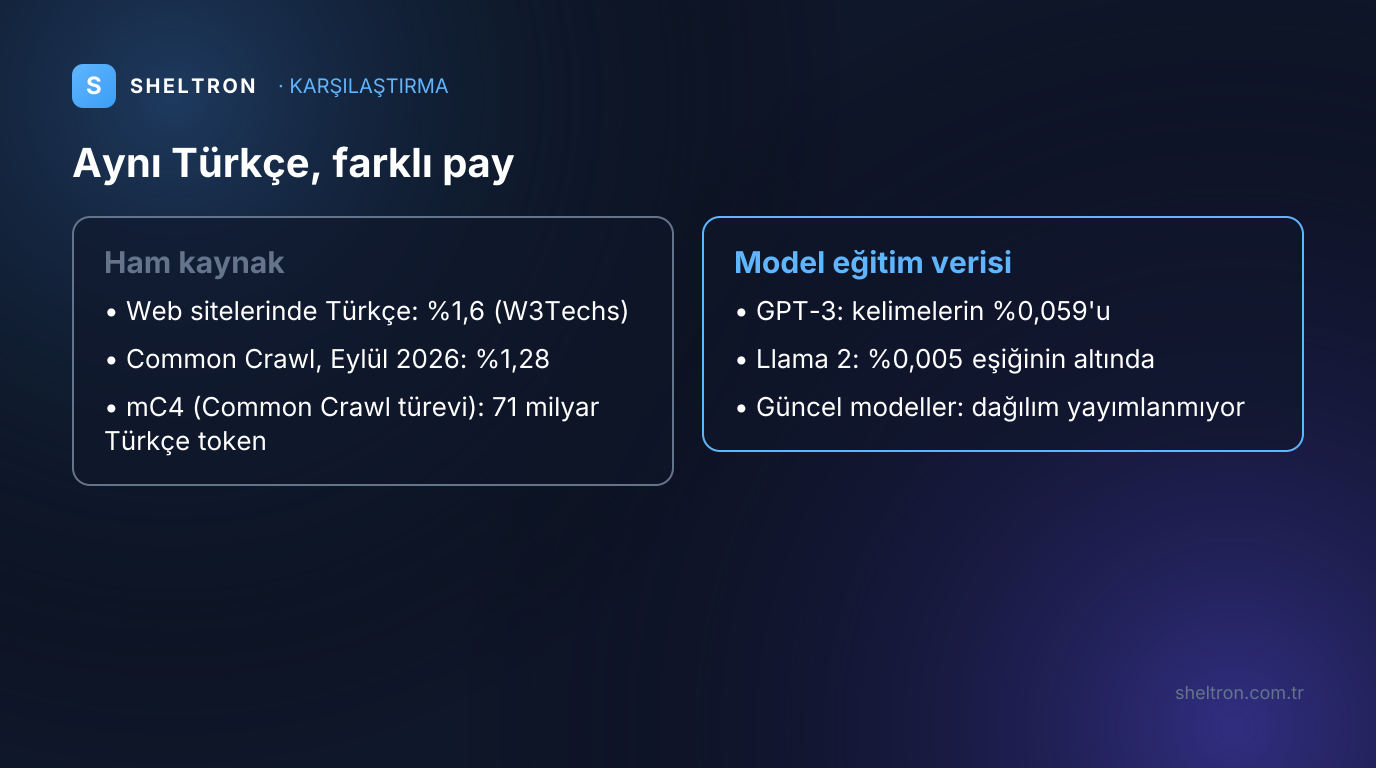
Doğrudan ölçülebilen en büyük halka açık havuz olan Common Crawl'da Türkçe, Eylül 2026 taramasında sayfaların %1,28'ini oluşturuyor. Dil dağılımını yayımlamış modellerde pay çok daha düşük: GPT-3'ün eğitim verisinde Türkçe kelimelerin %0,059'u, Llama 2'nin ön eğitim verisinde %0,005'in altında. Güncel modellerin dil dağılımı ise bilinmiyor.
Aynı dilin farklı aşamalarda ne kadar farklı bir paya sahip olduğunu görmek için aşağıdaki tabloyu kaynaklarıyla birlikte derledik:
| Aşama | Türkçe payı | Neyi ölçüyor | Kaynak (yıl) |
|---|---|---|---|
| Web siteleri | %1,6 (11. sıra) | İçerik dili bilinen web sitelerinin payı | W3Techs (Eylül 2026) |
| Common Crawl ham arşivi | %1,28 (12. sıra) | Birincil dili Türkçe olan HTML sayfalar | Common Crawl, CC-MAIN-2026-39 (2026) |
| mC4 (Common Crawl türevi) | %1,1 | 6,3 trilyon token içinde 71 milyar Türkçe token (Sheltron hesabı) | Xue ve ark., mT5 (2020) |
| mT5 eğitim örneklemesi | %1,93 | Modelin eğitiminde Türkçeye verilen örnekleme ağırlığı | Xue ve ark. (2020) |
| GPT-3 eğitim verisi | %0,059 | Kelime payı; 118 dil içinde 20. sıra | OpenAI veri istatistiği (2020) |
| Llama 2 ön eğitim verisi | %0,005'in altında | İngilizce dışında payı %0,005'i aşan 26 dil listelenmiş, Türkçe yok | Touvron ve ark., Meta (2023) |
Tablodaki birimler farklı: site, sayfa, token ve kelime aynı şeyi saymıyor, bu yüzden satırlar birbirinden çıkarılamaz. Yön ise açık. Türkçe, web'den Common Crawl'a geçerken payının büyük kısmını koruyor; asıl küçülme, model geliştiricilerin ham arşivi filtreleyip eğitim karışımını oluşturduğu aşamada yaşanıyor.
GPT-3 ve Llama 2 rakamlarının eski modellere ait olduğunu da açıkça söylemek gerekir. OpenAI, Anthropic ve Google güncel modellerinin eğitim verisindeki dil dağılımını yayımlamıyor. "ChatGPT'nin eğitim verisinde Türkçe yüzde kaç?" sorusunun Eylül 2026 itibarıyla doğrulanabilir bir cevabı yok; doğrulanabilen tek halka açık ölçü, ham kaynaktaki %1,28'lik paydır. Şirketlerin kendi tarayıcılarıyla (GPTBot, ClaudeBot gibi) topladığı verinin dil dağılımı da bilinmiyor.
Common Crawl nedir ve neden LLM eğitim verisinin temeli sayılıyor?
Common Crawl, web'i düzenli aralıklarla tarayıp arşivini herkese ücretsiz açan kâr amacı gütmeyen bir kuruluştur; tarayıcısının adı CCBot'tur. Mozilla Vakfı'nın incelemesine göre 2019 ile Ekim 2023 arasında yayımlanan 47 metin üretim modelinin en az %64'ü, yani 30'u, ön eğitimde Common Crawl'ın filtrelenmiş bir sürümünü kullandı.
Bu arşivin ölçeği her taramada birkaç milyar sayfadır. Common Crawl'ın Eylül 2026 duyurusuna göre CC-MAIN-2026-39, 4-17 Eylül 2026 arasında toplandı ve 2,17 milyar sayfa (sıkıştırılmamış 361,4 TiB) içeriyor. Sayfalar 40,4 milyon host ve 33,2 milyon kayıtlı alan adından geliyor. Common Crawl yeni taramalarını düzenli aralıklarla yayımladığı için bu yazıyı okuduğunuz tarihte daha yeni bir tarama bulunabilir; buradaki rakamlar Eylül 2026 itibarıyla en güncel taramaya aittir.
Common Crawl'ın model eğitimindeki ağırlığını en net gösteren belge hâlâ GPT-3 makalesidir. Brown ve arkadaşlarının 2020 makalesine göre GPT-3'ün eğitim karışımında filtrelenmiş Common Crawl 410 milyar token ile %60 ağırlığa sahipti; kalan pay WebText2, iki kitap veri seti ve Wikipedia arasında bölünüyordu. Kullanılan 41 aylık tarama parçası (2016-2019) filtrelemeden önce 45 TB, filtrelemeden sonra 570 GB sıkıştırılmış düz metindi. Yani ham arşivin çok küçük bir kısmı modele ulaştı.
Stefan Baack'ın ACM FAccT 2024'te yayımlanan çalışması Common Crawl'ı "en büyük ücretsiz web tarama verisi koleksiyonu ve büyük dil modellerinin ön eğitim verisinin en önemli kaynaklarından biri" olarak tanımlıyor. Aynı araştırmanın Mozilla Vakfı'ndaki özeti ise Türkçe açısından kritik bir tespit içeriyor: Common Crawl'ın en popüler filtrelenmiş sürümleri yalnızca İngilizce, arşivin dil ve bölge kapsamı da İngilizceye doğru belirgin biçimde eğik.
Açık veri setleri bu tabloyu kısmen değiştirdi. Hugging Face'in FineWeb-2 veri seti, 2013 yazından Nisan 2024'e uzanan 96 Common Crawl taramasından 1.868 dil-yazı çifti çıkarıyor. Türkçe alt kümesi 95,1 milyon belge ve 41,9 milyar kelimeyle boyuta göre 15. sırada; Türkçe, veri setinin kalite deneylerinde kullanılan 9 dilden biri. Karşılaştırma için Rusça alt küme 588,6 milyar kelime. Ticari modellerin bu tür açık setleri ne ölçüde kullandığı ise yayımlanmıyor.
Türkçenin Common Crawl'daki payı 2018'den bu yana nasıl değişti?
Türkçenin yıllık ortalama payı 2018-2023 arasında %0,84 ile %1,00 arasında gezinirken 2024'ten itibaren %1,15-1,27 bandına çıktı; 2026'daki dokuz taramanın hepsinde Türkçe 12. sırada. Tarama başına Türkçe sayfa sayısı ise yıllar boyunca 20-36 milyon aralığında kaldı.
Common Crawl, her HTML sayfanın dilini CLD2 (Compact Language Detector 2) ile belirliyor ve sayfanın birincil dilini sayıyor. Bu istatistiğin ham dosyasındaki 77 taramanın Türkçe satırlarını yıllara göre topladık:
| Yıl (tarama sayısı) | Türkçe payı, yıllık ortalama | Türkçenin sırası |
|---|---|---|
| 2018 (5) | %0,90 | 13 |
| 2019 (12) | %0,87 | 13 |
| 2020 (9) | %0,90 | 13 |
| 2021 (9) | %1,00 | 13 |
| 2022 (6) | %0,86 | 13-14 |
| 2023 (5) | %0,84 | 14-15 |
| 2024 (10) | %1,19 | 12-14 |
| 2025 (12) | %1,15 | 12-13 |
| 2026 (9, Eylül'e kadar) | %1,27 | 12 |
Kaynak: Common Crawl languages.csv, Eylül 2026 kopyası; yıllık ortalama ve sıra Sheltron hesabı ("bilinmeyen" dil satırı hariç).
2026'daki en yüksek değer CC-MAIN-2026-34 taramasındaki %1,36; Eylül 2026 taraması %1,28'e geriledi. Aynı taramada Lehçe %2,03, Felemenkçe %1,74, Çekçe %1,13 paya sahip. İngilizce ise %41,86 ile Türkçenin 32,8 katı.
Payın yükselmesini "Türkçe içerik arttı" diye okumak yanlış olur. Mutlak sayıya bakınca tablo değişiyor: tarama başına Türkçe sayfa sayısı en düşük CC-MAIN-2019-51'de 20,3 milyon, en yüksek CC-MAIN-2025-05'te 35,6 milyon ve Eylül 2026'da 27,7 milyon. Aynı dönemde toplam tarama boyutu küçüldü; CC-MAIN-2018-34'te 2,69 milyar sayfa varken Eylül 2026'da 2,17 milyar sayfa var. Türkçenin payını büyüten asıl etken, toplam küçülürken Türkçe sayfa sayısının yerinde kalması. Bunun Common Crawl'ın tarama politikasındaki hangi değişiklikten kaynaklandığı bilinmiyor.
Bir ayrıntı daha önemli: .tr uzantılı URL'ler aynı taramada 9,41 milyon sayfayla URL'lerin yalnız %0,43'ünü oluşturuyor. Bu, Türkçe sayfaların ancak üçte biri kadar. Türkçe web'in büyük bölümü .com ve diğer uzantılarda yaşıyor; Türkçe içeriği yalnız .tr alan adları üzerinden izlemek resmin çoğunu kaçırır.
Türkçe neden web'de ve Common Crawl'da benzer, modellerde çok daha düşük pay alıyor?
Web sitelerinde Türkçenin payı (%1,6) ile Common Crawl'daki Türkçe sayfa payı (%1,28) aynı büyüklükte; ham arşiv Türkçeyi web'deki ağırlığına yakın temsil ediyor. Türkçenin küçüldüğü yer, model geliştiricilerin arşivi dil ve kalite filtrelerinden geçirip eğitim karışımını ağırlıklandırdığı aşama.
Önce karşılaştırmanın sınırını koyalım. W3Techs site sayar, Common Crawl sayfa sayar; iki rakam aynı birimde değil. Yine de ikisinin aynı büyüklükte olması, Türkçenin ham arşive girerken sistematik olarak dışarıda bırakılmadığını gösteriyor. Sorun toplama aşamasında değil.
Kaybın nerede yaşandığını GPT-3 örneği gösteriyor. Common Crawl'ın dil istatistiğinin başladığı 2018 ve 2019 taramalarında Türkçenin yıllık ortalama payı %0,87-0,90 idi. Bu taramaları da kapsayan veriyle eğitilen GPT-3'te Türkçe kelime payı %0,059; yani o dönemdeki ham payın yaklaşık on beşte biri. GPT-3 makalesi eğitim verisinin kelime sayısına göre %93'ünün İngilizce olduğunu açıkça yazıyor. Aradaki fark, ham arşivin filtrelenmesinden ve eğitim karışımının ağırlıklandırılmasından geliyor; Mozilla'nın özetine göre en popüler filtrelenmiş Common Crawl sürümleri zaten yalnız İngilizce.
mT5 örneği ise bunun bir tercih olduğunu gösteriyor. Google'ın çok dilli modeli için hazırlanan mC4 veri setinde Türkçe 71 milyar token ve 88 milyon sayfayla sayfa sayısına göre 10. sırada; toplam 6,3 trilyon token içinde yaklaşık %1,1. Araştırmacılar düşük kaynaklı dilleri yukarı çeken bir örnekleme uyguladığı için Türkçe, mT5'in eğitiminde %1,93 ağırlık aldı. Aynı ham kaynaktan yola çıkıldığında Türkçenin payı, verilen karara göre on beş kat küçülebiliyor ya da yaklaşık 1,75 kat büyüyebiliyor.
Türkçenin bir modelin eğitim verisindeki payını web'deki varlığı değil, model geliştiricinin filtre ve örnekleme kararı belirler. Llama 2 aynı yönde bir örnek: Meta'nın makalesindeki dil tablosunda İngilizce %89,70, "bilinmeyen" (büyük ölçüde kod) %8,38; tabloda İngilizce dışında payı %0,005'i aşan 26 dil var, Türkçe bu listede yer almıyor.
Bu tablonun Türk markalar için pratik anlamı şu: Türkçe içeriğin modelin "bilgisine" girme ihtimali, aynı içeriğin İngilizce karşılığına göre belirgin biçimde düşük. İhracat yapan markalar için İngilizce içerik bu yüzden ayrı bir görünürlük kanalıdır; bu konuyu çok dilli GEO ve ihracatçı Türk markaları yazısında ayrıntılı ele aldık.
Türkiye'nin en çok ziyaret edilen 425 sitesi Eylül 2026 taramasında nasıl temsil ediliyor?
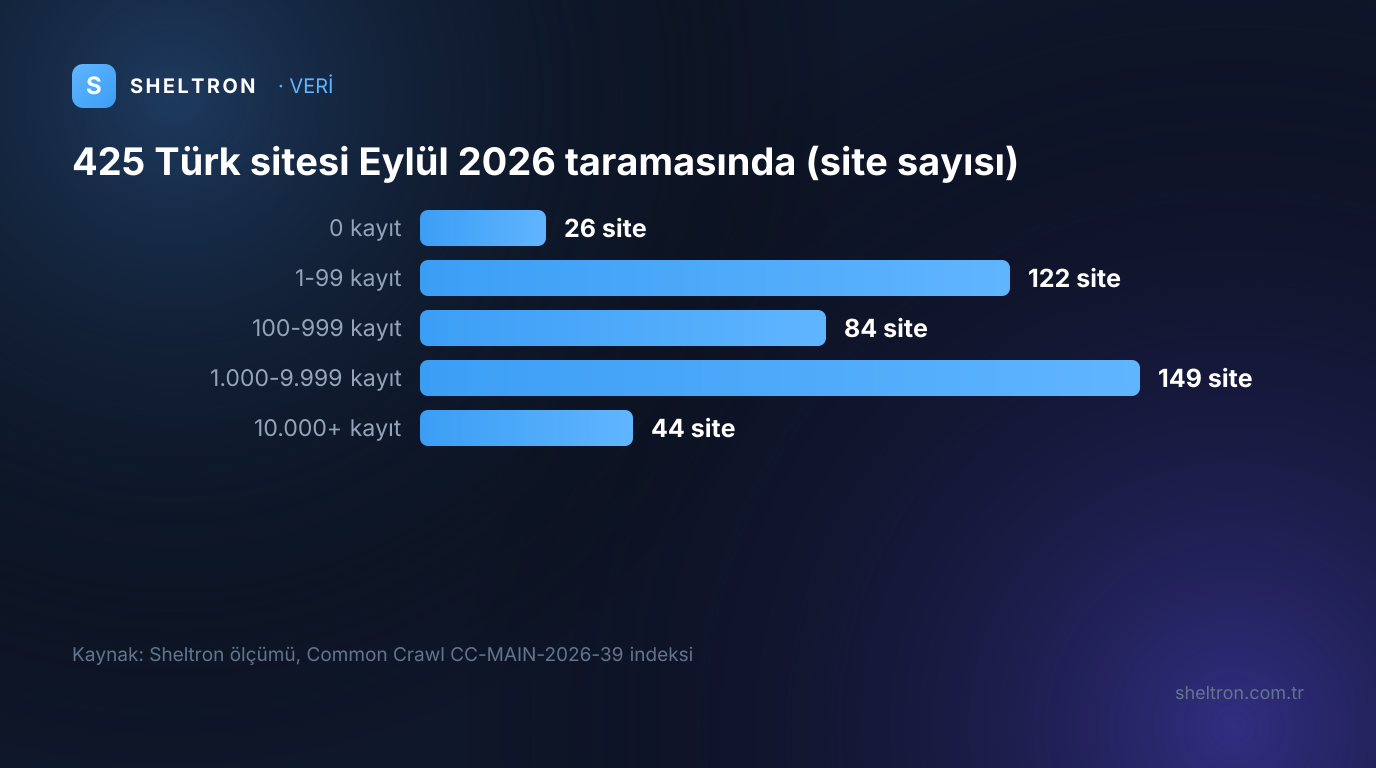
Dengesiz biçimde. 425 site Eylül 2026 taramasında toplam 1,43 milyon kayıtla yer alıyor, ama site başına medyan yalnız 598 kayıt. Sitelerin %34,8'i (148 site) 100'den az kayıtla temsil ediliyor, 26'sı hiç yok. Kayıtların %64,2'si en büyük 43 sitede toplanırken alt yarıdaki 212 sitenin payı %1,40.
Örneklem, Chrome UX Report'un Ağustos 2026 Türkiye listesinde en çok ziyaret edilen 1.000 origin'den süzülen, Türkiye'ye yönelik 432 alan adından geliyor. Bunlardan ana sayfası başka bir örneklem alan adına ya da küresel bir alan adına yönlenen 7'sini (ör. garanti.com.tr, google.com.tr) analiz dışında bıraktık; kalan 425 site 392 yerli marka ile 33 küresel markanın Türkiye sitesinden oluşuyor. Her alan adının ve alt alan adlarının CC-MAIN-2026-39'daki kayıtlarını Common Crawl'ın halka açık ZipNum indeks dosyalarından okuyup satır satır saydık; tahmin yok, 425 alan adının hepsi hatasız ölçüldü. Common Crawl'ın CDX sunucusunun hatasız cevap verdiği 70 alan adının 69'unda sonuç iki yöntemde birebir aynı çıktı. "Kayıt", bir URL'nin taramada bir kez çekilmesi anlamına geliyor; yönlendirmeler ve 200 dışı cevaplar da dahil. Kayıtların %87,4'ü HTTP 200 dönüyor. 200 dönen ve dil etiketi olan kayıtların %91,6'sı Türkçe, %6,9'u İngilizce.
| Eylül 2026 taramasındaki kayıt | Site sayısı | Pay |
|---|---|---|
| 0 | 26 | %6,1 |
| 1-99 | 122 | %28,7 |
| 100-999 | 84 | %19,8 |
| 1.000-9.999 | 149 | %35,1 |
| 10.000+ | 44 | %10,4 |
Kaynak: Sheltron ölçümü, Common Crawl CC-MAIN-2026-39 indeksi, n=425, Eylül 2026.
En çok kayıtla temsil edilen siteler milliyet.com.tr (58.269), mynet.com (48.470), donanimhaber.com (45.145), saglik.gov.tr (43.804) ve hurriyet.com.tr (41.864). Sıfır kayıtlı 26 site arasında t24.com.tr, mhrs.gov.tr, antoloji.com ve tuvturk.com.tr var. Sıfırın nedenini site bazında ölçmedik; tarama bütçesi, bot engeli ya da JavaScript'e dayalı sayfa yapısı gibi birden fazla açıklama mümkün.
Sektörler arasında fark büyük: haber-medya en yüksek medyana sahip, oyun ve telekom-yazılım en düşük. Tabloda en az 10 sitesi olan 11 sektörün tamamı var; daha küçük dört sektör (otomotiv, sağlık, yasal şans oyunları, lojistik; 31 site) dışarıda:
| Sektör | Site sayısı | Medyan kayıt |
|---|---|---|
| Haber-medya | 96 | 3.773,5 |
| Seyahat-etkinlik | 21 | 1.930 |
| Eğitim | 14 | 1.380,5 |
| E-ticaret-perakende | 103 | 804 |
| İçerik-topluluk | 28 | 625 |
| İlan-platform | 12 | 566,5 |
| Kamu | 46 | 390,5 |
| Finans | 26 | 352,5 |
| Telekom-yazılım | 26 | 50 |
| Oyun | 12 | 1,5 |
| Diğer | 10 | 0 |
n=425. Çift sayıda sitesi olan sektörde medyan, ortadaki iki değerin ortalamasıdır.
Yerli sitelerin medyanı 549,5, küresel markaların Türkiye sitelerinin medyanı 680 kayıt; köken belirgin bir fark yaratmıyor.
Bu 425 sitenin 200 dönen Türkçe kayıtlarının toplamı 1.112.760. Bu, aynı taramadaki 27,74 milyon Türkçe sayfanın yalnız %4,01'i (iki rakam da CC'nin dil etiketine dayanıyor ama biri kayıt, diğeri sayfa sayımı). Türkiye'nin en çok ziyaret edilen 425 sitesi, Common Crawl'daki Türkçe havuzun yalnızca yirmi beşte birini oluşturuyor; geri kalanı uzun kuyruktan geliyor.
Kendi sitemizi de aynı yöntemle ölçtük. sheltron.com.tr, robots.txt dosyasında CCBot'a açıkça izin veriyor. Buna rağmen Eylül 2026'da canlıda olan 234 blog yazısının yalnız 40'ı (%17,1) bu taramada 200 koduyla yakalandı; ayrıca artık canonical ile başka yazılara yönlenen 4 eski blog URL'si de taramadaydı. Sitenin toplam kaydı 78. İzin vermek taranmayı garanti etmiyor; hangi URL'nin hangi taramaya gireceğine Common Crawl karar veriyor. Mozilla'nın özetine göre her taramanın yaklaşık yarısı, önceki taramalarda çekilmiş URL'lerden oluşuyor.
Türk siteleri CCBot'u engelliyor mu?
Çok az. Geçerli robots.txt'i olan 350 siteden yalnız 15'i (%4,3) CCBot'u tamamen engelliyor ve hepsi bunu CCBot'u adıyla anarak yapıyor. GPTBot'u tamamen engelleyen 24 sitenin 14'ü ise CCBot'u açık bırakıyor; bu sitelerin içeriği OpenAI'nin tarayıcısına kapalıyken Common Crawl arşivine girmeye devam ediyor.
Aynı 425 sitenin robots.txt dosyalarını Eylül 2026'da okuduk. Bot adına özel bir grup varsa o grubu, yoksa User-agent: * grubunu uyguladık ve kök dizini (Disallow: /) kapatan kuralı tam engel saydık. 75 sitenin robots.txt'i okunamadı (403, 404, ağ hatası ya da HTML dönen yanıt); bunlar paydaya girmedi.
| robots.txt durumu | Site | Pay (n=350) |
|---|---|---|
| CCBot tamamen engelli | 15 | %4,3 |
| CCBot adıyla anılıyor, tam engel yok | 15 | %4,3 |
| CCBot adı hiç geçmiyor | 320 | %91,4 |
| Karşılaştırma: GPTBot tamamen engelli | 24 | %6,9 |
| GPTBot engelli, CCBot açık | 14 | %4,0 |
Kaynak: Sheltron ölçümü, 425 sitenin robots.txt dosyası, Eylül 2026.
Engel etkili ama mutlak değil. CCBot'u engelleyen 15 sitenin medyan kaydı 5, engellemeyen 335 sitenin medyanı 974. Buna karşın amazon.com.tr 1.077, meb.gov.tr 1.660 kayıtla taramada yer alıyor. Kayıtlar www. dışındaki alt alan adlarından geliyor: amazon.com.tr'nin 200 dönen 1.039 kaydının 795'i gelirortakligi., 176'sı satis. alt alan adından, yalnız 27'si www. üzerinden. Bu iki alt alan adının robots.txt'i CCBot'u engellemiyor; gelirortakligi. 404 dönüyor, satis. yalnız bazı yolları kapatıyor. meb.gov.tr'de de www. yalnız 5 kayıt veriyor, gerisi il ve birim alt alan adlarından. robots.txt host bazında çalışır; ana alan adındaki kural alt alan adlarını kapsamaz.
GPTBot'u engelleyip CCBot'u açık bırakan 14 sitenin çoğu haber yayıncısı; milliyet.com.tr, hurriyet.com.tr, cnnturk.com, ntv.com.tr, fanatik.com.tr ve cumhuriyet.com.tr bunlardan bazıları. Milliyet 58.269 kayıtla örneklemin en çok temsil edilen sitesi, Hürriyet 41.864 kayıtla beşincisi. Bu sitelerin niyetini bilmiyoruz; bilinçli bir tercih de olabilir. Ancak OpenAI'nin kendi dokümanı, GPTBot'u engellemenin içeriğin temel modellerin eğitiminde kullanılmaması isteği anlamına geldiğini söylüyor. Aynı içerik, birçok modelin ham kaynağı olan Common Crawl'a açık kaldığında bu istek yalnız tek bir tarayıcıya uygulanmış oluyor.
Küresel tablo farklı. Longpre ve arkadaşlarının 2024 çalışması, robots.txt kısıtlamaları nedeniyle C4 veri setindeki token'ların %5'inden fazlasının, en aktif ve kritik kaynakların ise %28'inden fazlasının tamamen kısıtlandığını buldu. Örneklemler karşılaştırılabilir değil, ama yön belli: Türkiye'nin en çok ziyaret edilen siteleri eğitim botlarına büyük ölçüde açık. Eğitim botlarının siteye ne getirip ne götürdüğünü AI crawler ekonomisi ve crawl-to-refer oranı yazısında, ücretli erişim seçeneğini ise pay-per-crawl ve Türk siteleri yazısında tartıştık.
Bu ölçüm neyi söylemiyor?
Bu ölçüm, Türkçenin LLM'lerin en yaygın ham kaynağındaki payını ve büyük Türk sitelerinin bu kaynaktaki temsilini gösteriyor. Belirli bir güncel modelin eğitim verisindeki Türkçe payını ve şirketlerin kendi tarayıcılarıyla topladığı veriyi göstermiyor; bu ikisi Eylül 2026 itibarıyla yayımlanmış değil. Eğitim verisindeki payın cevap kalitesine etkisini de ölçmedik.
Sınırları tek tek sıralamak, rakamların doğru okunması için gerekli:
- Common Crawl, bir modelin eğitim karışımı değildir. Şirketler arşivi dil, kalite, tekrar ve güvenlik filtrelerinden geçirir, başka kaynaklarla karıştırır ve farklı ağırlıklarla örnekler. %1,28, bir modelin gördüğü Türkçe payının ne üst ne de alt sınırıdır.
- Dil tespiti Common Crawl'ın kendi CLD2 sonucudur. Kısa, karışık dilli ya da içeriği JavaScript ile yüklenen sayfalarda hata payı vardır; yalnız HTML sayfalar dil tespitine girer.
- Tek tarama ölçüldü. Bir sitenin kayıt sayısı taramadan taramaya değişir; Eylül 2026 rakamları bir zaman kesitidir.
- Örneklem büyük siteleri temsil eder. CrUX listesinden gelen 425 site Türkiye'de en çok ziyaret edilen sitelerdir; KOBİ siteleri ve uzun kuyruk bu örneklemde yok.
- robots.txt dışındaki engeller ölçülmedi. CDN'lerin bot engelleme ayarları ya da güvenlik duvarı kuralları CCBot'u robots.txt'e dokunmadan durdurabilir.
- Tam engel tanımı basittir. Yalnız kök dizini kapatan kuralı aradık; iç sayfaların da kapalı olmasını isteyen, joker karakterleri değerlendiren daha katı bir tanım ve ayrı zamanda yapılan istekler, CCBot ve GPTBot sayılarını bir-iki site değiştirebilir.
- Taramalardaki ay adları yaklaşıktır. Kesin tarih aralığı yalnız CC-MAIN-2026-39 için Common Crawl'ın indeks listesinden doğrulandı; diğer taramalar kimlikleriyle anıldı.
Kendi ölçümümüze ait her rakam, Eylül 2026'da kaydettiğimiz ham indeks ve robots.txt verisinden yeniden hesaplanabiliyor.
Eğitim verisinde az yer almak Türkçe AI cevaplarını nasıl etkiler?
Eğitim verisinde az Türkçe bulunması, modelin Türkçe marka, kurum ve kavramları web araması yapmadan bilme olasılığını düşürür. Bu durumda Türkçe cevaplarda, cevap anında getirilen kaynaklar ve İngilizce içerik daha belirleyici hâle gelir. Bu bir mekanizma açıklamasıdır; etkinin büyüklüğünü bu yazıda ölçmedik.
Bir dil modeli bir soruya iki katmandan cevap verir. Birincisi, eğitim sırasında öğrendiği bilgidir; "parametrik bellek" diye de anılır ve Common Crawl gibi kaynaklardan beslenir. İkincisi, cevap anında web araması ya da başka bir erişim yoluyla getirdiği kaynaklardır. Eğitim verisindeki Türkçe payı birinci katmanı, yani modelin Türkçe bir markayı, yerel bir kurumu ya da Türkçeye özgü bir kavramı ezberden tanıyıp tanımayacağını etkiler.
Birinci katman zayıf olduğunda modelin ikinci katmana daha çok yaslanması beklenir. Cevap anındaki kaynak seçimi ise kendi kurallarıyla işler; hangi sayfanın kaynak olarak gösterildiğini AI asistanlarında kaynak olarak gösterilme yazısında, platformlar arasındaki farkları çok platformlu AI atıf karşılaştırmasında inceledik. Eğitim verisi ile atıf farklı şeylerdir: bir sayfa eğitim verisinde yer alıp hiç kaynak gösterilmeyebilir, eğitim verisinde hiç yer almayan yeni bir sayfa ise cevap anında atıf alabilir.
Bu ayrım, "Türkçe cevaplar neden zayıf?" sorusuna tek bir cevap verilemeyeceğini gösteriyor. Eğitim tarafında Türkçe, ham kaynakta %1,28 ile sınırlı bir havuzdan geliyor ve filtrelerde daha da küçülüyor. Arama tarafında ise model, Türkçe kaynak bulamadığında İngilizce kaynaklara yönelebiliyor. İki katman birlikte çalışıyor; hangisinin ne kadar etkili olduğunu bu çalışma ölçmüyor.
Kendi modelini eğitmeyi ya da uyarlamayı düşünen kurumlar için de tablo aynı. Türkçe için açık veri var (FineWeb-2'de 41,9 milyar kelime), ama İngilizceye göre çok daha küçük bir havuzdan çalışılıyor. Bu kararın mimari tarafını RAG ile fine-tune karşılaştırması yazısında tartıştık. GEO kavramlarına İngilizce bir başvuru kaynağı olarak The GEO Authority sitesini inceleyebilirsiniz; temel tanım için GEO nedir sayfamız iyi bir başlangıç noktası.
Bir Türk sitesi eğitim verisindeki yerini nasıl yönetir?
Karar iki eksenlidir. İçeriğinizin modellerin bilgisine girmesini istiyorsanız CCBot'a ve diğer eğitim botlarına robots.txt'de izin verir, önemli sayfaları sade HTML'de erişilebilir tutarsınız. İstemiyorsanız CCBot'u ve GPTBot'u ayrı ayrı, adlarıyla engellersiniz. Eğitim botunu engellemek, cevap anındaki arama botlarını durdurmaz.
Ölçümümüzden çıkan uygulama adımları şunlar:
- robots.txt'inizde CCBot'un durumunu kontrol edin. Sheltron'un ücretsiz robots.txt AI bot kontrolü aracı, CCBot dahil AI botlarına hangi kuralın uygulandığını gösterir. Örneklemimizdeki sitelerin %91,4'ünün robots.txt'inde CCBot adı hiç geçmiyor; bu durumda
User-agent: *grubu uygulanır. - Common Crawl indeksinde sitenizi sorgulayın. Tek bir alan adı için CDX sunucusu yeterlidir:
https://index.commoncrawl.org/CC-MAIN-2026-39-index?url=alanadiniz.com&matchType=domain&output=json. Sunucu yoğunlukta 502/504 hatası dönebiliyor; ölçümümüzde 116 alan adından sonra bu hatalar sıklaştığı için sayımı indeks dosyalarından yaptık. - Engelleme kararını bot bot yazın. Common Crawl'ın CCBot sayfası engelleme için
User-agent: CCBotveDisallow: /satırlarını veriyor ve CCBot kılığındaki sahte tarayıcılara karşı ters DNS doğrulaması öneriyor (*.crawl.commoncrawl.org). GPTBot'u engelleyip CCBot'u açık bırakmak, 14 büyük Türk sitesinde gördüğümüz gibi eğitim verisi kararını tek bir tarayıcıya indirger. - Alt alan adlarını unutmayın. robots.txt host bazında çalışır. amazon.com.tr örneğinde olduğu gibi, ana alan adındaki engel alt alan adlarını kapsamaz; her alt alan adının kendi dosyası gerekir.
- Önemli sayfaları JavaScript'e bağımlı olmayan HTML'de tutun. Common Crawl dil tespitini yalnız HTML sayfalarda yapar; içeriği sonradan yüklenen sayfalar yanlış etiketlenebilir. AI'ya yönelik erişim katmanını llms.txt dosyası ve schema markup ile llms.txt altyapısı yazılarında anlattık.
- Arama tarafını ayrı ölçün. Eğitim verisinde yer almak, AI cevaplarında görünmek demek değildir. Markanızın AI cevaplarındaki durumunu Sheltron'un ücretsiz AI görünürlük spot check aracıyla hızlıca, düzenli takibi Sheltron AiSEO ile yapabilirsiniz.
Ekibiniz bu kavramları sistematik biçimde öğrenmek isterse GEO Akademi Türkçe eğitim içerikleri sunuyor.
Common Crawl'da kaç sayfanızın bulunduğu ile ChatGPT ya da Gemini cevaplarında nasıl göründüğünüz aynı soru değil; ikisini yan yana görmeden hangi botu açıp hangisini kapatacağınıza karar vermek zor. Hızlı değerlendirme sayfasından başvurun, sitenizin robots.txt kararlarını ve AI cevaplarındaki görünümünü birlikte okuyalım.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- LLM Eğitim Verisinde Türkçe Oranı: Common Crawl'da %1,28 ve 425 Türk Sitesinin Eylül 2026 Ölçümü
- TL;DR
- Common Crawl'ın Eylül 2026 taramasında sayfaların %1,28'i (27,7 milyon) Türkçe; İngilizce bunun 32,8 katı. Dil dağılımını yayımlayan modellerde pay çok daha düşük: GPT-3'te %0,059, Llama 2'de %0,005'in altında. Türkiye'nin en çok ziyaret edilen 425 sitesinin medyanı 598 kayıt, %34,8'i 100'den az kayıtla temsil ediliyor; geçerli robots.txt'i olan 350 siteden yalnız 15'i CCBot'u engelliyor.
- Ana Çıkarımlar (6)
- Common Crawl'ın Eylül 2026 taramasında (CC-MAIN-2026-39) birincil dili Türkçe olan sayfaların payı %1,28 (27,7 milyon sayfa); Türkçe diller arasında 12. sırada ve İngilizce 32,8 kat fazla.
- Türkçenin Common Crawl'daki yıllık ortalama payı 2023'te %0,84 iken 2026'da %1,27; ancak tarama başına Türkçe sayfa sayısı yıllardır 20-36 milyon aralığında.
- Dil dağılımını yayımlamış modellerde Türkçe çok daha az: GPT-3'te kelimelerin %0,059'u, Llama 2'de %0,005 listelenme eşiğinin altında; güncel modellerin dağılımı bilinmiyor.
- Türkiye'nin en çok ziyaret edilen 425 sitesinin Eylül 2026 taramasındaki medyan kaydı 598; %34,8'i 100'den az kayıtla temsil ediliyor, kayıtların %64,2'si en büyük 43 sitede.
- Geçerli robots.txt'i olan 350 siteden yalnız 15'i (%4,3) CCBot'u engelliyor; GPTBot'u engelleyen 24 sitenin 14'ü CCBot'u açık bırakıyor.
- sheltron.com.tr CCBot'a açık olmasına rağmen canlıdaki 234 blog yazısından yalnız 40'ı (%17,1) Eylül 2026 taramasında yakalandı: izin vermek taranmayı garanti etmiyor.
- Kaynaklı Veriler
- %1,28 — Common Crawl'ın Eylül 2026 taramasında (CC-MAIN-2026-39) birincil dili Türkçe olan HTML sayfaların payı (27,7 milyon sayfa) (Common Crawl — Crawl Statistics: Distribution of Languages, 2026)
- 32,8 kat — aynı taramada İngilizce sayfa payının (%41,86) Türkçeye oranı (Common Crawl — languages.csv, 2026)
- 2,17 milyar sayfa — CC-MAIN-2026-39'un büyüklüğü (4-17 Eylül 2026, 361,4 TiB) (Common Crawl — September 2026 Crawl Archive Now Available, 2026)
- %64 — 2019-Ekim 2023 arasında yayımlanan 47 metin üretim modelinden en az 30'unun ön eğitimde Common Crawl'ın filtrelenmiş bir sürümünü kullanma oranı (Mozilla Foundation — Training Data for the Price of a Sandwich, 2024)
- %60 — GPT-3 eğitim karışımında filtrelenmiş Common Crawl'ın ağırlığı (410 milyar token) (Brown ve ark., Language Models are Few-Shot Learners (arXiv:2005.14165), 2020)
- %0,059 — GPT-3 eğitim verisinde Türkçe kelime payı (118 dil içinde 20. sıra) (OpenAI — GPT-3 dataset statistics, 2020)
- %0,005 — Llama 2 ön eğitim verisinde listelenme eşiği; İngilizce dışında bu eşiği aşan 26 dil arasında Türkçe yok (Touvron ve ark., Llama 2 (arXiv:2307.09288), 2023)
- %1,93 — mT5'in eğitim örneklemesinde Türkçenin ağırlığı; mC4'te Türkçe 71 milyar token (Xue ve ark., mT5 (arXiv:2010.11934), 2020)
- 41,9 milyar kelime — FineWeb-2 veri setinin Türkçe alt kümesi (95,1 milyon belge) (Hugging Face — FineWeb-2, 2025)
- %1,6 — içerik dili bilinen web sitelerinde Türkçenin payı (11. sıra) (W3Techs — Usage statistics of content languages for websites (Eylül 2026), 2026)
- %34,8 — Türkiye'nin en çok ziyaret edilen 425 sitesinden Eylül 2026 taramasında 100'den az kayıtla temsil edilenlerin payı (medyan 598 kayıt) (Sheltron ölçümü, Common Crawl CC-MAIN-2026-39 indeksi (Eylül 2026), 2026)
- %4,3 — geçerli robots.txt'i olan 350 büyük Türk sitesinden CCBot'u tamamen engelleyenlerin payı (15 site) (Sheltron ölçümü, 425 sitenin robots.txt dosyası (Eylül 2026), 2026)
- %5 — robots.txt kısıtlamaları nedeniyle tamamen kısıtlanan C4 token'larının alt sınırı (kritik kaynaklarda %28+) (Longpre ve ark., Consent in Crisis (arXiv:2407.14933), 2024)
- Arama Niyetleri
- llm eğitim verisinde türkçe oranı
- common crawl türkçe
- ccbot engelleme türk siteleri
- türkçe web içeriği yüzde kaç
- yapay zeka türkçe veri azlığı
- common crawl nedir
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz