
Şemada Var, Sayfada Yok: JSON-LD ile Görünür İçerik Uyuşmazlığı AI Atfını Nasıl Engeller?
JSON-LD'de işaretlenen metin sunucudan gelen HTML'de yoksa AI yüzeyleri alıntılayacak pasaj bulamaz. Sheltron'un kendi SSS sayfasındaki iki kök neden, düzeltme kodu, ölçüm sonuçları ve şema-DOM eşleşme testi.
💡Kısa Özet
Sheltron'un SSS cevapları FAQPage JSON-LD'sinde vardı ama sunucu HTML'inde yoktu: Radix akordeonu kapalı paneli DOM'a eklemiyordu, kategori sekmesi de 41 sorunun 36'sını HTML dışında bırakıyordu. Düzeltmeden sonra AI Overview kaynaklığı 0/10'dan (23 Temmuz 2026) 6/16'ya (9 Ağustos 2026) çıktı; sorgu setleri farklı olduğu için bu bir kanıt değil, yön işareti. Eylül 2026 testinde 41 sorunun 41'i görünür HTML'de.
Ana Çıkarımlar
- •Sheltron'un /sss/ sayfasında JSON-LD'de 41 soru vardı, sunucu HTML'inde ise 5; kategori sekmesi 41 sorunun 36'sını HTML dışında bırakıyordu.
- •Radix akordeonuna forceMount eklenip kapalı durum CSS ile daraltılınca cevaplar panel kapalıyken de sunucu HTML'inde yer aldı.
- •AI Overview kaynaklığı 23 Temmuz 2026'da 0/10, 9 Ağustos 2026'da 6/16 oldu; sorgu setleri farklı ve aynı dönemde 17 madde canlıya alındığı için artış tek başına düzeltmeye bağlanamaz.
- •Vercel ve MERJ'in 2024 ölçümlerine göre OpenAI, Anthropic ve Perplexity tarayıcıları JavaScript çalıştırmıyordu (OpenAI botlarının 25 Eylül 2026'dan itibaren bazı sitelerde render ettiğine dair tek, doğrulanmamış bir rapor var); Googlebot ise incelenen HTML sayfalarının %100'ünü render ediyor ama tıklama gerektiren içeriği yüklemiyor.
- •HtmlRAG çalışmasına göre ham web sayfası token'larının %90'ından fazlası CSS, JavaScript ve yorumdur; JSON-LD de bir script bloğu olduğu için bu tür hatlarda atılabilir.
- •Next.js sayfalarında basit grep aynı cevap cümlesini 4 kez sayabiliyor; doğru test script blokları atıldıktan sonra yapılır ve Eylül 2026'da /sss/ için 41/41 sonuç verdi.
- •Google'a göre yapılandırılmış veri üretken AI araması için gerekli değil; şema, görünür metni doğru tarif ettiği ölçüde işe yarar.
JSON-LD ile görünür içerik eşleşmesi, şemada işaretlenen her sorunun ve cevabın sunucudan gelen HTML'de okunabilir metin olarak da bulunması demektir. Bu eşleşme yoksa şema tek başına atıf getirmez. Sheltron'un SSS cevapları FAQPage JSON-LD'sinde duruyordu ama sunucu HTML'inde yoktu. 23 Temmuz 2026'da izlediğimiz 10 marka-dışı sorgunun 10'unda AI Overview çıkıyordu ve hiçbirinde kaynak değildik. Vercel ile MERJ'in Aralık 2024 ölçümüne göre büyük AI tarayıcılarının hiçbiri JavaScript çalıştırmıyordu. Tıklanınca oluşan bir metin bu okurlar için hiç yazılmamış sayılır.
Kök neden iki arayüz kalıbıydı ve ikisi de 23-26 Temmuz arasında düzeltildi. 9 Ağustos 2026'daki takip ölçümünde AI Overview çıkan 16 sorgunun 6'sında kaynak olarak listelendik. İki ölçümün sorgu seti farklı ve aynı dönemde başka düzeltmeler de canlıya alındı. Bu yüzden artışı yalnız bu düzeltmeye bağlamıyoruz. Aşağıda sorunun nasıl ortaya çıktığını, hangi bileşenlerin şemayı sayfadan kopardığını ve eşleşmenin birkaç komutla nasıl test edileceğini adım adım anlatıyoruz.
JSON-LD ile görünür içerik uyuşmazlığı nedir, AI atfını neden etkiler?
Uyuşmazlık, JSON-LD'de işaretlenen metnin sunucudan gelen HTML'in görünür kısmında bulunmamasıdır. Google yapılandırılmış verinin görünür metinle eşleşmesini istiyor ve üretken AI araması için şemayı gerekli saymıyor. AI yüzeyleri görünür pasajlardan alıntı yapar. Metin yalnız şemada duruyorsa alıntılanacak bir pasaj da yoktur.
Kural yeni değil; Google'ın genel yapılandırılmış veri yönergelerinde açıkça yazıyor. Yönergedeki örneğe göre JSON-LD bir sanatçıyı tanımlıyorsa, sayfa gövdesi de aynı sanatçıyı anlatmalıdır. Yapılandırılmış veri, sayfa içeriğinin "doğru bir temsili" olmak zorundadır. Aynı doküman, rich result gösterilmemesinin nedenleri arasında şemanın işaret ettiği içeriğin kullanıcıdan gizlenmesini de sayıyor.
Google'ın yapılandırılmış veri kuralı tek cümleye sığar: okuyucuya görünmeyen içerik işaretlenmez.
Bu hatanın uzun süre fark edilmemesinin bir nedeni var. Google yönergesine göre yapılandırılmış veri nedeniyle verilen manuel işlemin sonucu rich result uygunluğunun kaybıdır; sayfanın sıralaması etkilenmez. Klasik SEO gözüyle bakıldığında uyuşmazlık küçük bir biçim sorunu gibi görünür. Şema doğrulayıcıları da yalnız JSON'un sözdizimini kontrol eder. Şema doğrulama hatalarını ele aldığımız rehberdeki hatalar sözdizimi odaklıdır; uyuşmazlık ise bir sözdizimi hatası değildir. Sözdizimi kusursuz olabilir, metin yine de sayfada bulunmayabilir.
AI yüzeylerinde ise ağırlık görünür metne kayıyor. Google'ın AI özellikleri dokümanı AI Overviews ve AI Mode için ek bir gereksinim olmadığını söylüyor. En iyi uygulamalar listesinde ise iki madde öne çıkıyor: önemli içeriğin metin olarak erişilebilir olması ve yapılandırılmış verinin sayfadaki görünür metinle eşleşmesi. Mayıs 2026'da yayımlanan üretken AI araması rehberi daha da net: yapılandırılmış veri üretken AI araması için gerekli değildir ve bunun için eklenmesi gereken özel bir schema.org işaretlemesi yoktur.
Buradan çıkan sonuç şu: AI yüzeyi bir cevabı alıntılarken sayfadaki bir pasajı seçer. LLM'lerin sayfanın hangi bölümünden alıntı yaptığını incelediğimiz yazıda gösterdiğimiz gibi alıntı birimi pasajdır. Şema, bu pasajın ne olduğunu anlatan bir etiket işlevi görür, pasajın yerini tutmaz. Nitekim 225 yazılık doğal deney raporumuzda FAQ şeması ile görünürlük arasındaki korelasyon sıfıra yakın çıktı (ρ = −0,061, FAQ sayısı ↔ gösterim). Raporun olası açıklaması, cevapların JSON-LD'de bulunup DOM'da bulunmamasıydı.
Sheltron'da ne oldu: şemada 41 soru, HTML'de 5
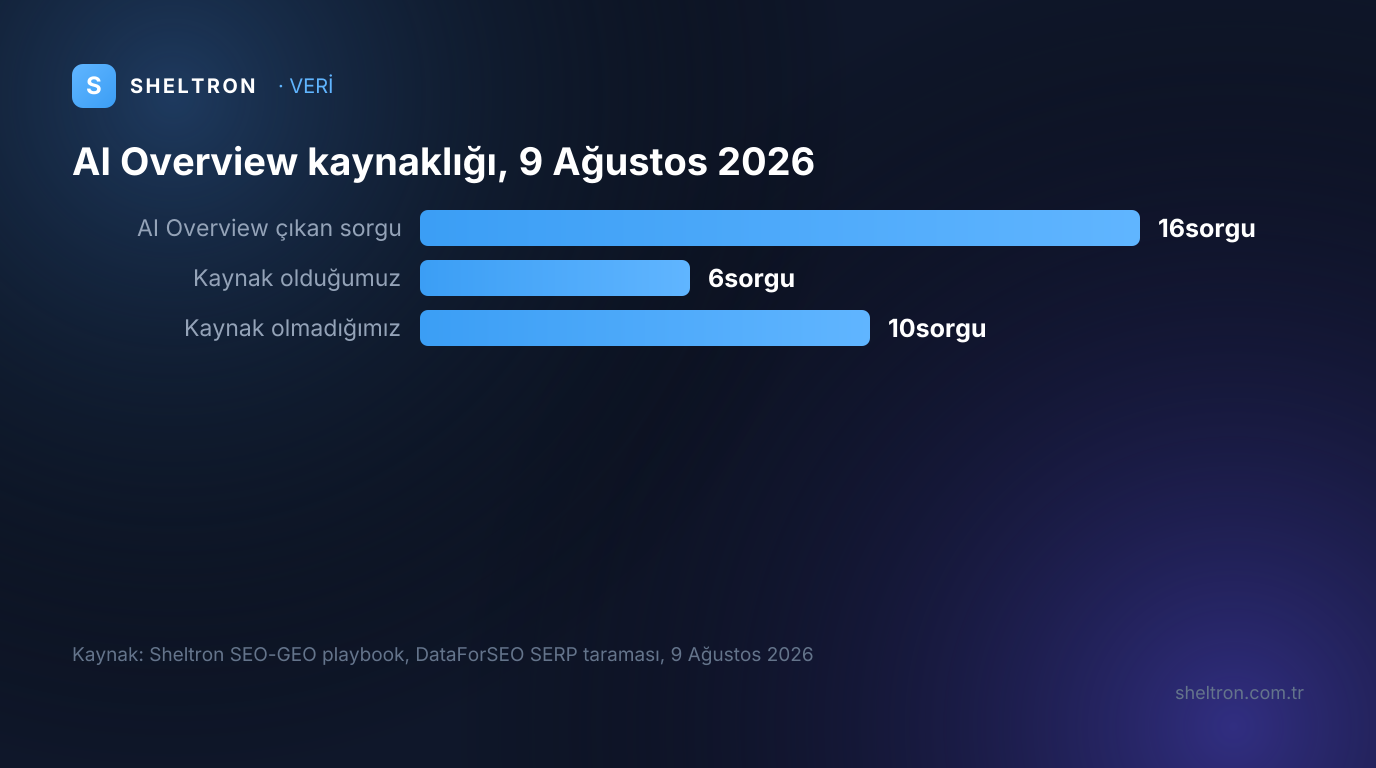
İki arayüz kalıbı cevapları sunucu HTML'inden siliyordu. Radix akordeonu kapalı paneli DOM'a hiç eklemiyordu. /sss/ sayfasındaki kategori sekmesi de yalnız aktif kategoriyi render ederek 41 sorunun 36'sını HTML dışında bırakıyordu. Sonuçta şemada 41 soru vardı, görünür HTML'de ise yalnız 5 soru.
Sorunu 23 Temmuz 2026'daki ölçüm denetiminde bulduk. Hedeflediğimiz 10 marka-dışı sorgunun 10'unda AI Overview vardı, hiçbirinde kaynak değildik. Kök neden analizi bizi SSS bileşenine götürdü. Cevaplar FAQPage JSON-LD'sinde eksiksizdi, ama sayfa sunucudan geldiğinde akordeonlar kapalıydı ve kapalı panelin içeriği HTML'e hiç yazılmıyordu. Cevap, ancak kullanıcı tıkladığında tarayıcıda oluşuyordu.
İlk düzeltme 23 Temmuz'da tek bir bileşende yapıldı. Radix'in Accordion.Content bileşenine forceMount eklendi ve kapalı durum CSS ile daraltıldı:
   <AccordionPrimitive.Content
     ref={ref}
-    className="overflow-hidden text-sm transition-all data-[state=closed]:animate-accordion-up data-[state=open]:animate-accordion-down"
+    forceMount
+    className="overflow-hidden text-sm transition-all data-[state=closed]:hidden data-[state=open]:animate-accordion-down"
     {...props}
   >
Bu değişiklikle cevap metni, panel kapalıyken de sunucu HTML'inde yer alıyor. Kullanıcı yine kapalı bir akordeon görüyor, fakat metin sayfanın kaynağında duruyor. Değişiklik ortak bileşende yapıldığı için blog yazılarının sonundaki SSS akordeonları da aynı düzeltmeden yararlandı.
İkinci sorun daha az göze çarpıyordu. /sss/ sayfasında soruları kategorilere ayıran bir sekme filtresi vardı ve bileşen yalnız seçili kategoriyi render ediyordu. Varsayılan kategori 5 soru içeriyordu, geri kalan 36 soru HTML'e hiç girmiyordu. 26 Temmuz'daki düzeltmeyle tüm kategoriler render edildi, kategori düğmeleri de sayfa içi çapa bağlantısına dönüştürüldü. Böylece SSS sayfamızdaki 41 sorunun 41'i sunucu HTML'ine girdi.
| Tarih (2026) | Olay | Durum |
|---|---|---|
| 23 Temmuz | Ölçüm denetimi: 10 marka-dışı sorgunun 10'unda AI Overview, 0'ında kaynak | Kök neden: cevaplar JSON-LD'de var, DOM'da yok |
| 23 Temmuz | Akordeona forceMount ve CSS ile daraltma |
Kapalı cevaplar sunucu HTML'inde |
| 26 Temmuz | /sss/ kategori filtresi kaldırıldı, tüm kategoriler render ediliyor | Görünür soru sayısı 5'ten 41'e |
| 9 Ağustos | En çok gösterim alan 20 marka-dışı sorguda SERP taraması | 16 sorguda AI Overview, 6'sında kaynağız |
| Eylül | Canlı sayfada şema-DOM testi | 41 sorunun 41'i görünür HTML'de |
9 Ağustos ölçümünde DataForSEO SERP API ile Search Console'daki en çok gösterim alan 20 marka-dışı sorgu tarandı. 16'sında AI Overview çıktı; bunların 6'sında kaynaktık, 10'unda değildik. Kaynak olduğumuz sorgular şunlardı: "geo nedir", "yapay zeka seo", "geo danışmanlığı", "aiseo", "yapay zeka ile seo" ve "geo seo". AI Overview kaynak listelerinde en sık geçen alan adı da 6 geçişle sheltron.com.tr oldu.
Sheltron'da SSS cevapları sunucu HTML'ine alındıktan sonra AI Overview kaynaklığı 23 Temmuz'daki 0/10'dan 9 Ağustos 2026'da 6/16'ya çıktı; iki ölçümün sorgu seti farklıdır.
Bu sonucu dikkatli okumak gerekiyor. Birincisi, iki ölçüm aynı sorgu setiyle yapılmadı: ilki 10 sorguluk bir denetim listesiydi, ikincisi Search Console'un ilk 20 marka-dışı sorgusu. İkincisi, 23 Temmuz denetiminin ardından üç deploy çevriminde toplam 17 madde canlıya alındı. Bunların arasında www'den www'siz alan adına 301 yönlendirme, breadcrumb düzeltmesi, CDN önbellek süresinin kısaltılması ve yeni bir niyet sayfası da vardı. 8 Ağustos'ta şema tekrarları temizlendi ve llms.txt dosyası güncellendi. Bu nedenle 0/10'dan 6/16'ya geçişi düzeltmenin yönünü gösteren bir işaret olarak okuyoruz, tek başına etkisinin kanıtı olarak değil.
Google render ediyor, AI tarayıcıları çoğunlukla etmiyor: aynı sayfa iki okura nasıl görünür?
Vercel ve MERJ'in 2024 ölçümlerine göre Googlebot HTML sayfalarının tamamını render ediyor, ancak tıklama gerektiren içeriği yüklemiyor. GPTBot, ClaudeBot ve PerplexityBot ise aynı ölçümlerde JavaScript'i hiç çalıştırmıyordu. Kapalıyken DOM'dan çıkan bir cevap ikisi için de görünmez. JavaScript ile sonradan eklenen metin ise yalnız AI tarayıcıları için kaybolur.
Google'ın JavaScript'i nasıl işlediği ölçülmüş bir konu. Vercel ve MERJ'in Googlebot'un JavaScript işleyişini inceleyen çalışmasında 37.000'den fazla HTML sayfanın %100'ü tam olarak render edildi. Medyan render gecikmesi 10 saniye, p90 gecikmesi ise yaklaşık 3 saat. Bu, Google'ın JavaScript ile oluşan içeriği er geç göreceği anlamına gelir. Görmeyeceği şey, etkileşim gerektiren içeriktir. Google'ın mobil öncelikli dizine ekleme rehberine göre Google, kaydırma, tıklama ya da yazma gibi kullanıcı etkileşimi gerektiren içeriği yüklemez. Radix'in varsayılan akordeonu tam da buraya düşer: render sonrası DOM'da da kapalı panelin içeriği yoktur, çünkü kimse panele tıklamamıştır.
AI tarayıcıları için tablo daha sert. Vercel ve MERJ'in Aralık 2024 tarihli AI tarayıcıları ölçümüne göre OpenAI, Anthropic, Meta, ByteDance ve Perplexity tarayıcılarının hiçbiri JavaScript çalıştırmıyordu. JavaScript dosyalarını indiriyor ama çalıştırmıyorlardı: ChatGPT isteklerinin %11,50'si, Claude isteklerinin %23,84'ü JavaScript dosyasıydı. Hacim de marjinal değil. Aynı ölçümde GPTBot Vercel ağında bir ayda 569 milyon, Claude 370 milyon istek yaptı. Aynı ölçüme göre istisnalar da var: Gemini, Googlebot'un altyapısını kullanıyor ve AppleBot tarayıcı tabanlı olarak render ediyor. Bu tarayıcıların sitenize ne sıklıkla geldiğini AI crawler ekonomisi yazımızda Türkiye verisiyle ele almıştık.
Bu tabloya Eylül 2026 sonunda ilk itiraz geldi. Next.js tabanlı bir pazar yerinin geliştiricisi, 30 Eylül 2026'da yayımladığı log analizinde OAI-SearchBot ve GPTBot'un 25 Eylül 2026'dan itibaren sayfalarını render etmeye başladığını raporladı. Ancak bu tek bir sitenin gözlemi; OpenAI bir duyuru yapmadı ve yazar render'ın yalnız bazı sitelerde açık göründüğünü belirtiyor. 5 Ekim 2026 itibarıyla bağımsız bir doğrulama bulamadık. Render eden bir tarayıcı da kapalı akordeona tıklamaz; DOM'dan çıkan cevap için sonuç değişmez.
Vercel ve MERJ'in 2024 ölçümüne göre büyük AI tarayıcılarının hiçbiri JavaScript çalıştırmıyordu; kapalıyken DOM'dan çıkan bir cevap bu tarayıcılar için hiç yazılmamış sayılır.
Üçüncü bir okur daha var: getirilen sayfayı dil modeline vermeden önce temizleyen RAG hatları. ACM Web Conference 2025'te yayımlanan HtmlRAG çalışmasına göre gerçek bir web belgesi ortalama 80 bin token'ın üzerinde ve bu token'ların %90'ından fazlası CSS, JavaScript, yorum gibi anlam taşımayan içerik. Kural tabanlı temizlik bu katmanı atarak HTML'i özgün boyutunun %6'sına indiriyor. JSON-LD de bir <script> bloğunun içinde yaşar. Bu tür bir hatta ilk atılan katmanlardan biri olması muhtemeldir; görünür metin ise kalır. Burada bir çekince gerekiyor: OpenAI, Anthropic ya da Perplexity'nin JSON-LD'yi nasıl işlediğine dair resmi bir açıklama yok. HtmlRAG ticari sistemlerin birebir tarifi değil, mekanizmayı gösteren akademik bir örnektir.
HtmlRAG çalışmasına göre ham bir web sayfasındaki token'ların %90'ından fazlası CSS, JavaScript ve yorumdur; RAG hatları bu katmanı ilk adımda atabilir.
| Okur | JavaScript çalıştırır mı? | CSS ile daraltılmış metni görür mü? | Kapalıyken DOM'dan çıkan metni görür mü? | JavaScript ile eklenen JSON-LD'yi görür mü? |
|---|---|---|---|---|
| Googlebot | Evet, render ediyor | Evet | Hayır, etkileşim kurmuyor | Evet |
| AI tarayıcıları (GPTBot, ClaudeBot, PerplexityBot) | 2024 ölçümünde hayır; OpenAI botları için Eylül 2026'da doğrulanmamış tek render raporu var | Evet, metin HTML'de | Hayır | Hayır |
| Akademik RAG ön işleme hattı (HtmlRAG) | Uygulanmaz, HTML temizlenir | Evet, CSS atılır, metin kalır | Hayır | Hayır, script blokları atılır |
Kritik fark son sütunda. Google için JavaScript ile eklenen JSON-LD çalışır; Google'ın kendi dokümanı da şemanın JavaScript ile enjekte edilebileceğini gösteriyor. Aynı dokümana göre sunucu tarafı render kullanılıyorsa şema render edilmiş çıktıya da eklenebilir. JavaScript çalıştırmayan bir tarayıcı içinse istemcide eklenen şema ve istemcide oluşan metin yoktur. Google'ın JavaScript SEO temelleri sayfası da bunu kabul ediyor: sunucu tarafı render hâlâ iyi bir fikir, çünkü her bot JavaScript çalıştıramaz.
Hangi arayüz kalıpları şemayı sayfadan koparır?
Riskli olan içeriği gizlemek değil, DOM'dan çıkarmaktır. Kapalı paneli unmount eden akordeonlar, yalnız aktif sekmeyi render eden filtreler, tıklayınca içerik çeken "devamını oku" düğmeleri ve kapalıyken bileşeni kaldıran animasyonlar metni sunucu HTML'inden siler. Şema ise sunucuda üretildiği için yerinde kalır.
Bu kalıpların ortak noktası, iyi bir kullanıcı deneyimi hedefiyle kurulmuş olmaları. Uzun bir SSS listesini kapalı akordeonlarla sunmak, sekmelerle kategorilere ayırmak ya da uzun bir cevabı "devamını oku" ile kısaltmak mantıklı tasarım kararlarıdır. Sorun, bu kararların uygulanış biçiminde ortaya çıkıyor. Bileşen kütüphaneleri ve durum yönetimi, görünmeyen içeriği çoğu zaman hiç render etmemeyi tercih ediyor.
| Kalıp | Sunucu HTML'inde metin var mı? | Tipik neden | Düzeltme |
|---|---|---|---|
| Kapalı paneli unmount eden akordeon | Yok | Radix gibi kütüphanelerde kapalı içeriğin mount edilmemesi | forceMount ile CSS daraltma, <details> ya da hidden="until-found" |
| Yalnız aktif sekmeyi render eden sekme veya filtre | Yalnız aktif sekmede | Koşullu render (filter ile tek kategori) |
Tüm sekmeleri render et, geçişi CSS ya da çapa bağlantısıyla yönet |
| Tıklayınca içerik çeken "devamını oku" | Yok | İstemci tarafında sonradan veri çekme | Tam metni sunucuda ver, CSS ile kısalt |
| Kapalıyken bileşeni kaldıran animasyon | Yok | Çıkış animasyonundan sonra unmount (AnimatePresence) |
Görünürlüğü CSS ile yönet, bileşeni DOM'da tut |
| Kaydırınca ya da tıklayınca yüklenen ana içerik | Yok | Etkileşime bağlı tembel yükleme | Ana metni ilk HTML'de ver |
| İstemcide eklenen JSON-LD | Metin olabilir, şema yok | Şemanın tarayıcıda script ile enjekte edilmesi | JSON-LD'yi sunucuda üret |
Risk yalnız SSS ile sınırlı değil. İç denetimimizde aynı riski taşıyan yüzeyleri şöyle sıraladık: TL;DR blokları, "ana çıkarımlar" kutuları, tablolar ve karşılaştırma listeleri. Bunlar tam da alıntılanması istenen özet yapılarıdır; bir animasyon kütüphanesiyle kapalıyken DOM'dan tamamen çıkarılırlarsa alıntılanamazlar.
AI Overview kaynak gösterme rehberimizde akordeona gömülü metnin değerlendirme dışında kalabileceği konusunda uyarmıştık. Bu yazıdaki teknik ayrım o uyarıyı inceltiyor: sorun akordeonun kendisi değil, kapalıyken içeriği DOM'dan çıkaran akordeondur. Metin HTML'de duruyorsa akordeon kullanmaya devam edebilirsiniz.
Kaydırma veya tıklamaya bağlı yükleme için Google'ın tembel yükleme rehberi açık bir gerekçe veriyor: Google Arama sayfayla etkileşim kurmaz. Birincil içerik bir kullanıcı eylemini bekliyorsa, Google için de, JavaScript çalıştırmayan tarayıcılar için de o içerik yoktur.
CSS ile gizlemek sorun mu? Görsel daraltma ile DOM'dan çıkarma farkı
Hayır, tek başına sorun değildir. Metin HTML'de durup yalnız CSS ile daraltılıyorsa kullanıcı tıklayıp okuyabilir, arama motoru ve AI botları da metni görür. Google, genişletilebilir bir bölüme tıklayarak cevabı görmeyi geçerli bir kullanım sayıyor. Sorun, metnin kapalıyken HTML'de hiç bulunmamasıdır; forceMount, <details> ya da hidden="until-found" bu farkı korur.
Google bu örneği 2021'de FAQ yönergesine açıkça ekledi. Bizim okumamıza göre yapılandırılmış veri yönergesindeki "kullanıcıdan gizlenen içerik" ifadesi, kullanıcının hiçbir şekilde erişemediği içeriği kastediyor; 2021 FAQ örneği de bunu destekliyor. Bu okumaya göre bir tıklamayla açılan bölüm o kapsama girmez. Kısacası iki ayrı durum var:
- Görsel daraltma: Metin HTML'de durur, CSS onu gizler, kullanıcı bir tıklamayla açar. Google için geçerli bir kullanımdır; JavaScript çalıştırmayan tarayıcılar metni ham HTML'de bulur.
- DOM'dan çıkarma: Metin kapalıyken HTML'de yoktur, açıldığında JavaScript ile oluşturulur. Tarayıcıların gördüğü HTML'de alıntılanacak metin bulunmaz.
Metni HTML'de tutmanın üç yaygın yolu var. Birincisi bizim uyguladığımız yol: bileşeni her durumda mount edip kapalı durumu CSS ile gizlemek. Radix bunu forceMount özelliğiyle destekliyor. Kütüphanenin dokümanı bu özelliği animasyon kontrolü için tanımlıyor, ama aynı özellik içeriği DOM'da tutmaya da yarıyor.
İkincisi, HTML'in kendi hidden="until-found" değeri. MDN'ye göre bu durumdaki eleman gizlidir, ama içeriği tarayıcının sayfa içi aramasına ve bağlantı parçasıyla gezinmeye açıktır. Arama eşleştiğinde tarayıcı bir beforematch olayı tetikler, hidden özniteliğini kaldırır ve bölüme kaydırır. MDN'ye göre bu mekanizma, elemanın display değeri none, contents ya da inline olduğunda çalışmıyor. Bu yüzden CSS tarafında bu değerlerden kaçınmak gerekiyor.
Üçüncüsü yerel <details> ve <summary> elemanları. Kapalı durumdaki içerik de HTML'de kalır ve ek bir JavaScript gerektirmez. Basit SSS listeleri için en az bağımlılıklı çözüm budur.
Hangisini seçerseniz seçin, test aynı: sayfayı JavaScript çalıştırmadan indirdiğinizde cevap metni orada mı? Bizim data-[state=closed]:hidden tercihimiz display: none üretir. Bu yüzden kapalı cevaplar web tarayıcısının sayfa içi aramasında (Ctrl+F) bulunmaz. Metin yine de HTML'de durduğu için arama motoru ve AI botları açısından sorun yoktur. Sayfa içi aramanın da çalışmasını istiyorsanız hidden="until-found" daha iyi bir seçenektir.
Şema ile DOM eşleşmesi curl ve grep ile nasıl test edilir?
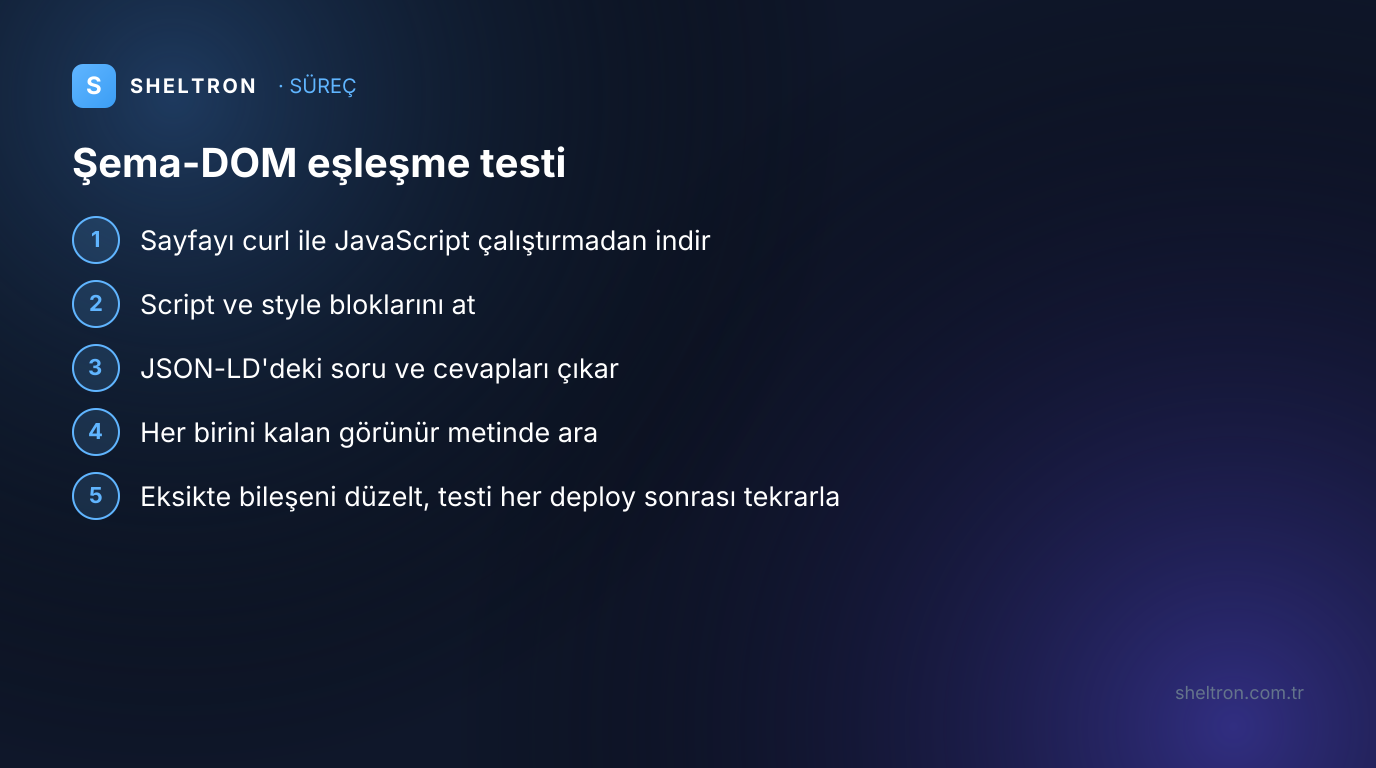
Sayfayı JavaScript çalıştırmadan indirin, script bloklarını atın ve JSON-LD'deki her soruyu ve cevabın ilk cümlesini kalan metinde arayın. Sheltron'un /sss/ sayfasında Eylül 2026'da yaptığımız testte 41 sorunun 41'i geçti. Script'leri atmadan yapılan basit bir grep ise aynı cümleyi 4 kez sayarak yanıltıyordu.
Bu testi kendiniz yapmanız gerekiyor, çünkü Google'ın aracı bu eşleşmeyi hiçbir zaman ölçmedi; Rich Results Test şemanın sözdizimini ve uygunluğunu doğrular, görünür metinle eşleşmesini değil. Search Engine Journal'ın aktardığına göre Google, FAQ rich result'ı 7 Mayıs 2026'da kaldırdı ve Mayıs 2026'da Rich Results Test'teki FAQ desteğinin de Haziran 2026'da kaldırılacağını duyurdu. Sheltron'un ücretsiz Schema Markup Doğrulayıcısı ve İçerik Denetimi aracı sayfayı JavaScript çalıştırmadan okur. Böylece JavaScript çalıştırmayan bir tarayıcının gördüğü HTML'e bakar, şemanın varlığını ve sözdizimini kontrol eder. Şema ile görünür metnin eşleşmesini ise aşağıdaki komutlarla test etmek gerekiyor.
Canlı /sss/ sayfası üzerinde Eylül 2026'da çalıştırdığımız komutlar ve gerçek çıktıları şöyle:
$ curl -s https://sheltron.com.tr/sss/ | grep -o '"@type":"Question"' | wc -l   # 1) JSON-LD'deki soru sayısı
41

$ curl -s https://sheltron.com.tr/sss/ | grep -o 'data-state="closed"[^>]*role="region"' | wc -l   # 2) Kapalı ama HTML'de duran cevap panelleri (role=region)
41

$ curl -s https://sheltron.com.tr/sss/ \
    | grep -o "doğru tanınmasını, tutarlı temsil ed" | wc -l   # 3) YANILTICI sayım: 2× JSON-LD + 1× Next.js RSC yükü + 1× görünür HTML
4

$ curl -s https://sheltron.com.tr/sss/ | perl -0pe 's/<script\b[^>]*>.*?<\/script>//gs' \
    | grep -o "doğru tanınmasını, tutarlı temsil ed" | wc -l   # 4) DOĞRU TEST: script blokları atıldı; 0 çıksaydı şemada var, sayfada yok
1
Üçüncü komut, testin en kolay yanlış yapıldığı yeri gösteriyor. Next.js App Router gibi React Server Components kullanan çatılarda sayfa metni, görünür HTML'in yanında self.__next_f.push(...) script'lerindeki RSC yükünde de bulunur. Bir cümleyi ham HTML'de iki ya da daha fazla kez görmek "hem şemada hem sayfada" demek değildir. Metin yalnız JSON-LD'de ve RSC yükünde olabilir; JavaScript çalıştırmayan tarayıcı yine göremez. Test bu yüzden mutlaka script blokları atıldıktan sonra yapılmalı. Örnekteki cümle kurum açıklamasında da geçtiği için JSON-LD'de iki kez görünüyor.
Tek bir cümleyi kontrol etmek yerine tüm soruları taramak için kısa bir Node betiği yeterli:
// sema-dom-eslesme.mjs — kullanım: curl -s URL > p.html && node sema-dom-eslesme.mjs p.html
import fs from 'fs';
const html = fs.readFileSync(process.argv[2], 'utf8');
const blocks = [...html.matchAll(/<script[^>]*type="application\/ld\+json"[^>]*>([\s\S]*?)<\/script>/g)].map(m => m[1]);
const body = html.replace(/<script[\s\S]*?<\/script>/g, ' ').replace(/<style[\s\S]*?<\/style>/g, ' ');
const decode = s => s.replace(/&/g,'&').replace(/"/g,'"').replace(/'/g,"'").replace(/'/g,"'").replace(/</g,'<').replace(/>/g,'>');
const text = decode(body.replace(/<[^>]+>/g, ' ')).replace(/<[^>]+>/g, ' ').replace(/\s+/g, ' ');
const qs = [];
const walk = o => { if (!o || typeof o !== 'object') return; if (Array.isArray(o)) return o.forEach(walk);
if (o['@type'] === 'Question') qs.push(o); Object.values(o).forEach(walk); };
for (const b of blocks) { try { walk(JSON.parse(b)); } catch {} }
let qOk = 0, aOk = 0;
for (const q of qs) {
const n = q.name.replace(/\s+/g, ' ').trim();
const a = (q.acceptedAnswer?.text || '').replace(/<[^>]+>/g, ' ').replace(/\s+/g, ' ').trim();
const qi = text.includes(n), ai = text.includes(a.slice(0, 80));
if (qi) qOk++; if (ai) aOk++; if (!qi || !ai) console.log('EKSİK', qi, ai, n.slice(0, 60));
}
console.log(`ld+json blok: ${blocks.length} | Question: ${qs.length} | soru görünür: ${qOk} | cevap görünür: ${aOk}`);
Betik /sss/ sayfasında 3 JSON-LD bloğu ve 41 soru buldu. Görünür metinde 41 sorunun 41'i, cevapların ilk 80 karakteri de 41'de 41 eşleşti. Aynı betiği dört sayfada daha çalıştırdık: FAQPage ile QAPage seçimini anlattığımız yazıda 10/10, AI Overview kaynak gösterme rehberinde 5/5, /geo-nedir/ sayfasında 8/8 ve ana sayfada 6/6.
Betiği yazarken yaşadığımız bir yanlış pozitif de öğretici oldu. Cevap metninde HTML kaçış karakterleriyle yazılmış etiket adları (<a> gibi) bulunan bir soru, normalizasyon sırası yanlış olduğu için "eksik" göründü. Çözüm, metni çözdükten sonra etiketleri ikinci kez temizlemekti. Eşleşme testinde her iki taraf da aynı normalizasyondan geçmelidir, yoksa sorun olmayan bir sayfa sorunlu görünür.
FAQ rich result kalktıysa FAQPage şemasını tutmalı mısınız?
Tutmak zarar vermez, ama tek başına iş de görmez. Google 7 Mayıs 2026'da FAQ rich result'ı kaldırdı ve işaretlemenin sorun çıkarmayacağını söylüyor. Microsoft tarafında şemanın LLM'lere yardımcı olduğu aktarıldı, Search Atlas ise şema kapsamıyla LLM görünürlüğü arasında ilişki bulmadı. Değer, şema görünür metnin aynası olduğunda ortaya çıkar.
Google'ın konuyla ilgili açıklaması net: FAQ yapılandırılmış verisi yerinde kalabilir, işaretleme sorun çıkarmaz, ama Google Aramada görünür bir sonuç da üretmez. Sheltron'da bu nedenle 16 FAQPage örneğini sitede tuttuk. Kararın gerekçesi, SERP'teki rich result faydası ile AI yüzeylerindeki varlık anlama faydasının farklı şeyler olmasıydı. Hangi şema tipinin hangi sayfaya uyduğu ayrı bir soru; onu FAQPage ve QAPage karşılaştırmamızda ayrıntılı ele aldık.
Şemanın kullanımı da yaygınlaşmaya devam ediyor. HTTP Archive'ın Web Almanac 2024 yapılandırılmış veri bölümüne göre sayfaların %41'inde JSON-LD bulunuyor; bu oran 2022'de %34'tü. FAQPage kullanan masaüstü sayfalarının payı da 2022'deki %0,2'den 2024'te %0,6'ya çıktı. Yani uyuşmazlık riski birkaç sitenin sorunu değil, JSON-LD kullanan her sitenin kontrol etmesi gereken bir konu.
Şemanın AI yüzeylerindeki etkisine dair kanıtlar ise birbirinden farklı yönlere işaret ediyor:
| Kaynak | Şema hakkında ne diyor? | Kanıt türü |
|---|---|---|
| Google, üretken AI araması rehberi (2026) | Üretken AI araması için şema gerekli değil; rich result uygunluğu için kullanmaya devam etmek iyi | Resmi doküman |
| Fabrice Canel, SMX Munich 2025 (Search Engine Roundtable aktarımı) | Şema, Microsoft'un LLM'lerinin içeriği anlamasına yardım ediyor | İkinci el aktarım |
| Search Atlas (Aralık 2025) | Tam şema kapsamına sahip alan adları, az ya da hiç şeması olmayanlardan daha iyi performans göstermiyor | Korelasyon analizi; şema türü ve kalitesi ölçülmedi |
| Belmore Digital (Mayıs 2026) | Mart 2026 itibarıyla şemanın AI görünürlüğüne etkisini ölçen hakemli çalışma yok | İkincil derleme |
| Bing Webmaster Blog (Şubat 2026) | Net başlıklar, tablolar ve SSS bölümleri öneriliyor; metin, görsel ve videonun aynı varlıkları tutarlı biçimde temsil etmesi isteniyor | Resmi blog |
Bu kaynakların ortak paydası şu: şema, görünür metni doğru tarif ettiği ölçüde işe yarar ve tek başına kaynak seçtirmez. Google, Mayıs 2026 itibarıyla yapılandırılmış verinin üretken AI araması için gerekli olmadığını yazıyor; alıntılanan birim görünür metindir. JSON-LD'nin temel yapısını ve tiplerini JSON-LD teknik rehberimizde anlattık. Şema ile görünür içerik ilişkisini sıfırdan öğrenmek isteyenler için GEO Akademi eğitimleri de iyi bir başlangıç noktası sunuyor.
Düzeltmenin etkisi nasıl ölçülmeli, neler iddia edilmemeli?
Önce DOM testini her deploy sonrasında çalışan bir regresyon kontrolüne dönüştürün, ardından aynı sorgu setinde AI Overview kaynaklığını yeniden ölçün. Bizim 0/10'dan 6/16'ya geçişimiz farklı sorgu setleriyle ve başka düzeltmelerle eş zamanlı gerçekleşti. Düzeltmenin tek başına etkisini kanıtlamıyor, yalnız yönünü gösteriyor.
Ölçüm tasarımında üç kural öneriyoruz:
- Önce regresyonu koruyun. Bir bileşen güncellemesi ya da kütüphane sürümü
forceMountdüzeltmesini sessizce geri alabilir. Playbook'umuzdaki ilk kontrolgrep -c 'data-state'satırıydı; ancakgrep -ceşleşme değil satır sayar vedata-statetetikleyici düğmelerde de bulunur, bu yüzden regresyonu yakalamaz. Deploy sonrası kontrol olarak yukarıdaki betiği ya darole="region"panel sayımını kullanın; sonuç 41/41'in altına düşerse bir şey bozulmuş demektir. - Sorgu setini sabitleyin. 23 Temmuz ile 9 Ağustos ölçümlerimizin en büyük zayıflığı farklı sorgu setleri kullanmalarıydı. Öncesi ve sonrası karşılaştırması aynı sorgularla, aynı araçla ve mümkünse günün aynı saatinde yapılmalı.
- Değişiklikleri ayırın. Aynı deploy'da 17 madde canlıya alındığında hangisinin etkili olduğu bilinemez. Kritik bir düzeltmeyi mümkünse tek başına yayına alın ve ölçüm tarihini önceden belirleyin.
İddia edilmemesi gerekenler de aynı derecede önemli. "Şemayı düzelttik, AI atıfı arttı" demek bizim verimizle mümkün değil. Söyleyebileceğimiz şu: cevaplar sunucu HTML'ine girdi, 41 sorunun 41'i görünür, aynı dönemde AI Overview kaynaklığı 6/16'ya çıktı. Aradaki bağ olası, ama ölçülmüş değil. Akademik tarafta da görünürlüğü oynatan şeyin sayfa metni olduğuna dair kanıt var: Princeton'daki GEO çalışması, sayfa içi metin değişikliklerinin üretken motor yanıtlarındaki görünürlüğü %40'a kadar artırabildiğini gösterdi. Aynı çalışma şemayı test etmedi.
Uyuşmazlığı kapattıktan sonra sıradaki adım erişimdir. Metin HTML'de olsa bile tarayıcı sayfaya giremiyorsa sonuç değişmez. Robots.txt AI bot kontrolü aracıyla hangi AI tarayıcılarına izin verdiğinizi görebilirsiniz. Ek makine-okunur dosyaların bu sorunu çözmediğini de hatırlatalım. Google'ın üretken AI araması rehberi, llms.txt gibi ek AI metin dosyalarına gerek olmadığını yazıyor; bu konudaki verimizi llms.txt yazımızda paylaştık. AI Overview tarafındaki genel çerçeve için Türkiye AI Overviews rehberimize, AI görünürlük ölçümüne dair sektör kaynakları için The GEO Authority sayfalarına bakabilirsiniz.
Şemanız ile sayfanız aynı şeyi söylüyor mu, yoksa yalnız JSON-LD mi konuşuyor? İlk cevabı yukarıdaki betik verir. Eşleşmeyi sağladıktan sonra sitenizin ChatGPT ve Gemini'de nasıl göründüğünü öğrenmek isterseniz, Sheltron'un ücretsiz hızlı değerlendirmesi görünürlük skorunuzu ve işletme verinizin tutarlılığını tek raporda toplar.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Şemada Var, Sayfada Yok: JSON-LD ile Görünür İçerik Uyuşmazlığı AI Atfını Nasıl Engeller?
- TL;DR
- Sheltron'un SSS cevapları FAQPage JSON-LD'sinde vardı ama sunucu HTML'inde yoktu: Radix akordeonu kapalı paneli DOM'a eklemiyordu, kategori sekmesi de 41 sorunun 36'sını HTML dışında bırakıyordu. Düzeltmeden sonra AI Overview kaynaklığı 0/10'dan (23 Temmuz 2026) 6/16'ya (9 Ağustos 2026) çıktı; sorgu setleri farklı olduğu için bu bir kanıt değil, yön işareti. Eylül 2026 testinde 41 sorunun 41'i görünür HTML'de.
- Ana Çıkarımlar (7)
- Sheltron'un /sss/ sayfasında JSON-LD'de 41 soru vardı, sunucu HTML'inde ise 5; kategori sekmesi 41 sorunun 36'sını HTML dışında bırakıyordu.
- Radix akordeonuna forceMount eklenip kapalı durum CSS ile daraltılınca cevaplar panel kapalıyken de sunucu HTML'inde yer aldı.
- AI Overview kaynaklığı 23 Temmuz 2026'da 0/10, 9 Ağustos 2026'da 6/16 oldu; sorgu setleri farklı ve aynı dönemde 17 madde canlıya alındığı için artış tek başına düzeltmeye bağlanamaz.
- Vercel ve MERJ'in 2024 ölçümlerine göre OpenAI, Anthropic ve Perplexity tarayıcıları JavaScript çalıştırmıyordu (OpenAI botlarının 25 Eylül 2026'dan itibaren bazı sitelerde render ettiğine dair tek, doğrulanmamış bir rapor var); Googlebot ise incelenen HTML sayfalarının %100'ünü render ediyor ama tıklama gerektiren içeriği yüklemiyor.
- HtmlRAG çalışmasına göre ham web sayfası token'larının %90'ından fazlası CSS, JavaScript ve yorumdur; JSON-LD de bir script bloğu olduğu için bu tür hatlarda atılabilir.
- Next.js sayfalarında basit grep aynı cevap cümlesini 4 kez sayabiliyor; doğru test script blokları atıldıktan sonra yapılır ve Eylül 2026'da /sss/ için 41/41 sonuç verdi.
- Google'a göre yapılandırılmış veri üretken AI araması için gerekli değil; şema, görünür metni doğru tarif ettiği ölçüde işe yarar.
- Kaynaklı Veriler
- 0/10 — 23 Temmuz 2026'da AI Overview çıkan 10 marka-dışı sorgunun hiçbirinde Sheltron kaynak değildi (Sheltron ölçümü (SEO-GEO playbook, 23 Temmuz 2026 denetimi), 2026)
- 6/16 — 9 Ağustos 2026'da Search Console'un ilk 20 marka-dışı sorgusundan AI Overview çıkan 16'sının 6'sında Sheltron kaynak gösterildi (farklı sorgu seti) (Sheltron ölçümü (SEO-GEO playbook §13b, DataForSEO SERP taraması, 9 Ağustos 2026), 2026)
- 41/41 — Eylül 2026 testinde /sss/ sayfasının JSON-LD'sindeki 41 sorunun tamamı ve cevapları görünür HTML metninde bulundu (düzeltme öncesi görünür soru sayısı 5) (Sheltron ölçümü (curl + Node şema-DOM eşleşme betiği), 2026)
- %11,50 — ChatGPT isteklerinin %11,50'si, Claude isteklerinin %23,84'ü JavaScript dosyasıydı; dosyalar indiriliyor ama çalıştırılmıyordu (Vercel & MERJ, The rise of the AI crawler, 2024)
- 569 milyon — GPTBot'un Vercel ağında bir ayda yaptığı istek sayısı (Claude: 370 milyon) (Vercel & MERJ, The rise of the AI crawler, 2024)
- %100 — Googlebot, incelenen 37.000'den fazla HTML sayfanın tamamını tam olarak render etti; medyan render gecikmesi 10 saniye (Vercel & MERJ, How Google handles JavaScript throughout the indexing process, 2024)
- %90'dan fazla — ham bir web sayfasındaki token'ların CSS, JavaScript, yorum gibi anlam taşımayan içerikten oluşan payı; temizlik sonrası HTML özgün boyutunun %6'sına iniyor (Tan vd., HtmlRAG (ACM Web Conference 2025), 2025)
- %41 — JSON-LD içeren sayfaların payı (2022'de %34) (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %0,6 — FAQPage kullanan masaüstü sayfalarının 2024'teki payı (2022'de %0,2) (HTTP Archive, Web Almanac 2024 — Structured Data, 2024)
- %40'a kadar — sayfa içi metin değişikliklerinin üretken motor yanıtlarındaki görünürlüğe olası katkısı (Aggarwal vd., GEO: Generative Engine Optimization (KDD 2024), 2024)
- Arama Niyetleri
- json-ld görünür içerik eşleşmesi
- accordion içindeki içerik ai tarafından okunur mu
- faq schema işe yaramıyor neden
- sekme içeriği indekslenir mi
- gizli içerik seo 2026
- ssr faq accordion
- schema markup dom uyumu
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz