
HTML Tablolar AI Cevaplarında Nasıl Alıntılanır? Karşılaştırma Tablosu, Caption ve Tanım Listesi (dl)
Bir HTML tablonun ChatGPT, Copilot ya da Google AI Overviews cevabına ulaşması için geçmesi gereken dört eşik; aynı verinin beş HTML yapısıyla yapılan çıkarıcı testi, caption ve scope kullanımı, tablo görseli, tanım listesi (dl) seçimi ve yayın öncesi kontrol listesi.
💡Kısa Özet
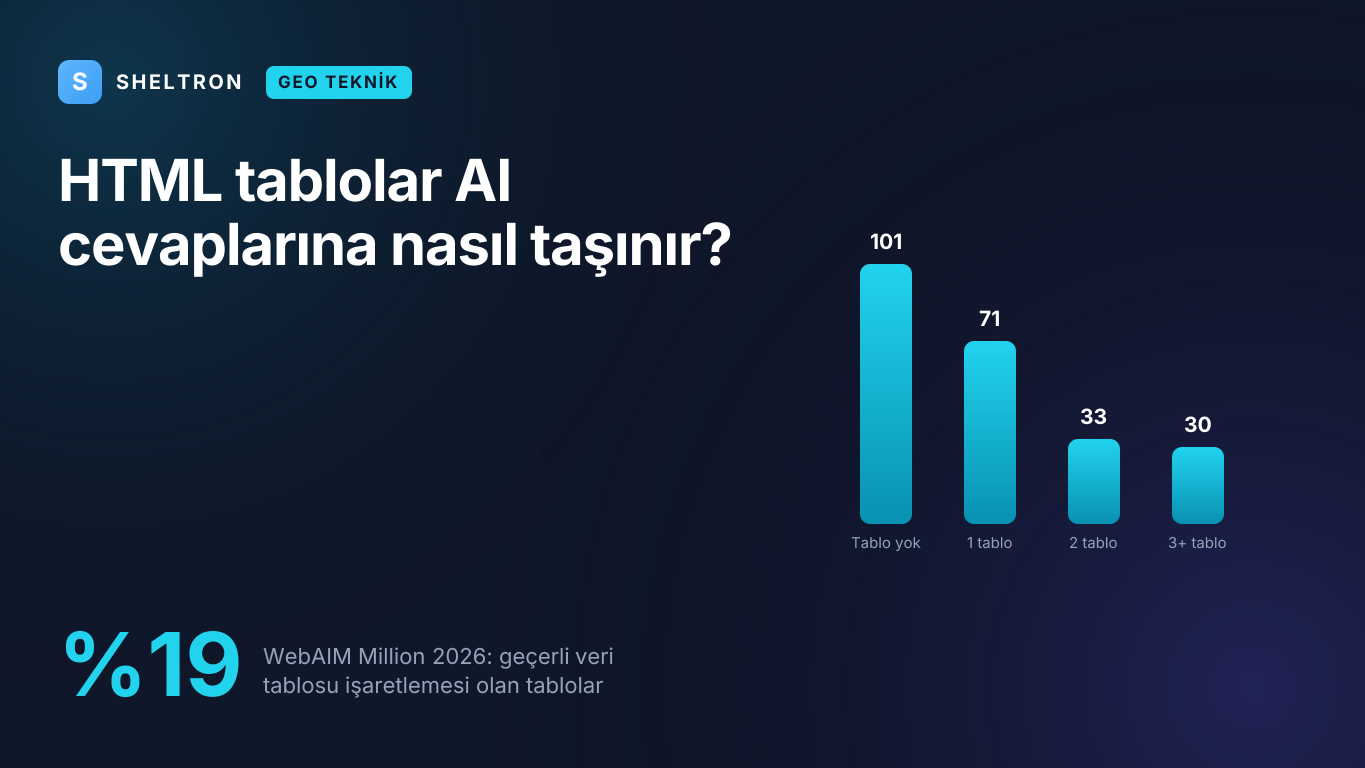
WebAIM Million 2026'ya göre 1 milyon ana sayfadaki 948.225 tablonun yalnız %19'u geçerli veri tablosu işaretlemesine sahip. Eylül 2026 testimizde aynı veri yalnız semantik table içinde tablo olarak kaldı; div ızgarası 9 kopuk satıra, JavaScript tablosu tek başlık satırına indi, trafilatura caption metnini düşürdü. Sheltron blogundaki 249 tablonun hiçbirinde caption ya da scope yok.
Ana Çıkarımlar
- •WebAIM Million 2026'da 1 milyon ana sayfadaki 948.225 tablonun yalnız %19'u (181.188) geçerli veri tablosu işaretlemesine sahipti.
- •Eylül 2026 testinde aynı veri üç çıkarıcıda yalnız semantik table içinde tablo olarak kaldı; div ızgarası 9 kopuk satıra, JavaScript ile doldurulan tablo yalnız başlık satırına indi.
- •Masaüstü sitelerin yalnız yaklaşık %1,6'sı caption kullanıyor (Web Almanac 2025) ve trafilatura caption metnini çıktıya taşımadı; tablonun konusu önceki cümlede de yazılmalı.
- •Table Meets LLM (WSDM 2024): HTML işaretlemesiyle yedi görevde %65,43 ortalama başarı, ayraçlı düz metne göre %6,76 iyileşme.
- •Vercel'in Aralık 2024 ölçümüne göre GPTBot, ClaudeBot ve PerplexityBot JavaScript render etmiyordu; tablo verisi sunucu HTML'inde olmalı.
- •Sheltron'un data-llm-summary dl bloğu 235 yazının 233'ünde SSR HTML'de var ama trafilatura çıktısında dt-dd eşleşmesi düz listeye iniyor; dd tek başına anlamlı olmalı.
- •Sheltron blogundaki 249 tablonun hiçbirinde caption ya da scope yok; 3+ tablolu 24 yazı 120 günde Copilot atfı almadı, ancak 23'ü atıf oranının zaten düşük olduğu Mayıs 2026 sonrası döneme ait.
Bir HTML tablonun AI cevabında alıntılanabilmesi için sunucudan gelen HTML'de gerçek bir <table> olarak bulunması, başlık hücrelerinin <th> ile işaretlenmesi ve her satırın bağlamından koparıldığında da anlaşılır kalması gerekir. Web'deki tabloların çoğu bu koşulu karşılamıyor: WebAIM Million 2026 taramasında 1 milyon ana sayfada bulunan 948.225 tablonun yalnızca 181.188'i, yani %19'u geçerli veri tablosu işaretlemesine sahipti.
Ekranda kusursuz görünen bir karşılaştırma tablosu, makine için birbirinden kopuk satırlar, bir görsel dosya adı ya da boş bir başlık satırı olabilir. Eylül 2026'da aynı veriyi beş farklı HTML yapısında hazırlayıp üç açık kaynak metin çıkarıcıdan geçirdik, ardından Sheltron blogundaki 249 tabloyu taradık. Aşağıda bu testlerin sonuçlarını, W3C ve WHATWG standartlarının ne dediğini ve tablo ile tanım listesi (<dl>) arasındaki seçimi birlikte ele alıyoruz.
Pasajın sayfadaki konumu, uzunluğu ve answer-first yapısı LLM sayfanın neresinden alıntı yapar yazımızın konusu. Bu yazı yalnızca tablo ve tanım listesi gibi yapılandırılmış HTML öğelerinin makineye nasıl ulaştığına odaklanıyor.
Bir tablo AI cevabına hangi aşamalardan geçerek ulaşır?
Bir tablo AI cevabına dört eşikten geçerek ulaşır: bot tabloyu ham HTML'de bulmalı, metin çıkarıcı satır ve sütun ilişkisini korumalı, parçalama sırasında başlık bağlamı kopmamalı ve model hücreleri doğru okumalıdır. Görsel olarak kusursuz bir tablo, bu eşiklerin ilkinde bile kaybolabilir.
- Erişim: AI botu sayfayı bir kullanıcının tarayıcısı gibi çizmez; çoğu durumda sunucunun gönderdiği HTML'i okur. Tablo bu HTML'de yoksa sonraki adımların hiçbiri gerçekleşmez.
- Metin çıkarma: HTML, bir çıkarıcı yardımıyla düz metne ya da markdown'a çevrilir. Satır-sütun ilişkisi bu adımda korunabilir ya da dağılabilir.
- Parçalama: Metin, getirme (retrieval) sistemine girmeden önce küçük parçalara bölünür. Tablo satırları başlıklarından ayrılabilir.
- Anlama ve atıf: Model, eline ulaşan parçayı okur ve cevaba uygun bulursa kaynak olarak gösterir.
Canlı AI arama ürünlerinin ikinci adımda hangi aracı kullandığı kamuya açık değil. Açık olan şu: FineWeb makalesine göre 96 Common Crawl anlık görüntüsünden derlenen 15 trilyon tokenlık eğitim seti, HTML'den metin çıkarmak için açık kaynak trafilatura kütüphanesini kullanıyor; RefinedWeb de aynı aracı tercih ediyor. Testimizde trafilatura'yı bu yüzden seçtik. Sonuçlar temsilî bir gözlemdir, "ChatGPT tablonuzu tam olarak böyle görür" anlamına gelmez.
Üçüncü adımı Microsoft Bing, Ekim 2025 tarihli yazısında açıkça tarif ediyor: Copilot gibi asistanlar içeriği "parsing" adı verilen bir süreçle daha küçük, yapılandırılmış parçalara ayırır. Google ise AI özellikleri dokümanında (son güncelleme 10 Aralık 2025, Eylül 2026 itibarıyla geçerli) AI Overviews ve AI Mode için ek bir gereksinim ya da özel optimizasyon olmadığını, önemli içeriğin metin olarak erişilebilir olması gerektiğini belirtiyor. Google tarafındaki kaynak seçimini AI Overview'da kaynak gösterilme rehberimizde ayrıntılı işledik.
Yapısal müdahalelerin etkisi akademik olarak da ölçülmüş durumda: Aggarwal ve arkadaşlarının KDD 2024'te yayımlanan GEO çalışmasına göre GEO yöntemleri, üretken motor cevaplarındaki görünürlüğü %40'a kadar artırabiliyor. Atıf mekanizmasının genel çerçevesini AI Overviews atıf bilimi yazımızda, kavramların ayrıntılı tanımlarını ise The GEO Authority kaynaklarında bulabilirsiniz.
Semantik HTML tablosu neden div ızgarasından ve görselden daha iyi okunur?
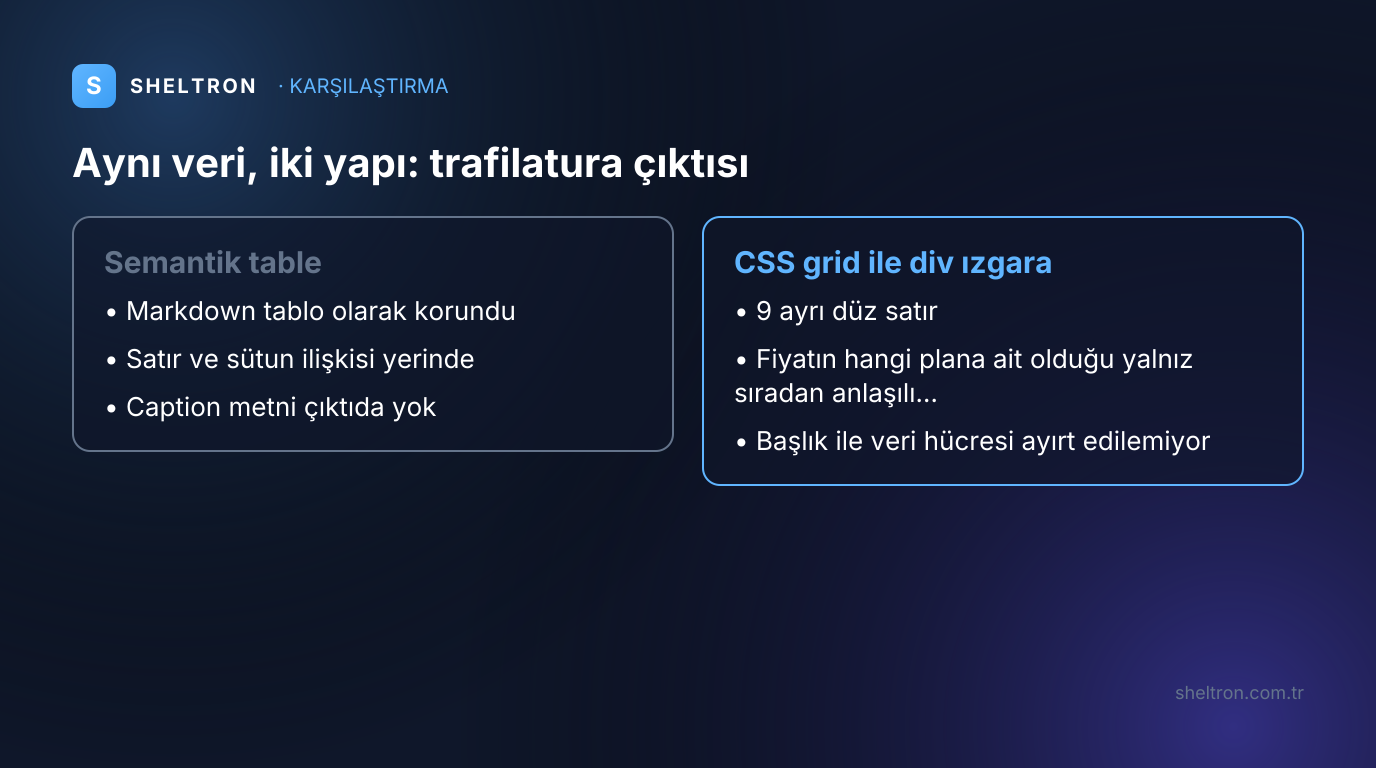
Semantik <table>, satır ve sütun ilişkisini işaretlemenin kendisinde taşır; div ızgarası bu ilişkiyi yalnızca CSS'te, tablo görseli ise yalnızca piksellerde tutar. Eylül 2026'da aynı veriyi üç çıkarıcıdan geçirdiğimizde yalnızca <table> sürümü tablo olarak kaldı, div ızgarası dokuz kopuk satıra dönüştü.
Test için iki satırlık kurgusal bir plan tablosu hazırladık: Başlangıç planı aylık 490 TL ve 1 kullanıcı, Pro planı aylık 1.490 TL ve 5 kullanıcı. Aynı veriyi beş yapıda aynı sayfaya koyduk ve JavaScript çalıştırmadan trafilatura 2.1.0, markdownify 1.2.3 ve BeautifulSoup 4.15.0 ile metne çevirdik. Beş yapının üç çıkarıcıdaki çıktısı aşağıdaki tabloda:
| Yapı | trafilatura 2.1.0 | markdownify 1.2.3 | BeautifulSoup 4.15.0 |
|---|---|---|---|
A. Semantik <table> (caption ve scope ile) |
Markdown tablo olarak korundu, caption metni düştü | Tablo korundu, caption tablonun üstünde düz satır olarak geldi | Hücreler alt alta düz satırlara dönüştü |
| B. CSS grid ile kurulmuş div ızgara | 9 ayrı satır; fiyatın hangi plana ait olduğu yalnızca sıradan çıkarılabiliyor | Aynı 9 ayrı satır | Aynı 9 ayrı satır |
C. Tablo görseli (<img> ve alt metni) |
Markdown modunda yalnızca alt metin ve dosya adı, düz metin modunda hiçbir şey | Yalnızca alt metin ve dosya adı | Hiçbir şey |
| D. JavaScript ile doldurulan tablo | Yalnızca başlık satırı, veri yok | Başlık satırı ve boş gövde | Yalnızca üç başlık |
E. Tanım listesi (<dl>) |
Düz madde listesi; terim ile değer arasındaki eşleşme kayboldu, sıra korundu | Tanım listesi sözdizimi, eşleşme korundu | Alt alta satırlar |
trafilatura'nın düz metin çıktısından iki parça farkı somut olarak gösteriyor. Semantik tablo eksiksiz geliyor; JavaScript ile doldurulan tablodan geriye yalnızca başlık satırı kalıyor:
A. Semantik tablo
| Plan | Aylık fiyat | Kullanıcı |
|---|---|---|
| Başlangıç | 490 TL | 1 |
| Pro | 1.490 TL | 5 |
D. İstemci tarafında doldurulan tablo
| Plan | Aylık fiyat | Kullanıcı |
|---|
Aynı iki satırlık veri, semantik tabloda tablo olarak kaldı; div ızgarasında dokuz kopuk satıra, JavaScript ile doldurulan tabloda tek bir başlık satırına indi.
Model tarafında da işaretleme fark yaratıyor. Sui ve arkadaşlarının Table Meets LLM çalışması (WSDM 2024), GPT-3.5 ve GPT-4 ile yedi tablo anlama görevinde en yüksek ortalama başarıya (%65,43) HTML işaretlemesi, biçim açıklaması ve rol istemi birlikte kullanıldığında ulaşıldığını raporluyor. HTML işaretlemesi, ayraçlı düz metin serileştirmesine göre %6,76 iyileşme sağladı; yazarlara göre model HTML ve XML biçimlerine daha aşina.
WHATWG HTML standardı <table> öğesini "birden fazla boyutu olan veri" olarak tanımlıyor ve tabloların düzen aracı olarak kullanılmaması gerektiğini ayrıca vurguluyor. Tabloyu sayfa düzeni için kullanma alışkanlığı da sürüyor: Web Almanac 2025 verisine göre mobil tabloların %4,9'u role="presentation" ile açıkça düzen tablosu olarak işaretlenmiş; bu oran 2024'te %4, 2022'de %1'di. WHATWG, düzen amacıyla kullanılan tabloların ekran okuyucu kullanıcıları için sayfada gezinmeyi çok zorlaştırdığını da not ediyor.
Caption, th ve scope öğeleri makine için ne ifade eder?
<th> hücrenin başlık olduğunu, scope bu başlığın satıra mı sütuna mı ait olduğunu, <caption> ise tablonun konusunu bildirir. Ancak masaüstü sitelerin yalnızca yaklaşık %1,6'sı caption kullanıyor ve testimizde trafilatura caption metnini çıktıya taşımadı. Tablonun konusunu hemen öncesindeki cümlede de yazın.
W3C WAI tablo eğitimi, başlık ve veri hücrelerini yapısal işaretlemeyle ayırmayan tabloların erişilebilirlik engeli oluşturduğunu söylüyor ve her başlığın yönünü scope="col" ya da scope="row" ile tanımlamayı öneriyor. Aynı kaynağa göre caption "tablo için başlık işlevi görür" ve ekran okuyucuların çoğu onu seslendirir. Ekran okuyucu için anlam taşıyan bu işaretleme, metin çıkarıcı ve dil modeli için de aynı ilişkiyi tarif ediyor.
WHATWG ve W3C WAI kalıbına uygun bir karşılaştırma tablosu şöyle görünür:
<table>
  <caption>Plan karşılaştırması: aylık fiyat ve kullanıcı sayısı (Eylül 2026)</caption>
  <thead>
    <tr>
      <th scope="col">Plan</th>
      <th scope="col">Aylık fiyat</th>
      <th scope="col">Kullanıcı</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <th scope="row">Başlangıç planı</th>
      <td>490 TL/ay</td>
      <td>1 kullanıcı</td>
    </tr>
    <tr>
      <th scope="row">Pro planı</th>
      <td>1.490 TL/ay</td>
      <td>5 kullanıcı</td>
    </tr>
  </tbody>
</table>
Karmaşık tablolarda W3C WAI, <figure> ve <figcaption> kullanıp tabloyu aria-labelledby ile başlığa bağlamayı da geçerli bir alternatif olarak gösteriyor. Bu yapı, kaynak ve tarih bilgisini tablonun hemen üstünde görünür bir satırda tutmanın da kolay bir yolu.
Caption'ın standartlardaki yeri net olsa da pratikte nadir: Web Almanac 2025 masaüstü sitelerin yalnızca yaklaşık %1,6'sının herhangi bir tabloda caption kullandığını ölçtü. Testimizde de trafilatura caption metnini düşürdü, markdownify ise tablonun üstünde sıradan bir satır olarak verdi. Caption'ı eklemek doğru, ama tek başına ona güvenmek riskli.
Kendi sitemizi de aynı gözle denetledik. Eylül 2026'da canlı 235 Sheltron blog yazısının sunucu HTML'ini taradık: 134 yazıda en az bir tablo var, toplam 249 tablo. Tamamında <thead> ve <th> bulunuyor, ancak hiçbirinde <caption> ya da scope yok. Sebep içerik akışında: Markdown (GFM) tablo sözdizimi bu iki öğeyi üretmiyor, CMS'teki karşılaştırma tablosu bileşeni de tablo başlığını tablonun dışında ayrı bir paragraf olarak basıyor. GEO terimleri sözlüğümüzdeki tablo da aynı durumda. Bu yazıdaki tablolar da Markdown'dan üretildiği için her tablonun konusunu hemen önceki cümlede yazdık.
Tablo görseli yapay zekâ tarafından okunabilir mi?
Bazen okunabilir ama buna güvenmek doğru değil. ACL 2024'te yayımlanan bir çalışmada GPT-4 ve Gemini-pro, Wikipedia tabanlı tablo görevlerinde metin olarak verilen tabloyla anlamlı ölçüde daha iyi sonuç aldı. Microsoft Bing de kritik bilginin yalnızca görselde bırakılmamasını öneriyor. Görseli koruyun, yanına HTML kopyasını ekleyin.
Deng ve arkadaşlarının Tables as Texts or Images çalışması tabloları beş metin ve üç görsel temsil biçiminde modele verdi. Sonuç veri setine göre değişti: WikiTQ ve TabFact'te hem GPT-4 hem Gemini-pro metinle anlamlı ölçüde daha iyi çalıştı, finansal sorulardan oluşan FinQA'da ise görsel temsil öne geçti. Yani "görsel tablo hiç okunmaz" demek de, "görsel yeterlidir" demek de yanlış olur. Tek yönlü, genellenebilir bir sonuç yok.
Bing'in önerisi pratik taraftan aynı yere varıyor: AI sistemleri görsellerden bazen metin çıkarabilse de bu, süreci karmaşıklaştırıyor ve çoğu zaman doğruluğu düşürüyor. Asıl sorun ise modelden önce ortaya çıkıyor. Testimizdeki tablo görseli, trafilatura'nın markdown çıktısında yalnızca alt metin ("Plan karşılaştırma tablosu") ve dosya adından oluşan tek bir görsel satırına dönüştü; varsayılan düz metin modunda ve BeautifulSoup'ta ise hiç görünmedi. Alt metin tablonun adını söylüyor ama tek bir değer taşımıyor.
Uygulamada doğru yaklaşım ikisini birlikte yayımlamak:
- Görsel kopya: Okur için hızlı kavrama, sosyal medya ve sunum paylaşımı.
- HTML kopya: Aynı rakamların semantik
<table>içinde, görselin hemen altında ya da üstünde yer alması. - Alt metin: Tablonun adını değil, ana bulguyu tek cümleyle söyleyen bir açıklama.
Bu yazıdaki grafiklerde de aynı kuralı izledik: görsellerdeki her rakam metinde kaynağıyla birlikte geçiyor.
JavaScript ile doldurulan ya da sekmeye gizlenen tablolar neden kaybolur?
Büyük AI tarayıcılarının çoğu JavaScript çalıştırmıyor; istemci tarafında doldurulan bir tablo bu botlara yalnızca başlık satırı olarak ulaşır. Sekme ya da akordeon kapalıyken DOM'dan çıkarılan tablolar da aynı riski taşır. Bu nedenle tablo verisi, sayfanın sunucudan gelen ilk HTML'inde bulunmalıdır.
Vercel'in Aralık 2024 ölçümüne göre OAI-SearchBot, ChatGPT-User, GPTBot, ClaudeBot ve PerplexityBot JavaScript render etmiyordu. ChatGPT tarayıcılarının isteklerinin %11,50'si, Claude'un isteklerinin %23,84'ü JavaScript dosyası çekiyor ama bu dosyaları çalıştırmıyordu; Gemini ve AppleBot ise render ediyordu. Bu ölçüm Aralık 2024 tarihli ve bot davranışı o günden bu yana değişmiş olabilir, bu yüzden kendi sunucu kayıtlarınızla doğrulamanız gerekir. Google render ediyor, ancak JavaScript SEO dokümanı (son güncelleme 4 Mart 2026) sayfaların render kuyruğunda bekleyebileceğini ve "her botun JavaScript çalıştıramayacağını" belirterek sunucu tarafı render'ı önermeye devam ediyor.
Testimizdeki JavaScript tablosu tam bu senaryoyu gösterdi: üç çıkarıcıda da yalnızca "Plan, Aylık fiyat, Kullanıcı" başlıkları kaldı. Bing de aynı yazısında önemli cevapların sekmelere ya da açılır menülere gizlenmemesini öneriyor; gerekçesi, AI sistemlerinin gizli içeriği render etmeyebilmesi. Kapalıyken DOM'dan tamamen çıkan bir sekme, fiilen olmayan bir tablodur. Hızlı bir kontrol için curl -s https://alanadiniz.com/sayfa/ | grep -c "<table" komutu, tablonun sunucu HTML'inde olup olmadığını gösterir.
Tanım listesi (dl) ne zaman tablodan daha doğru seçimdir?
Birden fazla nesneyi aynı özelliklerle karşılaştırıyorsanız tablo, tek bir nesnenin "etiket: değer" çiftlerini veriyorsanız tanım listesi (<dl>) kullanın. WHATWG <dl> öğesini ad-değer gruplarından oluşan bir ilişki listesi olarak tanımlar. Sheltron'un her blog yazısının altındaki data-llm-summary özet bloğu da böyle bir <dl>'dir.
WHATWG'nin <dl> tanımına göre liste, <dt> ve <dd> gruplarından oluşur ve her grup bir <div> ile sarılabilir. Standart ayrıca <dl>'nin diyalog işaretlemek için uygun olmadığını belirtiyor. Aşağıdaki kalıp geçerli ve okunaklıdır:
<dl>
  <div><dt>Başlangıç planı</dt><dd>Başlangıç planı aylık 490 TL'dir ve 1 kullanıcıyı kapsar.</dd></div>
  <div><dt>Pro planı</dt><dd>Pro planı aylık 1.490 TL'dir ve 5 kullanıcıyı kapsar.</dd></div>
</dl>
Taramamızda 235 yazının 233'ünde bu özet bloğu sunucu HTML'inde bulunuyordu, yani blok metin olarak makineye ulaşıyor. Asıl soru, etiket ile değer arasındaki ilişkinin korunup korunmadığı. AI Overview kaynak gösterme rehberimizi Eylül 2026'da trafilatura'dan geçirdik. Yazıdaki iki markdown tablosu eksiksiz tablo olarak çıktı. Özet bloğu ise düz bir madde listesine indi ve başlığın yanındaki "LLM-Readable" rozeti ilk etiketle birleşti:
LLM-Readable- Konu
- Google AI Overview'da Nasıl Kaynak Gösterilirsiniz? (2026 Rehberi)
- TL;DR
- 2026'da Google aramalarının %68'i tıklamasız bitiyor ...
Kurgusal plan verisiyle yaptığımız testte de sonuç aynıydı: trafilatura <dl>'yi "Başlangıç planı" ve "Aylık 490 TL, 1 kullanıcı" satırlarından oluşan düz bir listeye çevirdi, markdownify ise eşleşmeyi tanım listesi sözdizimiyle korudu. Buradan çıkan kural basit: <dd> içeriği, etiketi olmadan okunduğunda da anlamlı olmalı. "TL;DR" etiketinin altına tam bir cümle yazmak, "490 TL" yerine "Başlangıç planı aylık 490 TL'dir" demek bu yüzden önemli.
Veri şekline göre hangi HTML öğesinin seçileceği aşağıdaki tabloda özetleniyor:
| Veri şekli | Örnek | Uygun HTML öğesi | Dikkat edilecek nokta |
|---|---|---|---|
| Birden fazla nesne, ortak özellikler | Üç aracın fiyatı, izlediği platformlar ve dil desteği | <table> ile <th scope> |
Caption çıkarıcıda düşebilir; konu önceki cümlede de yazılmalı |
| Tek nesnenin etiket-değer çiftleri | Bir yazının konusu, özeti ve ana çıkarımları | <dl> |
Eşleşme düz listeye inebilir; <dd> tek başına anlamlı olmalı |
| Sıralı adımlar | Kurulum ya da denetim adımları | <ol> |
Her adım tek başına anlaşılır bir cümle olmalı |
| Sırasız, eşit ağırlıklı maddeler | Bir yöntemin avantajları | <ul> |
Maddeler birbirine atıf yapmamalı |
| Tek bir sayısal bulgu | Bir oranın kaynağı ve tarihiyle verilmesi | <p> içinde tam cümle |
Rakam, kaynak ve tarih aynı cümlede olmalı |
Listelerin değeri de ölçülmüş durumda. AirOps'un Temmuz 2025 raporuna göre ChatGPT'nin alıntıladığı URL'lerin beşte dördüne yakınında en az bir liste bölümü vardı, Google'ın ilk sonuçlarında bu oran %28,6'ydı. Aynı raporda alıntılanan URL'lerin %68,7'si sıralı bir başlık hiyerarşisi izliyordu ve sıralı başlık kullanımı atıf olasılığını 2,8 kat artırıyordu.
Karşılaştırma tablosu parçalandığında da anlamlı kalacak şekilde nasıl tasarlanır?
Açık kaynak parçalama araçları tabloyu ayrı bir parça olarak işler, büyükse satır gruplarına böler. Bu yüzden her satır tek başına okunduğunda da doğru olmalıdır: satır başlığında varlığın tam adı, hücrede birim ve tarih, sütun başlığında ise kısa ve tekil bir etiket bulunmalıdır.
Unstructured dokümantasyonu bu davranışı açıkça yazıyor: tablo öğesi her zaman ayrı tutulur ve başka bir öğeyle birleştirilmez; varsayılan 500 karakterlik sınırı aşan tablo iki ya da daha fazla parçaya bölünür. Bölünen parça, sütun başlıklarından uzak düşen bir "Pro, 1.490, 5" satırına dönüşebilir. Tek başına okunduğunda bu satırın hangi ürünü, hangi para birimini ve hangi dönemi anlattığı belirsizdir.
Anthropic'in Contextual Retrieval yazısı aynı sorunu düz metin için gösteriyor. Yazıdaki örnekte geçen "Şirketin geliri bir önceki çeyreğe göre %3 arttı" cümlesi, hangi şirketten ve hangi çeyrekten söz ettiği bilinmeden işe yaramaz. Parçalara bağlam eklendiğinde başarısız getirme %49 azaldı, yeniden sıralama (reranking) eklendiğinde bu oran %67'ye çıktı. Tablo satırında bağlamı eklemenin en ucuz yolu onu doğrudan hücreye yazmak.
Aynı satırın zayıf ve güçlü yazımı aşağıdaki tabloda karşılaştırılıyor:
| Hücre | Zayıf yazım | Güçlü yazım |
|---|---|---|
| Satır başlığı | Pro | Pro planı |
| Fiyat | 1.490 | 1.490 TL/ay (Eylül 2026) |
| Kapasite | 5 | 5 kullanıcı |
| Parça tek başına okunduğunda | Ürün, para birimi ve dönem belirsiz | Ürün, birim ve tarih satırın içinde |
Microsoft Bing'e göre madde listeleri, numaralı adımlar ve karşılaştırma tabloları karmaşık ayrıntıları "temiz, yeniden kullanılabilir parçalara" ayırıyor. Bu avantaj ancak satırlar bağımsız okunabildiğinde işe yarar. Editoryal önerimiz (kaynaklı bir kural değil) karşılaştırma tablolarını 5-8 satır ve 3-5 sütun aralığında tutmak, daha büyük veriyi konuya göre iki tabloya bölmek ve her tablonun önüne ne karşılaştırdığını söyleyen bir cümle koymak.
"X ile Y karşılaştırması" sorgularında tablonun rolünü B2B SaaS karşılaştırma sorgularını kazanma yazımızda, Google'ın tablo snippet'lerini ise AI Overviews snippet ve feature card rehberimizde ele aldık. Canlı bir örnek için GEO ve SEO karşılaştırma sayfamıza bakabilirsiniz.
Çok tablo daha çok atıf getirir mi? Sheltron verisi ne diyor?
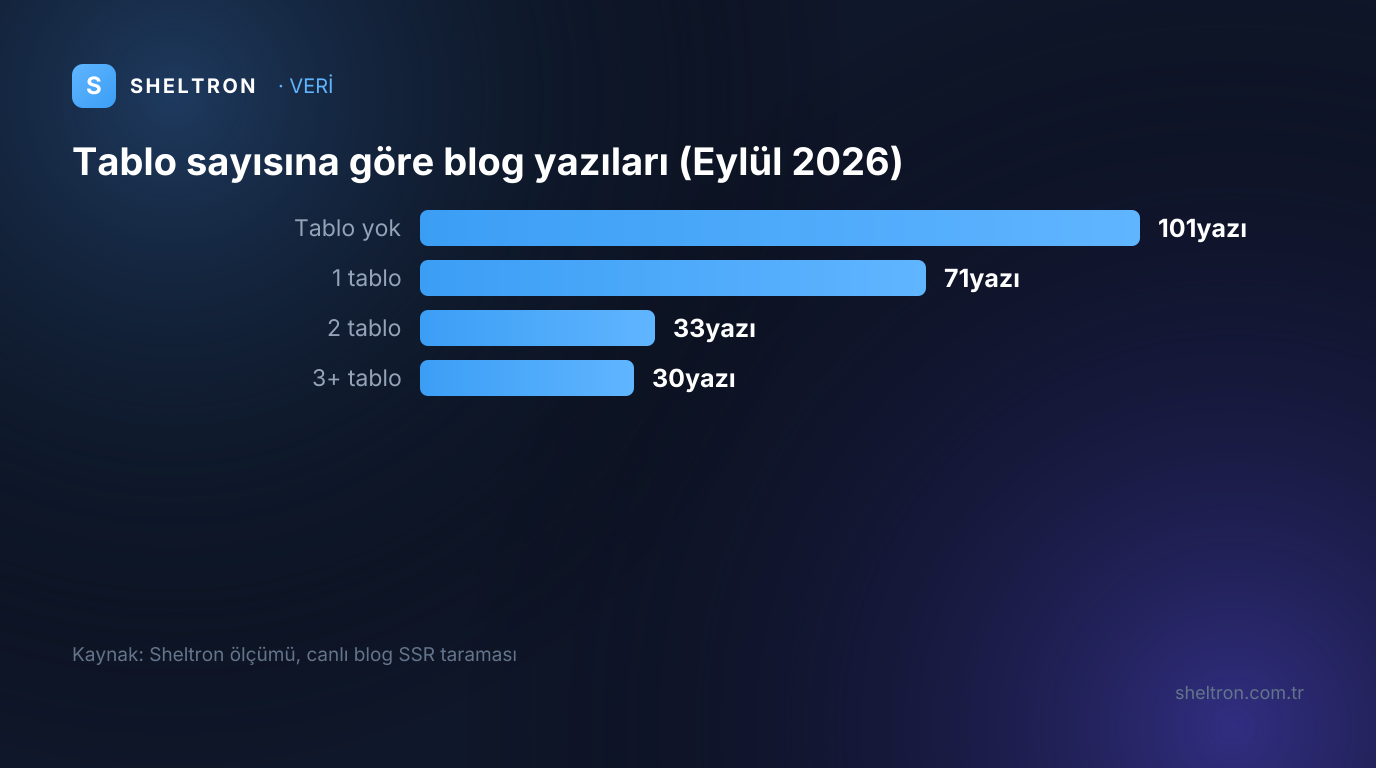
Kendi verimizde tablo sayısını artırmak tek başına atıf getirmedi. 3 ve daha fazla tablolu 24 yazı, 120 günlük Copilot atıf penceresinde hiç atıf almadı. Ancak bu yazıların 23'ü, atıf oranının tüm yazılarda zaten düşük olduğu Mayıs 2026 sonrası döneme ait; bu veriden nedensellik çıkarılamaz.
Eylül 2026 taramasında 235 yazının 101'inde tablo yoktu, 71'inde bir, 33'ünde iki, 30'unda ise üç ve daha fazla tablo vardı. Tablo sayılarını, Microsoft Clarity'nin 9 Ağustos 2026'da biten 120 günlük Copilot atıf verisiyle eşleştirdik ve 217 yazıda eşleşme elde ettik. Yayın dönemini sabit tutarak yaptığımız karşılaştırma aşağıdaki tabloda:
| Yayın dönemi | Tablo sayısı | Yazı | Atıf alan | Atıf alan oranı |
|---|---|---|---|---|
| Şubat 2026 öncesi | 0 | 15 | 2 | %13,3 |
| Şubat 2026 öncesi | 1-2 | 10 | 4 | %40,0 |
| Şubat–Nisan 2026 | 0 | 25 | 11 | %44,0 |
| Şubat–Nisan 2026 | 1-2 | 25 | 7 | %28,0 |
| Şubat–Nisan 2026 | 3+ | 1 | 0 | %0 |
| Mayıs 2026 ve sonrası | 0 | 59 | 3 | %5,1 |
| Mayıs 2026 ve sonrası | 1-2 | 59 | 2 | %3,4 |
| Mayıs 2026 ve sonrası | 3+ | 23 | 0 | %0 |
İlişkinin yönü dönemden döneme değişiyor: Şubat 2026 öncesinde tablolu yazılar daha sık atıf almış, Şubat–Nisan döneminde tersi olmuş. Mayıs 2026 sonrasında ise oran, tablosuz ve 1-2 tablolu yazılarda %5,1 ile %3,4'e, 3 ve daha fazla tablolu yazılarda sıfıra inmiş; yani bu dönemde hangi grupta olursa olsun atıf almak istisnaydı. Bu karşılaştırmayı okurken dört sınırlılığı akılda tutmak gerekiyor:
- Gözlemsel veri: Yazılar rastgele tablo almadı; tablolu yazılar konu ve tip olarak farklı olabilir.
- Küçük örneklem: 3 ve daha fazla tablolu grupta eşleşen yazı sayısı yalnızca 24.
- Zaman farkı: Atıf penceresi 9 Ağustos 2026'da bitiyor, tablo sayımı Eylül 2026'da yapıldı; aradaki içerik değişiklikleri bilinmiyor.
- Tek yüzey: Clarity yalnızca Copilot atıflarını ölçüyor; ChatGPT, Perplexity ve Google AI Overviews bu veride yok.
Bu veriyle savunulabilecek sonuç şu: tablo sayısı tek başına atıfı öngörmüyor. Tablonun biçiminin atıfa etkisini ölçmek içinse aynı konuda, aynı dönemde yayımlanan sayfalarla kontrollü bir test gerekir. O teste kadar yapılabilecek en sağlam şey, tablonun makineye eksiksiz ulaştığından emin olmaktır.
Yayından önce bir tablo nasıl test edilir?
Bir tabloyu yayına almadan önce yedi noktayı kontrol edin: tablo sunucu HTML'inde mi, <th> ve scope var mı, konusu tablodan önceki cümlede yazıyor mu, satır başlıkları tek başına anlamlı mı, birim ve tarih hücrede mi, görselin HTML kopyası var mı ve tablo bir sekmede gizli mi?
- Sunucu HTML'i: Sayfanın ham HTML'inde
<table>etiketi görünüyor mu? JavaScript sonrası oluşan DOM'a değil, sunucu yanıtına bakın. - Başlık hücreleri: Sütun başlıkları
<th scope="col">, satır başlıkları<th scope="row">ile işaretli mi? - Tablonun konusu: Caption'a ek olarak tablodan hemen önceki cümle ya da bir H3, tablonun neyi karşılaştırdığını söylüyor mu?
- Satır başlıkları: Her satır, varlığın tam adıyla başlıyor mu ("Pro" yerine "Pro planı")?
- Birim ve tarih: Para birimi, ölçü birimi ve veri tarihi hücrenin içinde mi?
- Görsel ve HTML kopya: Tablo görsel olarak da yayımlanıyorsa aynı rakamlar HTML tabloda da var mı?
- Gizli içerik: Tablo, kapalıyken DOM'dan çıkan bir sekme ya da akordeon içinde mi?
İlk üç maddeyi komut satırından hızlıca doğrulayabilirsiniz. Aşağıdaki komutlar tablonun ve caption'ın sunucu HTML'inde olup olmadığını, Python satırları ise sayfanın trafilatura çıktısında nasıl göründüğünü gösterir:
curl -s https://alanadiniz.com/sayfa/ | grep -c "<table"
curl -s https://alanadiniz.com/sayfa/ | grep -o "<caption[^>]*>[^<]*"
import trafilatura, urllib.request
html = urllib.request.urlopen("https://alanadiniz.com/sayfa/").read().decode("utf-8")
print(trafilatura.extract(html, output_format="markdown", include_tables=True))
Sayfa yapısını komut satırı olmadan incelemek için Sheltron'un ücretsiz içerik denetimi aracını kullanabilirsiniz. Tabloya JSON-LD eklemek görünür tablonun yerini tutmaz; Google da AI özellikleri için özel bir optimizasyon gerekmediğini belirtiyor. Şema tarafını Schema.org ve JSON-LD rehberimizde ele aldık, mevcut işaretlemenizi şema doğrulayıcıyla kontrol edebilirsiniz. Ekibinizle bu teknik temelleri adım adım çalışmak isterseniz GEO Akademi eğitimleri iyi bir başlangıç noktası. Düzeltmelerden sonra sayfanın AI cevaplarında gerçekten kaynak gösterilip gösterilmediğini Sheltron AiSEO ile izleyebilirsiniz.
Sitenizdeki karşılaştırma tablolarının ve özet bloklarının bir AI tarayıcısına hangi biçimde ulaştığını kendi sayfalarınız üzerinde görmek isterseniz, Sheltron'un hızlı değerlendirme başvurusuyla başlayın; sunucu HTML'inden atıf verisine kadar AI görünürlük önceliklerinizi birlikte sıralayalım.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- HTML Tablolar AI Cevaplarında Nasıl Alıntılanır? Karşılaştırma Tablosu, Caption ve Tanım Listesi (dl)
- TL;DR
- WebAIM Million 2026'ya göre 1 milyon ana sayfadaki 948.225 tablonun yalnız %19'u geçerli veri tablosu işaretlemesine sahip. Eylül 2026 testimizde aynı veri yalnız semantik table içinde tablo olarak kaldı; div ızgarası 9 kopuk satıra, JavaScript tablosu tek başlık satırına indi, trafilatura caption metnini düşürdü. Sheltron blogundaki 249 tablonun hiçbirinde caption ya da scope yok.
- Ana Çıkarımlar (7)
- WebAIM Million 2026'da 1 milyon ana sayfadaki 948.225 tablonun yalnız %19'u (181.188) geçerli veri tablosu işaretlemesine sahipti.
- Eylül 2026 testinde aynı veri üç çıkarıcıda yalnız semantik table içinde tablo olarak kaldı; div ızgarası 9 kopuk satıra, JavaScript ile doldurulan tablo yalnız başlık satırına indi.
- Masaüstü sitelerin yalnız yaklaşık %1,6'sı caption kullanıyor (Web Almanac 2025) ve trafilatura caption metnini çıktıya taşımadı; tablonun konusu önceki cümlede de yazılmalı.
- Table Meets LLM (WSDM 2024): HTML işaretlemesiyle yedi görevde %65,43 ortalama başarı, ayraçlı düz metne göre %6,76 iyileşme.
- Vercel'in Aralık 2024 ölçümüne göre GPTBot, ClaudeBot ve PerplexityBot JavaScript render etmiyordu; tablo verisi sunucu HTML'inde olmalı.
- Sheltron'un data-llm-summary dl bloğu 235 yazının 233'ünde SSR HTML'de var ama trafilatura çıktısında dt-dd eşleşmesi düz listeye iniyor; dd tek başına anlamlı olmalı.
- Sheltron blogundaki 249 tablonun hiçbirinde caption ya da scope yok; 3+ tablolu 24 yazı 120 günde Copilot atfı almadı, ancak 23'ü atıf oranının zaten düşük olduğu Mayıs 2026 sonrası döneme ait.
- Kaynaklı Veriler
- %19 — WebAIM Million 2026'da 948.225 tablonun yalnız 181.188'i geçerli veri tablosu işaretlemesine sahip (WebAIM Million 2026, 2026)
- %1,6 — herhangi bir tabloda caption kullanan masaüstü sitelerin yaklaşık oranı (HTTP Archive Web Almanac 2025, Accessibility, 2026)
- %4,9 — role="presentation" ile düzen tablosu olarak işaretlenen mobil tabloların oranı (2024'te %4, 2022'de %1) (HTTP Archive Web Almanac 2025, Accessibility, 2026)
- %65,43 — GPT-3.5 ve GPT-4'te yedi tablo anlama görevinde HTML işaretlemesiyle ulaşılan en yüksek ortalama başarı (Sui vd., Table Meets LLM (WSDM 2024), 2024)
- %6,76 — HTML işaretlemesinin ayraçlı düz metin serileştirmesine göre sağladığı iyileşme (Sui vd., Table Meets LLM (WSDM 2024), 2024)
- %11,50 — ChatGPT tarayıcı isteklerinin JavaScript dosyası çekip çalıştırmayan payı (Claude'da %23,84) (Vercel, The rise of the AI crawler (Aralık 2024), 2024)
- %28,6 — Google ilk sonuçlarında en az bir liste bölümü içeren URL oranı; ChatGPT'nin alıntıladığı URL'lerde bu oran beşte dörde yakın (AirOps, Structuring Content for LLMs, 2025)
- %68,7 — ChatGPT'nin alıntıladığı URL'lerde sıralı başlık hiyerarşisi izleyenlerin oranı (AirOps, Structuring Content for LLMs, 2025)
- %40 — GEO yöntemleriyle üretken motor cevaplarında görünürlük artışının üst sınırı (Aggarwal vd., GEO: Generative Engine Optimization (KDD 2024), 2024)
- %49 — parçalara bağlam eklendiğinde başarısız getirmedeki azalma (yeniden sıralamayla %67) (Anthropic, Contextual Retrieval, 2024)
- 500 karakter — Unstructured'ın varsayılan parça sınırı; tablo her zaman ayrı parça olur, sınırı aşarsa bölünür (Unstructured, Chunking dokümantasyonu, 2026)
- 15 trilyon token — trafilatura ile HTML'den metne çevrilerek 96 Common Crawl anlık görüntüsünden derlenen FineWeb eğitim seti (Penedo vd., The FineWeb Datasets, 2024)
- 249 — Sheltron blogundaki sunucu HTML tablosu; hiçbirinde caption ya da scope yok (134/235 yazı, Eylül 2026 taraması) (Sheltron ölçümü — canlı blog SSR taraması, 2026)
- 233 — data-llm-summary dl özet bloğu sunucu HTML'inde bulunan yazı sayısı (235 yazı, Eylül 2026) (Sheltron ölçümü — canlı blog SSR taraması, 2026)
- 24 — 3 ve daha fazla tablolu, Clarity ile eşleşen yazı; 120 günlük Copilot penceresinde 0 atıf, 23'ü Mayıs 2026 sonrası dönemden (Sheltron ölçümü — tablo taraması ve Clarity Copilot atıf verisi, 2026)
- Arama Niyetleri
- html tablo ai alıntılama
- karşılaştırma tablosu ai overview
- tablo mu liste mi geo
- dl etiketi seo
- tablo görseli ai okuyamaz
- tablo başlığı caption seo
- javascript tablo chatgpt görünür mü
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz