AI Görünürlük Ölçümü Güvenilir mi? Örneklem, Tekrar ve Güven Aralığıyla Sinyali Gürültüden Ayırmak
AI görünürlük ölçümü tek çalıştırmayla güvenilir değildir. Cevapların neden değiştiğini, aramasız cevapların oranı nasıl bozduğunu, kaç tekrar gerektiğini ve güven aralığının nasıl hesaplandığını kendi 60 cevaplık baseline'ımızla anlatıyoruz.
💡Kısa Özet
SparkToro × Gumshoe'nun 2.961 çalıştırmalık 2026 çalışmasına göre iki AI cevabının aynı marka listesini verme olasılığı 100'de 1'in altında. Sheltron'un 9 Ağustos 2026 baseline'ında 60 cevabın 19'unda arama yapılmadı ve bu cevapların hiçbirinde atıf yoktu. Tek çalıştırmayla ölçülen %47'lik Claude oranının %95 Wilson aralığı %25-70; 15 gözlemde hata payı yaklaşık ±25 puan, 100 gözlemde ±10 puan.
Ana Çıkarımlar
- •SparkToro × Gumshoe'nun 2.961 çalıştırmalık 2026 çalışmasında iki AI cevabının aynı marka listesini verme olasılığı 100'de 1'in altında kaldı; araştırmacılar sorgu başına en az 60-100 tekrar öneriyor.
- •Temperature 0 cevapları sabitlemiyor: Thinking Machines Lab'in Qwen3-235B deneyinde temperature 0 ile aynı prompt'a üretilen 1.000 cevapta 80 farklı çıktı oluştu; en sık görülen cevap bile yalnızca 78 kez tekrarlandı.
- •Sheltron'un 9 Ağustos 2026 baseline'ında 60 cevabın 19'unda model web araması yapmadı; bu cevapların hiçbirinde atıf yoktu ve 21 atfın 21'i arama yapılan 41 cevaptan geldi.
- •Bir oranın %95 hata payı 15 gözlemde yaklaşık ±25 puan, 100 gözlemde ±10 puan; ±5 puan için yaklaşık 385 gözlem gerekiyor.
- •Tek çalıştırmayla ölçülen %47'lik Claude oranının %95 Wilson aralığı %25-70; Perplexity (13/15) ile Claude (7/15) farkı z testiyle anlamlı ama Fisher kesin testinde sınırda (p ≈ 0,05), Gemini (2/15) ile ChatGPT (1/15) farkı anlamlı değil.
- •Aynı 15 sorguyla iki ayrı Gemini ölçüm hattı, farklı atıf tanımlarıyla 2/15 ve 0/15 verdi; fark istatistiksel olarak ayırt edilemiyor ve yönlendirme adreslerini çözmeyen ayrıştırıcıdan, farklı model sürümlerinden (gemini-2.5-flash ve gemini-3.5-flash) ya da marka bahsini de isabet sayan geniş tanımdan kaynaklanıyor olabilir.
- •Bir raporu okurken 7 soru sorun: sorgu sayısı, tekrar sayısı, model sürümü, arama durumu, konum ve dil, atıf/bahis tanımı ve güven aralığı.
AI görünürlük ölçümü, tek bir çalıştırmayla yapıldığında güvenilir değildir. SparkToro ve Gumshoe'nun Ocak 2026'da yayımladığı 2.961 çalıştırmalık araştırmaya göre ChatGPT ya da Google'ın yapay zekası aynı soruya 100 kez cevap verdiğinde, herhangi iki cevabın aynı marka listesini içerme olasılığı 100'de 1'in altındadır. Bu yüzden bir rapordaki "%40 görünürlük" rakamının sinyal mi gürültü mü olduğu, kaç sorguyla, kaç tekrarla ve hangi ayarlarla üretildiği bilinmeden anlaşılamaz.
Aşağıda bir AI görünürlük yüzdesinin ne zaman güvenilir olduğunu adım adım ele alıyoruz: cevapların neden değiştiğini, web araması yapılmayan cevapların oranı nasıl bozduğunu, kaç tekrar gerektiğini ve güven aralığının nasıl hesaplandığını. Örnek olarak kendi ölçümümüzü kullanıyoruz. Sheltron'un 9 Ağustos 2026 tarihli LLM atıf baseline'ı, 15 sorgunun 4 platformda birer kez çalıştırılmasıyla elde edilen 60 cevaptan oluşuyordu ve 1,95 dolara mal olmuştu. O rakamları, aleyhimize olan kısımlarıyla birlikte güven aralığıyla yeniden okuyoruz. Hangi aracın neyi ölçtüğünü karşılaştıran ana rehber için AI görünürlük araçları karşılaştırmasına, metriğin formülü için AI share of voice metodolojisine bakabilirsiniz.
AI görünürlük ölçümü güvenilir mi? Tek çalıştırmada hayır, tekrarla evet
AI görünürlük ölçümü, sabit bir sorgu seti onlarca kez çalıştırılıp markanın göründüğü cevapların oranı güven aralığıyla raporlandığında güvenilir bir sinyal verir. Tek bir ekran görüntüsü, tek bir sohbet ya da sorgu başına tek çalıştırma ise aynı sorunun olası cevaplarından yalnızca birini gösterir.
SparkToro ve Gumshoe'nun çalışması bu ayrımı rakamla ortaya koyuyor. 600 gönüllü, 12 prompt'u ChatGPT, Claude ve Google AI Overview/AI Mode üzerinde toplam 2.961 kez çalıştırdı. İki cevabın aynı marka listesini vermesi 100'de 1'in altında kaldı; aynı markaların aynı sırayla gelmesi ise araştırmacıların ifadesiyle "daha çok 1.000 çalıştırmada bir" görülebilecek bir durum. Araştırmacıların pratik önerisi açık: sorgu başına genellikle en az 60-100 kez sorun ve sonuçların ortalamasını alın. Onlarca ila yüzlerce prompt'un tekrarlı çalıştırılmasından elde edilen görünürlük yüzdesini ise makul bir metrik olarak kabul ediyorlar.
Aynı çalışma, oynaklığın her markayı aynı ölçüde etkilemediğini de gösteriyor. Kategorisinde güçlü bir marka tekrarlı ölçümde neredeyse her seferinde görünüyor: City of Hope ilgili sorularda 71 cevabın 69'unda (%97), Smartsites 95 cevabın 85'inde yer aldı. Asıl sorun, orta düzeyde görünen markalarda ortaya çıkıyor. Bir oranın varyansı p(1−p) ile orantılıdır ve gerçek oran %50'ye yaklaştıkça en büyük değerine ulaşır. Görünürlüğü %30 ile %70 arasında olan bir markada tek ölçüm, gerçek oran hakkında en az bilgiyi verir.
Kısacası "AI görünürlük ölçümü güvenilir mi?" sorusunun cevabı ölçümün tasarımına bağlıdır. Tek bir AI cevabı ölçüm değil örnektir; görünürlük, aynı sorgu setinin tekrarlı çalıştırmalarında markanın göründüğü cevapların oranıdır. Bu tanımı kabul ettiğinizde soru "Rakam doğru mu?" olmaktan çıkar, "Rakamın hata payı ne kadar?" sorusuna dönüşür. Sonraki bölümler bu hata payını üreten kaynakları tek tek ele alıyor.
ChatGPT cevapları neden her seferinde değişiyor?
Dil modelleri cevabı her seferinde olasılıklara göre yeniden üretir. Temperature sıfıra çekilse bile sunucu tarafındaki koşullar sonucu değiştirebilir. Thinking Machines Lab'in açık bir modelle (Qwen3-235B) yaptığı deneyde temperature 0 ile aynı prompt'a üretilen 1.000 cevapta 80 farklı çıktı oluştu; en sık görülen cevap bile yalnızca 78 kez tekrarlandı.
Thinking Machines Lab'in Eylül 2025 tarihli analizi bu konudaki en açıklayıcı deneylerden biri. Deneyde aynı istek ("Tell me about Richard Feynman") temperature 0 ile, yani örneklemedeki rastlantı kapatılarak defalarca gönderildi; çıktılar yine de ayrıştı. Yazara göre temel neden, sunucu yüküne bağlı olarak toplu işlem (batch) boyutunun değişmesi ve hesaplama çekirdeklerinin sonucunun bu boyuta bağlı olması. Batch boyutundan bağımsız çalışan çekirdeklerle 1.000 cevabın tamamı aynı çıktı. Ancak bu, ölçümü yapan tarafın kontrol edebileceği bir ayar değil; sağlayıcının altyapısına bağlı.
Akademik tarafta Atil ve arkadaşlarının arXiv çalışması beş modeli sekiz görevde onar kez çalıştırdı. "Deterministik" kabul edilen ayarlarda bile doğrulukta %15'e kadar oynama, en iyi ve en kötü çalıştırma arasında ise %70'e varan fark gördü. OpenAI'ın seed parametresi rehberi de "Determinism is not guaranteed" diyor ve altyapı yapılandırmasını gösteren system_fingerprint değerinin yılda birkaç kez değişebileceğini belirtiyor.
Üstelik bazı modellerde bu ayarı yapmak mümkün değil. Anthropic'in API referansına göre Eylül 2026 itibarıyla Claude Opus 4.6'dan sonra çıkan modeller temperature ayarını desteklemiyor; yalnız geriye dönük uyumluluk için 1,0 değeri kabul ediliyor. DataForSEO'nun ChatGPT cevap API'sinde temperature varsayılan olarak 0,94 ve akıl yürütme modellerinde desteklenmiyor. 9 Ağustos 2026 ölçümümüzde ChatGPT tarafında kullanılan o4-mini de bir akıl yürütme modeli.
Buradan çıkan sonuç net: Oynaklığı ayarlarla sıfırlamak mümkün değil, yalnızca ölçülebilir. Share of voice metodolojisi yazımızda "tek çekim ölçüm değildir" ilkesini ortaya koymuştuk. Bu kaynaklar o ilkenin nicel karşılığını veriyor: temperature 0 bile cevabı sabitleyemiyorsa, tek cevaba dayanan bir rapor gerçek orandan çok o anki tesadüfü yansıtır.
Web araması yapılmayan cevapta kaynak gösterilmez
Model soruyu web'e gitmeden, yalnız eğitim verisiyle cevaplarsa kaynak listesi oluşmaz ve atıf sayılamaz. Sheltron'un 9 Ağustos 2026 baseline'ında 60 cevabın 19'unda model arama yapmadı. Bu 19 cevabın hiçbirinde atıf yoktu; 21 atfın 21'i, arama yapılan 41 cevaptan geldi. Yani aramasız cevaplar oranı içerikten bağımsız olarak aşağı çeker.
Aramanın yapılıp yapılmayacağına çoğu durumda model karar veriyor. Google'ın Gemini grounding dokümanı akışı şöyle anlatıyor: model istemi analiz ediyor ve Google aramasının cevabı iyileştirip iyileştirmeyeceğine karar veriyor; gerekirse bir ya da birden fazla arama sorgusu üretiyor. Anthropic'in web search aracı da Claude'un ne zaman arayacağına prompt'a göre karar verdiğini yazıyor. Güncel olaylar, fiyatlar ve değişmiş olabilecek kurum ya da ürün bilgileri için arama yapılıyor, yerleşik bilgiler ve yaratıcı yazım için yapılmıyor. Dokümana göre basit sorularda genellikle 1-3, karşılaştırmalı sorularda 10 ya da daha fazla arama görülebiliyor. OpenAI'ın web search rehberine göre tool_choice: "auto" ayarında arama isteğe bağlı; aramanın mutlaka çalışması için "required" seçilmesi gerekiyor.
Baseline'da ChatGPT, Gemini ve Claude için web araması açıkça istendi; Perplexity'de (sonar) ayrı bir arama bayrağı gönderilmedi; bu platformda 15 cevabın 15'inde arama yapıldı. Diğer üç platformda ise tablo, aramanın istendiği hâlde her cevapta gerçekleşmediğini gösteriyor:
| Platform (model) | Arama yapılan cevap | Aramasız cevap | Atıf (kaynak listesinde sheltron.com.tr) | Aramasız cevapta atıf |
|---|---|---|---|---|
| ChatGPT (o4-mini-2025-04-16) | 4/15 | 11 | 1 | 0 |
| Gemini (gemini-3.5-flash, DataForSEO) | 9/15 | 6 | 0* | 0 |
| Claude (claude-sonnet-5) | 13/15 | 2 | 7 | 0 |
| Perplexity (sonar) | 15/15 | 0 | 13 | — |
| Toplam | 41/60 | 19 | 21 | 0 |
*Gemini satırındaki sıfır, aşağıda ölçüm hattı bölümünde anlatılan yönlendirme adresi sorunundan kısmen etkileniyor.
Tablo, ChatGPT'deki 1/15'lik (%7) atıf oranının da farklı okunması gerektiğini gösteriyor. 15 cevabın 11'inde arama hiç yapılmadı; arama yapılan 4 cevaptan 1'inde kaynak olarak göründük. Dolayısıyla %7, "arama yapıldığında görünmüyoruz" demek değildir. Ancak 4 gözlemle arama yapılan cevaplardaki oran hakkında da güvenilir bir şey söylenemez.
Pratik ders şu: Her cevap için "web araması istendi" ve "web araması yapıldı" bilgisini ayrı alanlarda kaydedin ve iki rakam raporlayın: aramanın tetiklenme oranı ve arama yapılan cevaplarda atıf oranı. Tek bir karışık oran, markanın içeriğiyle ilgisi olmayan bir model kararını görünürlük kaybı gibi gösterir. Platformların arama davranışındaki farklar için çok platformlu AI atıf karşılaştırmamıza bakabilirsiniz.
Konum, dil ve prompt yazımı aynı soruyu farklı bir ölçüme çevirir
OpenAI, Anthropic ve Google'ın arama araçlarının hepsi konumu bir girdi olarak kabul eder. Ölçüm aracı konumu, dili ve prompt metnini sabitlemiyorsa iki çalıştırma farklı kullanıcıları ölçmüş olur. SparkToro'nun analizinde aynı niyetle insanların yazdığı 142 prompt'un ortalama anlamsal benzerliği yalnızca 0,081 çıktı.
Konum parametreleri dokümanlarda açıkça tanımlı. OpenAI'ın web search aracı user_location altında ülke, şehir, bölge ve saat dilimi alıyor. Claude'un aracı da yaklaşık konum bilgisi kabul ediyor. Google'ın Vertex AI dokümanında retrievalConfig.latLng ile enlem ve boylam verilebiliyor. DataForSEO'nun API'si ise ülke kodu ve şehir parametreleri sunuyor. Claude için Türkiye'ye sabitlenmiş bir tanım, dokümandaki biçimiyle şöyle görünüyor:
{ "type": "web_search_20250305", "name": "web_search", "max_uses": 5,
  "user_location": { "type": "approximate", "city": "Istanbul", "country": "TR", "timezone": "Europe/Istanbul" } }
Bir not düşelim: Tüketici arayüzlerinde hesap geçmişinin ve hafızanın cevaplara etkisini belgeleyen birincil bir kaynağa Eylül 2026 itibarıyla erişemedik. Bu nedenle burada yalnızca API düzeyinde belgelenmiş parametreleri sayıyoruz. Kişiselleştirmenin etkisi hakkında rakam vermiyoruz.
İkinci değişken prompt'un kendisi. 0,081'lik benzerlik, kullanıcıların aynı ihtiyacı birbirinden çok farklı sözcüklerle dile getirdiğini gösteriyor. Tek bir "doğru prompt" yoktur; ölçülen görünürlük, seçilen prompt setinin bir fonksiyonudur. Google da Search Central'daki AI özellikleri sayfasında AI Mode ve AI Overviews'un farklı modeller ve teknikler kullanabileceğini, bu yüzden gösterdikleri cevapların ve linklerin değişeceğini belirtiyor. Aynı sayfa, bir soruyu alt konulara bölüp birden fazla ilişkili arama yapan "query fan-out" yöntemini de anlatıyor. Yüzeyler arasındaki farkları AI Mode, AI Overviews ve ChatGPT Search katmanları yazısında ayrıntılı anlattık.
Türkçe sorgular için bir katman daha var: Model Türkçe soruya hangi dildeki kaynaklarla cevap veriyor? Bu dağılımı Türkçe sorgularda LLM'lerin hangi kaynakları gösterdiğini incelediğimiz yazıda ele aldık. Ölçüm tasarımı için öneri basit: Prompt listesini sürüm numarasıyla sabitleyin, konum ve dili her çalıştırmada aynı tutun. Prompt çeşitliliğinin etkisini görmek istiyorsanız aynı niyet için birkaç farklı yazımı ayrı bir katman olarak raporlayın.
Kaç tekrar yeterli? 15 gözlemde hata payı ±25 puan
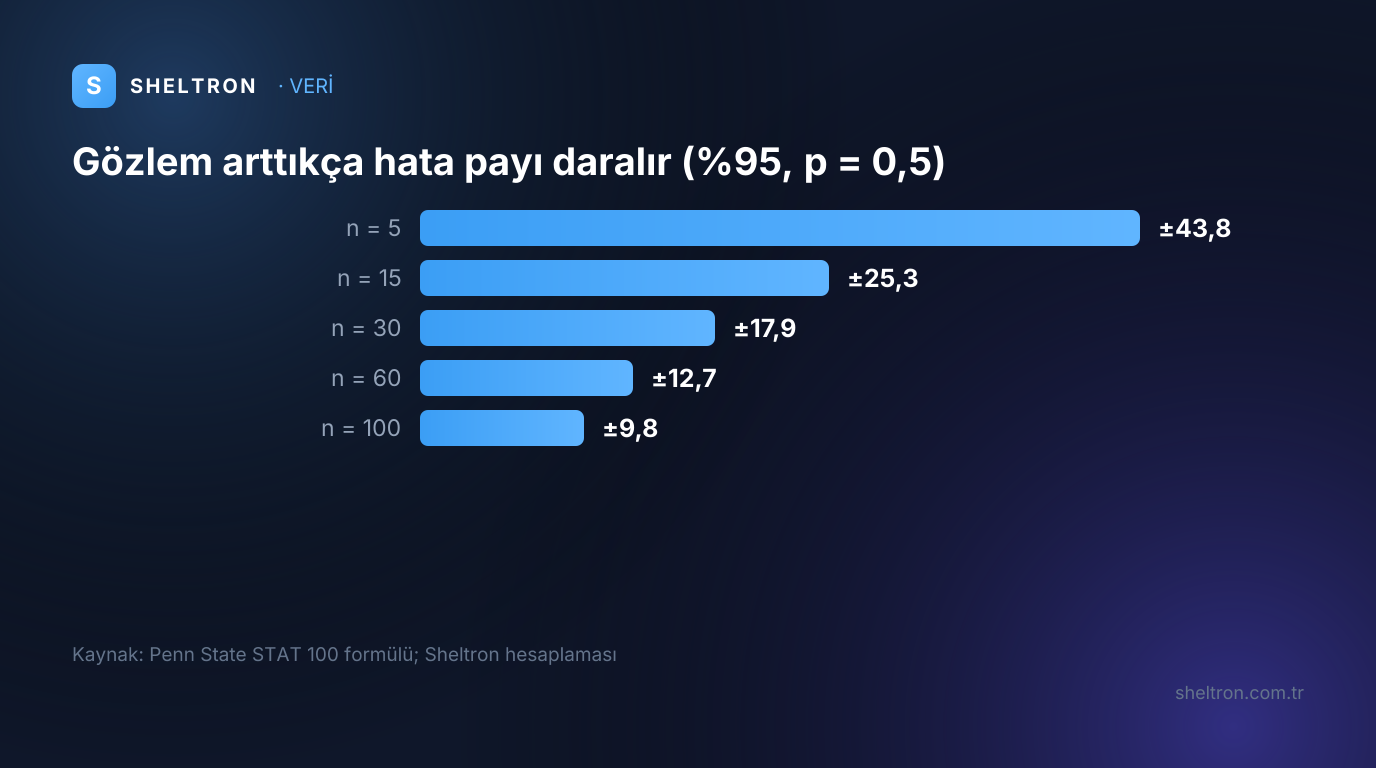
Bir oranın hata payı gözlem sayısının kareköküyle küçülür. %95 güven düzeyinde 15 gözlemde hata payı yaklaşık ±25 puan, 100 gözlemde yaklaşık ±10 puandır. SparkToro araştırmacıları anlamlı bir görünürlük yüzdesi için sorgu başına en az 60-100 tekrar öneriyor. Bizim hesabımıza göre bu öneri ±10-13 puanlık bir banda karşılık geliyor.
Hesabın temeli istatistiğin giriş derslerinde yer alıyor. Penn State STAT 100'ün örneklem büyüklüğü dersi, bir oranın hata payını kabaca 1/√n olarak veriyor: n = 1.000 gözlemde hata payı yaklaşık %3'tür ve örneklemi dört katına çıkarmak hata payını yarıya indirir. Aynı dersin güven aralığı bölümü daha kesin formülü veriyor: oran ± z*·√(p(1−p)/n). Aşağıdaki tabloda en kötü durumu, yani gerçek oranın %50 olduğu durumu esas aldık:
| Gözlem sayısı (n) | Kaba hata payı (1/√n) | %95 hata payı (p = 0,5) |
|---|---|---|
| 5 (ücretsiz spot-check boyutu) | %44,7 | ±%43,8 |
| 15 (9 Ağustos 2026 baseline'ımız) | %25,8 | ±%25,3 |
| 30 | %18,3 | ±%17,9 |
| 60 | %12,9 | ±%12,7 |
| 100 | %10,0 | ±%9,8 |
| 400 | %5,0 | ±%4,9 |
Tabloyu tersinden okursak, ±10 puanlık hata payı için yaklaşık 97, ±5 puan için yaklaşık 385 gözlem gerekiyor. SparkToro'nun "en az 60-100 tekrar" önerisi bu hesapla tutarlı. Ancak ±10-13 puan eşleştirmesi bizim yorumumuz; araştırmacıların kendi iddiası değil.
Burada iki uyarı önemli. Birincisi, aynı sorgunun tekrarları birbirinden tamamen bağımsız değildir. Örneğin 15 sorgunun dörder kez çalıştırılmasıyla elde edilen 60 gözlem, 60 farklı sorgunun sağlayacağı bilgiyi sağlamaz. Bu nedenle raporda hem sorgu sayısı hem sorgu başına tekrar sayısı ayrı ayrı yazılmalı. Buradaki hesap, tek bir sorgudaki oranın tekrarla ne kadar daraldığını gösterir; prompt setinin kaç sorgudan oluşacağı (setin genişliği) ise ölçmek istediğiniz konu evrenine bağlı ayrı bir karardır ve burada bir adet önermiyoruz. İkincisi, Penn State'in de vurguladığı gibi hata payı yanlılık hakkında bilgi vermez. Prompt seti yalnızca markanın güçlü olduğu sorulardan oluşuyorsa, 1.000 tekrar da yanıltıcı sonucu yalnızca daha kesin biçimde verir.
Rakip kıyaslarında da aynı mantık geçerli. %35 ile %45 arasındaki 10 puanlık fark, iki oran da 15'er gözlemle ölçülmüşse gürültünün içinde kalır. İki oranın farkının anlamlı olup olmadığını sınamadan rakip share of voice analizi yapmak, yanlış rakibe odaklanmaya yol açabilir.
Kendi baseline'ımızı güven aralığıyla okuyunca: %47 aslında %25-70
9 Ağustos 2026'da Claude'da 15 sorgunun 7'sinde kaynak olarak gösterildik (%47). Ancak sorgu başına tek çalıştırmayla elde edilen 15 gözlemde bu oranın %95 Wilson aralığı yaklaşık %25 ile %70 arasında. Perplexity ile Claude arasındaki fark sınırda anlamlı; Gemini ile ChatGPT arasındaki fark ise gürültüden ayırt edilemiyor.
Aralıkları, NIST/SEMATECH istatistik el kitabının oranlar için verdiği Wilson yöntemiyle hesapladık. El kitabı bu yöntemin alt sınırının negatif olamayacağını ve yöntemin Agresti ile Coull tarafından hemen her n ve p kombinasyonu için önerildiğini belirtiyor. Küçük örneklemde aralığın ne kadar genişlediğini el kitabının kesin (binom) yöntemle hesapladığı örnek de gösteriyor: 20 birimde 4 kusurlu (%20) için %90 güven aralığı 0,071 ile 0,400 arası. Hesap birkaç satırlık bir fonksiyondur:
// k: markanın kaynak gösterildiği cevap sayısı, n: toplam cevap
function wilson(k, n, z = 1.96) {
  const p = k / n, d = 1 + z * z / n;
  const c = p + z * z / (2 * n);
  const m = z * Math.sqrt(p * (1 - p) / n + z * z / (4 * n * n));
  return [(c - m) / d, (c + m) / d];
}
wilson(7, 15); // [0.248, 0.699]
Aynı hesabı 9 Ağustos 2026 ölçümündeki tüm platformlara ve Google AI Overviews taramasına uyguladık:
| Ölçüm | Nokta tahmini | %95 Wilson aralığı | Nasıl okunmalı? |
|---|---|---|---|
| Perplexity, 13/15 | %86,7 | %62,1 – %96,3 | Yüksek olduğu güvenle söylenebilir |
| Claude, 7/15 | %46,7 | %24,8 – %69,9 | Orta; aralık çok geniş |
| Gemini, kendi ölçüm hattımız, 2/15 | %13,3 | %3,7 – %37,9 | Düşük olabilir, kesin değil; atıf tanımı daha geniş (bahis dahil) |
| Gemini, DataForSEO, 0/15 | %0 | %0 – %20,4 | Gerçek oran sıfır olmayabilir; ayrıştırma sorunu da var |
| ChatGPT, 1/15 | %6,7 | %1,2 – %29,8 | 11 cevapta arama yapılmadı |
| AI Overviews, 6/16 (9 Ağustos 2026) | %37,5 | %18,5 – %61,4 | AI Overview çıkan 16 sorgu esas alındı |
| AI Overviews, 0/10 (23 Temmuz 2026) | %0 | %0 – %27,8 | Payda farklı; doğrudan kıyaslanamaz |
| Dış örnek: City of Hope, 69/71 | %97,2 | %90,3 – %99,2 | 71 gözlem aralığı daraltıyor |
İki oranın farkını sınadığımızda Perplexity (13/15) ile Claude (7/15) farkı z testiyle %5 düzeyinde anlamlı çıktı (z ≈ 2,32), ama küçük örneklem için önerilen Fisher kesin testinde sınırda kalıyor (iki yönlü p ≈ 0,05). Farkın yönü büyük olasılıkla gerçek; büyüklüğü için daha fazla tekrar gerekir. Gemini (2/15) ile ChatGPT (1/15) arasındaki fark ise anlamlı değil (z ≈ 0,61); üstelik Gemini'deki 2/15, bir sonraki bölümde anlatılan daha geniş bir atıf tanımıyla üretildi. Gemini'deki iki ölçüm hattının 2/15 ve 0/15 sonuçları da birbirinden ayırt edilemiyor (z ≈ 1,46). Yani "Perplexity'de Claude'dan daha sık kaynak gösteriliyoruz" demek için veri güçlü bir işaret veriyor ama kesin değil; "Gemini'de ChatGPT'den iyiyiz" ise hiç diyemeyiz.
Bu okuma bizim aleyhimize bir sonucu da açığa çıkarıyor. Sheltron'un iç raporunda Gemini için ölçülen %13, 30 günlük hedef eşiğine ulaşılmış olarak işaretlenmişti. Güven aralığıyla bakıldığında bu rakam, gerçek oranın %4 ile %38 arasında olduğu her durumla uyumlu. Üstelik bu %13, cevap metnindeki marka bahsini de isabet sayan geniş bir tanımla üretilmişti; yalnız kaynak listesini sayan bir tanımla aynı rakamın çıkıp çıkmayacağı kayıtlarımızdan anlaşılmıyor. Tek bir ölçümle eşiğe ulaşıldığını söylemek mümkün değil; bunun için ölçümün haftalar boyunca tekrarlanması gerekiyor.
Ölçüm hattının kendisi de hata üretir: yönlendirme adresleri, atıf tanımı ve payda
Görünürlük rakamını yalnız model değil, cevabı ayrıştıran yazılım ve atıf tanımı da değiştirir. Gemini'nin grounding kaynakları yönlendirme adresiyle geldiği için alan adına bakan bir ayrıştırıcı atıfları kaçırır. Aynı ölçüm döneminde ve aynı 15 sorguyla kendi Gemini hattımız (gemini-2.5-flash) 2 isabet, üçüncü taraf API üzerinden gemini-3.5-flash ile yaptığımız ölçüm ise 0 atıf verdi; ancak iki hat aynı şeyi saymıyordu.
DataForSEO üzerinden alınan 15 Gemini cevabının 9'unda kaynakların tamamı vertexaisearch.cloud.google.com alan adındaki yönlendirme adresleriydi; 6 cevapta ise hiç kaynak yoktu. Bu adresler takip edilip gerçek hedefe çözülmezse her kaynak Google altyapısı gibi görünür ve hiçbir atıf yakalanmaz. Google Cloud'un Vertex AI grounding dokümanındaki örnek yanıtta her kaynağın uri alanının yanında title ve domain alanları da bulunuyor; ayrıştırıcı bu alanlara ya da çözülmüş adrese bakmalı. Sheltron'un ücretsiz AI görünürlük spot-check aracı yönlendirmeleri paralel HEAD istekleriyle çözüyor ve başlıkta marka ya da alan adı eşleşmesini de kontrol ediyor. Önceki bölümde gördüğümüz gibi 2/15 ile 0/15 istatistiksel olarak ayırt edilemiyor. İki rakam arasındaki farkın üç olası nedeni var: (1) kendi hattımız yönlendirmeleri çözüyor, baseline'daki DataForSEO hattı çözmüyor; (2) model sürümleri farklı (gemini-2.5-flash ve gemini-3.5-flash); (3) kendi hattımız cevap metnindeki marka bahsini ve partner alan adını da isabet sayıyor, DataForSEO baseline'ı ise yalnız kaynak listesindeki sheltron.com.tr'yi sayıyor. 2 isabetin hangi türden olduğu kayıtlarımızda ayrışmıyor. Bu yüzden ne 0/15'i "Gemini bizi göstermiyor", ne 2/15'i "Gemini'de %13 kaynak gösteriliyoruz" diye okuyoruz.
"Atıf" tanımı da rakamı değiştirir. OpenAI'ın web search aracında satır içi atıflar yalnızca en ilgili kaynakları gösterir; tam liste ayrı bir sources alanında döner. Bir araç yalnız satır içi atıfları sayıyorsa, kaynak listesini sayan bir araçtan daha düşük oran bulur. Atıf ile bahis de farklı metriklerdir: Perplexity'deki 13 atfa karşın marka adı 15 cevabın yalnızca birinin metninde geçti. Bahsi haftalık izlemek için Marka Takibi aracı ayrı bir gösterge sunuyor.
Payda ve model sürümü de sessizce değişebilir. Google AI Overviews taramamızda 23 Temmuz 2026'da AI Overview çıkan 10 sorgunun hiçbirinde kaynak değildik, 9 Ağustos 2026'da ise 16 sorgunun 6'sında kaynaktık. Payda değiştiği için iki oran doğrudan kıyaslanamaz. OpenAI'ın system_fingerprint değerinin yılda birkaç kez değişebilmesi de model tarafında benzer bir kırılma yaratır. Bu yüzden baseline'da her cevabın yanında model adı da kayıtlı; model değiştiğinde trend çizgisine kırılma notu düşülmeli.
Oynaklığın altı kaynağını ve her biri için kontrol yolunu şöyle özetleyebiliriz:
| Varyans kaynağı | Rakamı nasıl değiştirir? | Nasıl kontrol edilir? |
|---|---|---|
| Örnekleme ve çıkarım belirsizliği | Aynı prompt'a farklı cevap gelir | Sorgu başına tekrar ve güven aralığı |
| Arama tetikleme kararı | Aramasız cevapta atıf olmaz | "Arama yapıldı" alanını kaydetmek; OpenAI'da tool_choice: "required" |
| Konum ve dil | Farklı kaynak seti gelir | user_location, ülke kodu ve dil sabitlenir |
| Prompt seti | Ölçülen evren değişir | Sürümlü, sabit prompt listesi |
| Ayrıştırıcı ve atıf tanımı | Atıflar kaçırılır ya da farklı sayılır | Yönlendirmeleri çözmek; tanımı raporda yazmak |
| Model sürümü ve payda | Trendde kırılma oluşur | Model adı, tarih ve payda her satırda |
Kayıt için önerdiğimiz satır şeması şu alanlardan oluşuyor: tarih, platform, model ve sürüm, sorgu, tekrar numarası, konum, arama istendi mi, arama yapıldı mı, bahis, atıf ve kaynak sayısı. "Arama yapıldı" alanı ayrı tutulmazsa, aramasız cevaplar görünürlüğü sistematik olarak düşürür ve bu düşüş içerikten değil ölçümden kaynaklanır.
Bir AI görünürlük raporunu okurken sorulacak 7 soru
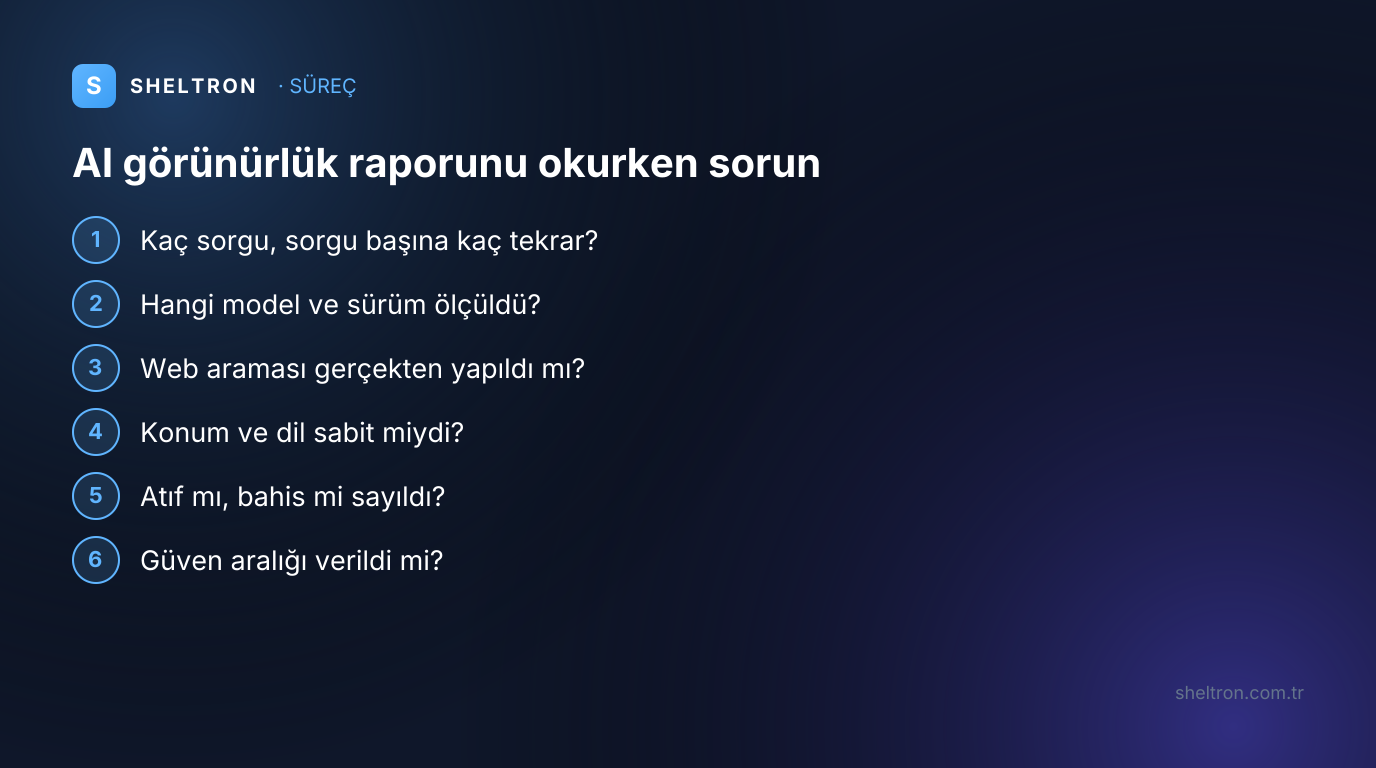
Bir rapordaki görünürlük yüzdesine güvenmeden önce yedi şey sorun: kaç sorgu, sorgu başına kaç tekrar, hangi model sürümü, arama zorunlu muydu, konum ve dil sabit miydi, atıf mı bahis mi sayıldı ve güven aralığı verildi mi. "AI'da 3. sıradasınız" gibi tek bir sıra numarası veren raporlara şüpheyle yaklaşın.
- Kaç sorgu kullanıldı? Görünürlük, seçilen prompt setinin bir fonksiyonudur. Birkaç sorguluk bir set markanın genel durumunu değil, yalnızca o sorulardaki durumunu gösterir.
- Sorgu başına kaç tekrar yapıldı? Tek çalıştırmalık 15 gözlemde hata payı ±25 puana yaklaşır. SparkToro araştırmacıları sorgu başına en az 60-100 tekrar öneriyor.
- Hangi model ve sürüm ölçüldü? Model adı ve tarihi yazmayan bir trend grafiği, model değişimini markanın performans değişimi gibi gösterebilir.
- Web araması zorunlu muydu ve gerçekten yapıldı mı? Aramasız cevapta atıf olmaz. Rapor, aramanın kaç cevapta tetiklendiğini ayrıca göstermeli.
- Konum ve dil sabit miydi? Türkiye'deki bir kullanıcıyı ölçmek istiyorsanız konum parametresi Türkiye'ye, dil Türkçe'ye sabitlenmiş olmalı.
- Atıf mı, bahis mi sayıldı? Kaynak listesinde yer almak ile cevap metninde adı geçmek farklı metriklerdir. İkisini tek rakamda toplayan rapor yorumlanamaz.
- Güven aralığı verildi mi? Aralık verilmeyen iki oran arasındaki fark, sinyal mi gürültü mü, bilinemez.
Sıra numarası konusundaki uyarı sert ama rakamlarla tutarlı. SparkToro'dan Rand Fishkin, AI'da "sıralama pozisyonu" veren her aracın "baloney", yani zırva olduğunu yazıyor. Aynı markaların aynı sırayla gelmesi yaklaşık 1.000 çalıştırmada bir görüldüğüne göre, tek bir sıra numarası ölçülebilir bir büyüklük değildir. Rapor okuma ve KPI seçimi için pazarlama yöneticisinin AI search rapor okuma rehberine bakabilirsiniz.
"Ahrefs'in ya da başka bir aracın yapay zeka görünürlük verisi yeterli mi?" sorusunun cevabı aracın adına değil, bu yedi sorunun cevabına bağlıdır. Ticari araçların metodoloji dokümanlarını bu yazı kapsamında incelemedik; bu nedenle araç bazında hüküm vermiyoruz. Tedarikçinize bu yedi soruyu yazılı olarak sormanız, bir demo ekranından daha çok bilgi verir. Ölçüm çerçevesinin bütününü GEO ölçüm rehberimizde, GEO araştırmalarının daha geniş arka planını ise The GEO Authority yayınlarında bulabilirsiniz.
Ücretsiz araçları da bu çerçevede konumlamak gerekir. Sheltron'un spot-check aracı 5 sorguyu tek sefer çalıştırır; n = 5'te hata payı ±44 puana yaklaştığı için bu bir teşhis aracıdır. "Hiç görünüyor muyuz?" sorusuna ilk cevabı verir, trend göstermez. Nasıl kullanılacağını spot-check iş akışı yazısında anlattık. Trend için aynı sorguların düzenli tekrarlanması gerekir; haftalık kontrol her hafta yeni gözlem ekler ve aralık zamanla daralır. İçerik değişikliklerinin atfa etkisini test ederken de aynı anlamlılık mantığı geçerlidir: GEO A/B testi yazımız bu tasarımı ele alıyor.
Elinizdeki görünürlük raporunun kaç sorgu ve kaç tekrarla üretildiğini bilmiyorsanız, önce ölçümün kendisini sorgulayın. Hızlı değerlendirme sayfasından sitenizin ChatGPT ve Gemini'deki görünümünü Sheltron ekibine test ettirebilir, sonucu elinizdeki raporla yan yana koyabilirsiniz. Ölçüm, arama yapılan cevaplarda görünmediğinizi gösteriyorsa sıradaki adım ürün ve içerik verisini makine tarafından okunabilir hâle getirmektir; e-ticaret kataloğu için GEO Builder bu işin altyapısını sunuyor.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- AI Görünürlük Ölçümü Güvenilir mi? Örneklem, Tekrar ve Güven Aralığıyla Sinyali Gürültüden Ayırmak
- TL;DR
- SparkToro × Gumshoe'nun 2.961 çalıştırmalık 2026 çalışmasına göre iki AI cevabının aynı marka listesini verme olasılığı 100'de 1'in altında. Sheltron'un 9 Ağustos 2026 baseline'ında 60 cevabın 19'unda arama yapılmadı ve bu cevapların hiçbirinde atıf yoktu. Tek çalıştırmayla ölçülen %47'lik Claude oranının %95 Wilson aralığı %25-70; 15 gözlemde hata payı yaklaşık ±25 puan, 100 gözlemde ±10 puan.
- Ana Çıkarımlar (7)
- SparkToro × Gumshoe'nun 2.961 çalıştırmalık 2026 çalışmasında iki AI cevabının aynı marka listesini verme olasılığı 100'de 1'in altında kaldı; araştırmacılar sorgu başına en az 60-100 tekrar öneriyor.
- Temperature 0 cevapları sabitlemiyor: Thinking Machines Lab'in Qwen3-235B deneyinde temperature 0 ile aynı prompt'a üretilen 1.000 cevapta 80 farklı çıktı oluştu; en sık görülen cevap bile yalnızca 78 kez tekrarlandı.
- Sheltron'un 9 Ağustos 2026 baseline'ında 60 cevabın 19'unda model web araması yapmadı; bu cevapların hiçbirinde atıf yoktu ve 21 atfın 21'i arama yapılan 41 cevaptan geldi.
- Bir oranın %95 hata payı 15 gözlemde yaklaşık ±25 puan, 100 gözlemde ±10 puan; ±5 puan için yaklaşık 385 gözlem gerekiyor.
- Tek çalıştırmayla ölçülen %47'lik Claude oranının %95 Wilson aralığı %25-70; Perplexity (13/15) ile Claude (7/15) farkı z testiyle anlamlı ama Fisher kesin testinde sınırda (p ≈ 0,05), Gemini (2/15) ile ChatGPT (1/15) farkı anlamlı değil.
- Aynı 15 sorguyla iki ayrı Gemini ölçüm hattı, farklı atıf tanımlarıyla 2/15 ve 0/15 verdi; fark istatistiksel olarak ayırt edilemiyor ve yönlendirme adreslerini çözmeyen ayrıştırıcıdan, farklı model sürümlerinden (gemini-2.5-flash ve gemini-3.5-flash) ya da marka bahsini de isabet sayan geniş tanımdan kaynaklanıyor olabilir.
- Bir raporu okurken 7 soru sorun: sorgu sayısı, tekrar sayısı, model sürümü, arama durumu, konum ve dil, atıf/bahis tanımı ve güven aralığı.
- Kaynaklı Veriler
- 100'de 1'in altında — ChatGPT ya da Google'ın yapay zekası aynı soruya 100 kez cevap verdiğinde iki cevabın aynı marka listesini içerme olasılığı (SparkToro × Gumshoe, 2026)
- 2.961 çalıştırma — 600 gönüllünün 12 prompt'u ChatGPT, Claude ve Google AI Overview/AI Mode üzerinde çalıştırdığı çalışmanın örneklemi (SparkToro × Gumshoe, 2026)
- 60-100 tekrar — anlamlı bir görünürlük yüzdesi için araştırmacıların sorgu başına önerdiği asgari tekrar sayısı (SparkToro × Gumshoe, 2026)
- 0,081 — aynı niyetle insanların yazdığı 142 prompt'un ortalama anlamsal benzerliği (SparkToro × Gumshoe, 2026)
- 69/71 (%97) — City of Hope'un tekrarlı ölçümde yer aldığı cevap oranı; güçlü markalarda oynaklık düşük (SparkToro × Gumshoe, 2026)
- 80 benzersiz tamamlama / en sık cevap 78 kez — temperature 0'da aynı prompt'a üretilen 1.000 cevap (Thinking Machines Lab (Horace He), 2025)
- %15'e kadar — 'deterministik' ayarlarda 10 çalıştırma arasında görülen doğruluk oynaması (Atil ve ark., arXiv 2408.04667, 2025)
- 1-3 arama — Claude'un basit sorularda tipik olarak yaptığı web araması sayısı; karşılaştırmalı sorularda 10 ya da daha fazla (Anthropic, Web search tool dokümanı, 2026)
- 0,94 — DataForSEO ChatGPT cevap API'sinde varsayılan temperature; akıl yürütme modellerinde desteklenmiyor (DataForSEO Docs, 2026)
- 1.000 gözlemde yaklaşık %3 — bir oranın kaba hata payı (1/√n); örneklemi dört katına çıkarmak hata payını yarıya indirir (Penn State STAT 100, Lesson 2, 2026)
- 19/60 — 9 Ağustos 2026 LLM baseline'ında web araması yapılmayan cevap sayısı; bu cevapların hiçbirinde atıf yok (Sheltron LLM atıf baseline'ı (9 Ağustos 2026) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- 21 atfın 21'i — baseline'daki tüm atıfların arama yapılan 41 cevaptan gelmesi (Sheltron LLM atıf baseline'ı (9 Ağustos 2026) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- 4/15 — web araması istendiği hâlde ChatGPT (o4-mini) cevaplarından gerçekten arama yapılanların sayısı (Sheltron LLM atıf baseline'ı (9 Ağustos 2026) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- 13/15 (%86,7) — Perplexity cevaplarında sheltron.com.tr'nin kaynak olarak gösterildiği cevap sayısı (Sheltron LLM atıf baseline'ı (9 Ağustos 2026) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- %24,8 – %69,9 — Claude'daki 7/15 (%47) atıf oranının Wilson yöntemiyle hesaplanan %95 güven aralığı (Sheltron hesaplaması (NIST/SEMATECH Wilson formülü) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- 2/15 ve 0/15 — aynı ölçüm döneminde iki ayrı Gemini ölçüm hattının farklı atıf tanımlarıyla verdiği sonuçlar (2/15 cevap metnindeki marka bahsini de sayıyor) (Sheltron SEO-GEO Playbook (9 Ağustos 2026) — yöntem ve ham rakamlar bu yazının H2-3/H2-6 bölümlerinde, 2026)
- Arama Niyetleri
- ai görünürlük ölçümü güvenilir mi
- llm alıntılanma takibi güvenilirliği
- ai görünürlük izleme araçları güvenilir mi
- chatgpt cevapları neden her seferinde değişiyor
- ai görünürlük ölçümünde örneklem sayısı
- ahrefs yapay zeka görünürlüğü yeterli mi
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz