AI Botları JavaScript Okuyabilir mi? 432 Türk Sitesinin Ham HTML Ölçümü
AI tarayıcılarının JavaScript çalıştırıp çalıştırmadığını birincil kaynaklarla açıklayan ve Türkiye'nin en çok ziyaret edilen 432 sitesinin ham HTML'inde metin, H1 ve JSON-LD'nin ne kadarının JavaScript olmadan göründüğünü ölçen Eylül 2026 veri raporu.
💡Kısa Özet
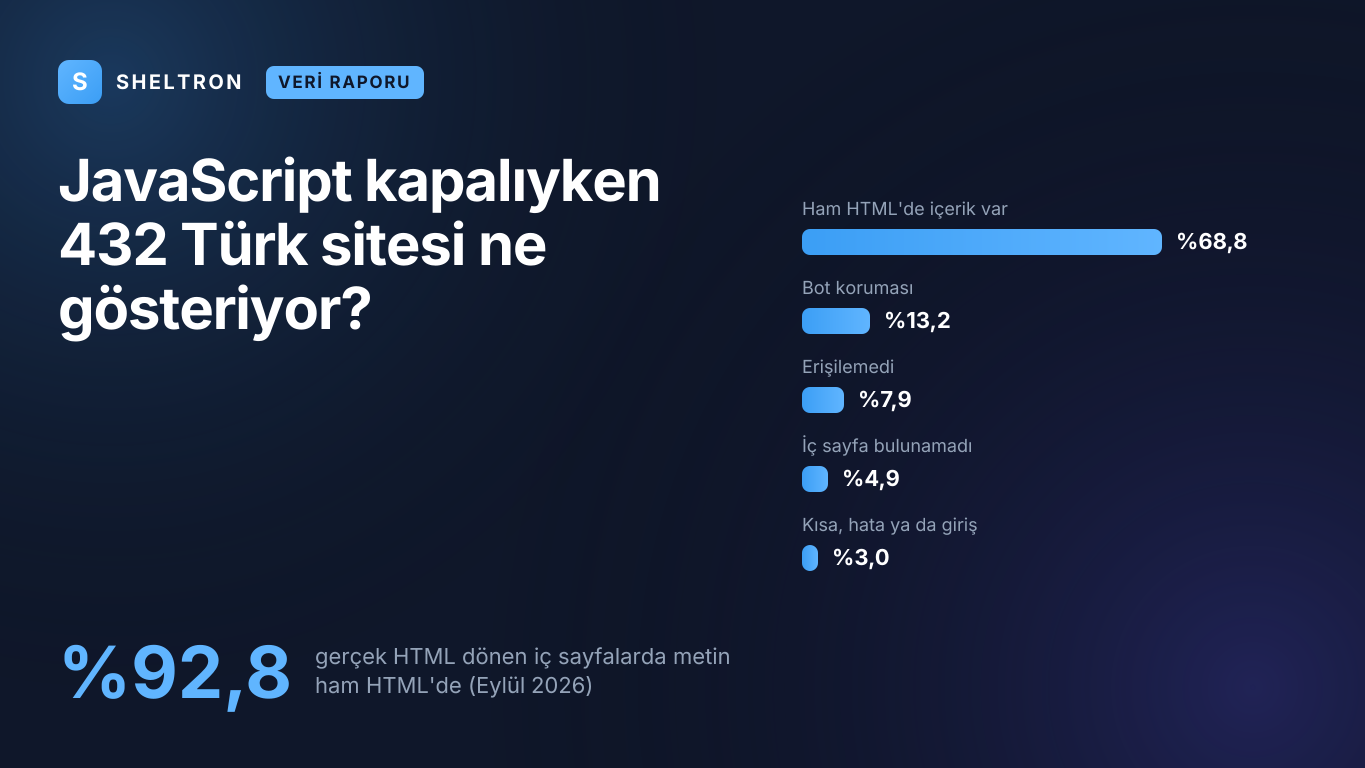
Vercel'in Aralık 2024 analizine göre GPTBot, ClaudeBot ve PerplexityBot JavaScript çalıştırmıyor. Sheltron, Eylül 2026'da 432 popüler Türk sitesini JavaScript kapalıyken ölçtü: gerçek HTML dönen iç sayfaların %92,8'i metnini ham HTML'de taşıyor, 20 site (%4,6) boş kabuk dönüyor ve bunların 7'si kamu kurumu. Daha büyük engel bot koruması: GPTBot kullanıcı ajanıyla yapılan iç sayfa isteklerinin %15,1'i 403 ya da doğrulama ekranına düştü.
Ana Çıkarımlar
- •Vercel'in Aralık 2024 analizine göre GPTBot, ClaudeBot ve PerplexityBot JavaScript dosyalarını indiriyor ama çalıştırmıyor; Eylül 2026 itibarıyla platform belgelerinde aksi yönde bir beyan yok.
- •GPTBot kullanıcı ajanına gerçek HTML dönen 320 iç sayfanın %92,8'i ham HTML'de 150 kelimeden fazla metin taşıyor; medyan 723,5 kelime.
- •432 popüler Türk sitesinin 20'si (%4,6) iç ya da ana sayfasında JavaScript'e bağımlı boş kabuk dönüyor; 7'si kamu kurumu, kamu örnekleminde oran %14,6.
- •GPTBot kullanıcı ajanıyla yapılan iç sayfa isteklerinin %15,1'i (57/377) 403, doğrulama ekranı ya da güvenlik duvarı sayfasıyla karşılaştı; bazı koruma sayfaları 200 koduyla dönüyor.
- •Render edilmiş DOM'unda JSON-LD bulunan 219 iç sayfanın 9'u (%4,1) şemasını yalnızca JavaScript ile ekliyor; NewsArticle ve FAQPage örnekleri var.
- •WordPress, T-Soft ve Ticimax sitelerinde kabuk çıkmadı; belirleyici olan framework değil, şablonun ilk HTML'de ne gönderdiği.
- •Ham HTML testi dört adım: kaynağı indir, metni ve H1'i ara, JSON-LD'yi kontrol et, GPTBot kimliğiyle tekrarla.
Kısa cevap: Eylül 2026 itibarıyla bilinen tablo, ChatGPT, Claude ve Perplexity tarayıcılarının JavaScript çalıştırmadığı yönünde. Vercel'in 17 Aralık 2024 tarihli analizi, GPTBot ve ClaudeBot'un JavaScript dosyalarını indirdiğini ama çalıştırmadığını gösterdi: ChatGPT isteklerinin %11,50'si, Claude isteklerinin %23,84'ü JavaScript dosyasına gidiyor, fakat bu kod hiç yürütülmüyor. Bu botlar için sayfanız, sunucunun gönderdiği ilk HTML'den ibaret.
Peki Türk siteleri bu ilk HTML'de ne gösteriyor? Sheltron olarak Eylül 2026'da Türkiye'nin en çok ziyaret edilen 432 sitesinin ana sayfasını ve bir iç sayfasını JavaScript çalıştırmadan indirdik. Tablo beklenenden iyi: GPTBot kimliğine gerçek HTML dönen 320 iç sayfanın %92,8'i metnini zaten ham HTML'de taşıyor. JavaScript kapalıyken boş kabuk dönen site sayısı 20 (%4,6) ve bunların 7'si kamu kurumu. Asıl engel başka yerde çıktı: GPTBot kullanıcı ajanıyla gönderilen iç sayfa isteklerinin %15,1'i içerik yerine 403, doğrulama ekranı ya da güvenlik duvarı sayfasıyla karşılaştı.
AI botları JavaScript okuyabilir mi?
Kısmen. Googlebot ve Google altyapısını kullanan Gemini sayfayı Chromium ile render ediyor. Vercel'in Aralık 2024 analizine göre GPTBot, ClaudeBot ve PerplexityBot ise JavaScript dosyalarını indirse de çalıştırmıyor. Bu botlar için tarayıcıda sonradan oluşan metin, menü ya da şema yok; gördükleri tek şey sunucunun gönderdiği ilk HTML.
Vercel'in verisi küçük bir test değil: şirketin ağında GPTBot ayda 569 milyon, Claude'un tarayıcısı 370 milyon istek yapıyordu. Analizin ana cümlesi açık: "none of the major AI crawlers currently render JavaScript", yani büyük AI tarayıcılarının hiçbiri o tarihte JavaScript render etmiyordu. AppleBot ve Googlebot ise sayfayı render ediyordu.
Platformların kendi belgeleri bu konuda sessiz. OpenAI'nin tarayıcı dokümantasyonu OAI-SearchBot, GPTBot ve ChatGPT-User'ı kullanıcı ajanı dizeleriyle tanımlıyor; Anthropic'in ve Perplexity'nin tarayıcı sayfaları da benzer bilgiler veriyor. Eylül 2026 itibarıyla üç belgenin hiçbirinde JavaScript render ettiklerine dair bir ifade yok. Bu yüzden güvenli varsayım şu: AI tarayıcıları için sayfanın içeriği, JavaScript çalışmadan önce sunucudan gelen HTML'dir.
| Tarayıcı | JavaScript çalıştırıyor mu? | Dayanak |
|---|---|---|
| Googlebot | Evet, güncel Chromium ile ayrı bir render aşamasında | Google Search Central, 2026 |
| Gemini (Google altyapısı) | Evet | Vercel, Aralık 2024 |
| AppleBot | Evet | Vercel, Aralık 2024 |
| GPTBot (OpenAI) | Hayır; JS dosyasını indiriyor, çalıştırmıyor | Vercel, Aralık 2024 |
| ClaudeBot (Anthropic) | Hayır; JS dosyasını indiriyor, çalıştırmıyor | Vercel, Aralık 2024 |
| PerplexityBot | Hayır | Vercel, Aralık 2024 |
Tablo zamana bağlı bir fotoğraf; bir platform render yeteneği eklerse değişir. Ancak Eylül 2026 itibarıyla OpenAI, Anthropic ve Perplexity belgelerinde böyle bir beyan olmadığı için içerik stratejisini "botlar belki render eder" varsayımına dayandırmak riskli.
Googlebot'un JavaScript render etmesi AI görünürlüğü için neden yetmiyor?
Çünkü render yeteneği Google'a özgü. Google sayfayı tarama, render ve dizinleme aşamalarında işliyor ve render için ayrı bir kuyruk tutuyor. Google'ın kendi belgesi bile her botun JavaScript çalıştıramayacağını hatırlatıyor. Google'da sorunsuz dizinlenen bir sayfa, ChatGPT'nin tarayıcısına boş görünebilir. Aynı URL, iki farklı tarayıcıya iki farklı sayfa olarak ulaşabilir.
Google'ın JavaScript SEO temelleri belgesi (son güncelleme 4 Mart 2026) 200 kodu dönen sayfaların render kuyruğuna girdiğini ve güncel bir Chromium ile işlendiğini anlatıyor. Belgeye göre sunucu tarafı ya da ön render "hâlâ iyi bir fikir", çünkü "not all bots can run JavaScript".
Googlebot'un render'ı da anlık değil. Vercel ile MERJ'in Temmuz 2024 çalışması 100.000'i aşkın Googlebot isteğini inceledi. HTML sayfaların %100'ü sonunda tam olarak render edilmişti; ancak render gecikmesi medyanda 10 saniye, 90. yüzdelikte yaklaşık 3 saat, 99. yüzdelikte yaklaşık 18 saatti. Google bu gecikmeyi kaldırabiliyor; JavaScript çalıştırmayan bir AI tarayıcısının ise ikinci bir şansı yok: sayfa ilk yanıtta boşsa, bot için boş kalıyor.
Pratik sonuç şu: Search Console'da sorun görmemek AI görünürlüğü için güvence değil. URL denetimi render edilmiş sayfayı gösterir; AI tarayıcıları ise ham yanıtı okur. ChatGPT'de görünmemenin yedi nedenini ele aldığımız yazıdaki teknik kontrollere bu farkı da eklemek gerekiyor.
İki tanım gerisini netleştiriyor. web.dev'deki "Rendering on the Web" makalesi, sunucu tarafı render'ı (SSR) "uygulamayı sunucuda render edip istemciye JavaScript yerine HTML göndermek", istemci tarafı render'ı (CSR) ise "uygulamayı tarayıcıda, DOM'u JavaScript ile değiştirerek render etmek" olarak tanımlıyor. AI tarayıcıları açısından ilki içeriğin ilk yanıtta gelmesi, ikincisi hiç gelmemesi demek.
Vercel verisindeki bir ayrıntı da aynı yöne işaret ediyor: ChatGPT isteklerinin %34,82'si 404 sayfasına gidiyordu, Googlebot'ta bu oran %8,22'ydi. 404 oranı bu kadar yüksek bir tarayıcı için, ulaştığı sayfanın ilk yanıtta eksiksiz olması daha da önemli. İnce ya da boş sayfaların dizin kalitesine etkisini taranmış ama dizine eklenmemiş sayfalar yazımızda ele aldık.
432 Türk sitesini JavaScript kapalıyken nasıl ölçtük?
Sheltron'un taramasında, Chrome UX Report'un (CrUX) Ağustos 2026 Türkiye listesinde ilk 1.000'e giren sitelerden süzülen 432 Türk alan adının ana sayfası ve bir iç sayfası, Eylül 2026'da hem tarayıcı hem GPTBot kullanıcı ajanıyla, JavaScript çalıştırılmadan indirildi. 757 sayfa ayrıca headless Chrome'da render edilip ham HTML ile karşılaştırıldı.
Yöntemin ana hatları:
- Örneklem: CrUX Türkiye listesinin ilk 1.000 kaynağından yetişkin içerik, yasa dışı bahis, lisanssız yayın ve Türkiye'ye özgü olmayan küresel platformlar çıkarıldı; 432 alan adı kaldı. Sektör etiketleri elle verildi. Liste Türkiye'nin en çok ziyaret edilen sitelerini temsil eder, KOBİ sitelerini değil.
- İç sayfa seçimi: Sitemap'teki kök, dosya ya da giriş/sepet yolu olmayan ilk URL alındı; sitemap sonuç vermezse ana sayfadaki ilk uygun bağlantı kullanıldı. 294 iç sayfa sitemap'ten, 100'ü ana sayfa bağlantısından geldi; 38 alan adında uygun iç sayfa bulunamadı.
- Ölçülenler: Betik, stil ve
<noscript>blokları çıkarıldıktan sonra görünür kelime sayısı; H1;application/ld+jsonblokları;__NEXT_DATA__,__nuxt,ng-versiongibi framework izleri; içi boş<div id="root">benzeri kök öğeler. - Eşik ve doğrulama: Ham HTML'de 150 kelimenin altında kalan 70 sayfa yeniden çekildi, kanıt olarak saklandı ve tek tek sınıflandı: JavaScript'e bağımlı kabuk mu, kısa bir hata ya da giriş sayfası mı, yoksa koruma sayfası mı?
- Render karşılaştırması: Tarayıcı kimliğiyle başarılı dönen 782 sayfa Chrome'da açıldı; 757'si render edildi (395 ana sayfa, 362 iç sayfa), 25'i hata verdi.
150 kelime eşiği keyfî olduğu için duyarlılığını da ölçtük. Doğrulama öncesindeki ilk sınıflamada (payda 322) iç sayfaların %4,3'ü 50, %6,2'si 100, %7,8'i 150, %15,5'i 300 kelimenin altındaydı. Eşik ne seçilirse seçilsin, popüler Türk sitelerinin büyük çoğunluğu ham HTML'de ciddi miktarda metin taşıyor. Ölçümün sınırlarını yazının sonunda ayrıca ele alıyoruz.
Gerçek HTML dönen iç sayfaların %92,8'i metnini JavaScript'siz taşıyor
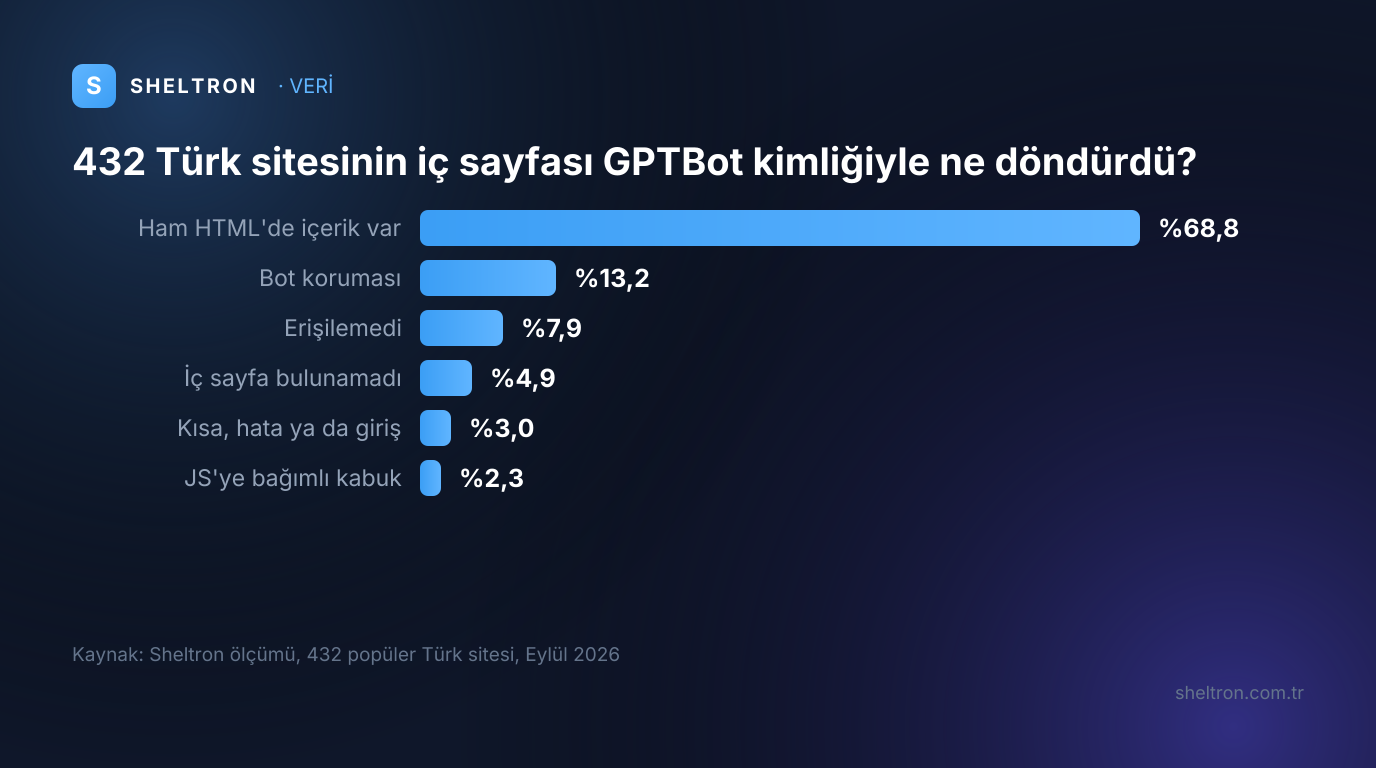
GPTBot kullanıcı ajanına gerçek HTML dönen 320 iç sayfanın 297'si, JavaScript çalışmadan da 150 kelimenin üzerinde görünür metin taşıyor; medyan 723,5 kelime. Yalnızca 10 iç sayfa (%3,1) JavaScript'e bağımlı boş kabuk çıktı. Türkiye'nin popüler sitelerinde istemci tarafı render istisna, kural değil.
| İç sayfa sonucu (GPTBot kullanıcı ajanı, Eylül 2026) | Site | 432 sitenin payı | Gerçek HTML yanıtları içinde (320) |
|---|---|---|---|
| Ham HTML'de içerik var (150+ kelime) | 297 | %68,8 | %92,8 |
| Kısa sayfa, hata ya da giriş sayfası | 13 | %3,0 | %4,1 |
| JavaScript'e bağımlı boş kabuk | 10 | %2,3 | %3,1 |
| Bot koruması (403, doğrulama, güvenlik duvarı sayfası) | 57 | %13,2 | — |
| Her iki kimlikle de erişilemedi | 34 | %7,9 | — |
| Uygun iç sayfa bulunamadı | 21 | %4,9 | — |
"Az kelime" ile "JavaScript sorunu" aynı şey değil. Ham HTML'de 150 kelimenin altında kalan 25 iç sayfanın yalnızca 10'u gerçekten JavaScript'e bağımlıydı; 13'ünde JavaScript açılınca da metin artmadı, çünkü sayfa zaten bir oturum ekranı, hata sayfası ya da doğal olarak kısa bir sayfaydı. Kalan 2 sayfa koruma ekranı çıktı.
Render karşılaştırması da aynı yönde. Chrome'da render edilen 362 iç sayfada ham HTML ile render edilmiş sayfanın kelime oranı medyanda 0,96; tipik bir iç sayfada JavaScript'in eklediği metin toplamın küçük bir kısmı. Render sonrasında en az 150 kelime taşıyan sayfalar içinde 37 sayfada (362 sayfanın %10,2'si) render edilmiş metnin yarısından azı ham HTML'de vardı; ancak bu grup, sonsuz kaydırma ya da "ilgili haberler" akışı gibi JavaScript ile yüklenen ikincil içeriklerle şişen sayfaları da kapsıyor. Bu yüzden %10,2'yi "içeriğin yarısı kayboluyor" diye okumak doğru olmaz.
Yapısal öğeler de çoğunlukla yerinde: gerçek HTML dönen 320 iç sayfanın %79,4'ünde (254) H1, %56,9'unda (182) JSON-LD ham HTML'de yer alıyor. Web geneline bakan HTTP Archive Web Almanac 2024 SEO bölümü H1 oranını masaüstünde %70, yapılandırılmış veri bölümü JSON-LD oranını %41 olarak veriyor. Örneklem ve yöntem farklı olduğu için iki rakam yan yana okunabilir ama doğrudan kıyaslanamaz. Almanac'a göre web genelinde ana sayfalarda ham ve render edilmiş kelime sayısı arasındaki medyan fark mobilde %13,6, masaüstünde %17,5; iç sayfalarda fark daha dar.
Yine de metnin ham HTML'de bulunması, alıntılanacak bölümün de orada olduğu anlamına gelmez. Tanım paragrafı, SSS cevabı ya da karşılaştırma tablosu istemci tarafında açılan bir sekmedeyse, sayfanın geri kalanı dolu olsa bile en değerli blok eksik kalır. AI'ın sayfanın hangi bölümünden alıntı yaptığını LLM'lerin alıntı yaptığı içerik yapısı yazısında ayrıntılı ele aldık.
Boş kabuk dönen 20 site hangi sektörde ve hangi altyapıda?
İç ya da ana sayfası JavaScript'e bağımlı kabuk dönen 20 sitenin 7'si kamu kurumu; kamu örnekleminde oran %14,6, e-ticaret ve haber sitelerinde %1,0. Ortak iz, içi boş bir kök öğe ya da Next.js'in istemci tarafına düşme işareti. WordPress, T-Soft ve Ticimax altyapılı sitelerde tek bir kabuk çıkmadı.
| Sektör | Örneklem | JS'ye bağımlı kabuk (iç ya da ana sayfa) | Bot koruması (iç sayfa) | Ham HTML'de JSON-LD (gerçek yanıt veren iç sayfa) |
|---|---|---|---|---|
| E-ticaret / perakende | 103 | 1 (%1,0) | 19 (%18,4) | 44/71 (%62,0) |
| Haber / medya | 96 | 1 (%1,0) | 12 (%12,5) | 64/79 (%81,0) |
| Kamu | 48 | 7 (%14,6) | 1 (%2,1) | 7/33 (%21,2) |
| Finans | 28 | 1 (%3,6) | 1 (%3,6) | 14/24 (%58,3) |
| İçerik / topluluk | 28 | 0 | 7 (%25,0) | 10/19 (%52,6) |
| Telekom / yazılım | 27 | 2 (%7,4) | 0 | 12/26 (%46,2) |
| Seyahat / etkinlik | 21 | 3 (%14,3) | 4 (%19,0) | 10/15 (%66,7) |
Yüzdeler sektör örneklemine göre, JSON-LD sütunu ise iç sayfası gerçek HTML döndüren sitelere göre hesaplandı; 15'ten az siteli sektörler tabloya alınmadı.
Eylül 2026 ölçümünde hmb.gov.tr ve kbs.gov.tr ana sayfaları JavaScript kapalıyken yalnızca <div id="root"></div>, tcddtasimacilik.gov.tr <app-root></app-root>, ilan.gov.tr ise <igt-root></igt-root> döndürdü. gib.gov.tr'nin ölçülen iç sayfasında Next.js'in BAILOUT_TO_CLIENT_SIDE_RENDERING işareti vardı: ham HTML'de sıfır kelime, render sonrasında 675 kelime. Başvuru ve işlem ekranlarında istemci tarafı render anlaşılır bir tercih. Sorun, duyuru ve bilgilendirme gibi vatandaşın sorularını cevaplayan sayfaların da aynı kabuğu kullanması. Bu durumda AI asistanı, kurumun kendi sayfası yerine duyuruyu aktaran bir haber sitesini kaynak gösterebilir.
Aynı sitede iki render modu da görüldü. migros.com.tr'nin ana sayfası sunucuda dolu HTML ile gelirken, ölçülen iç sayfa (/islem-rehberi) ham HTML'de boş bir <sm-root></sm-root> döndürdü; render sonrasında sayfada 236 kelime ve bir FAQPage şeması vardı. biletix.com'da ham HTML bir JavaScript yönlendirmesi ve "JavaScript'i etkinleştirin" uyarısından ibaretti; render sonrasında sayfa 3.654 kelimeye çıktı. skyscanner.com.tr'nin iç sayfası ise kimliğe göre farklı yanıt verdi: tarayıcı kullanıcı ajanına 482 kelimelik HTML, GPTBot kullanıcı ajanına boş bir <div id="root"> kabuğu. Yalnızca kendi tarayıcınızla test etmek bu yüzden yetmiyor.
Framework açısından belirleyici olan araç değil, render modu. Nuxt izi taşıyan gerçek yanıtlı 6 iç sayfanın 3'ü kabuk çıktı (misli.com ve hipodrom.com'da boş <div id="__nuxt">). Next.js'te ise tablo farklı: sayfa yönlendiricisi kullanan 18 sitenin 2'si, uygulama yönlendiricisi kullanan 28 sitenin 1'i kabuk döndürdü. WordPress (27), T-Soft (17) ve Ticimax (8) sitelerinde kabuk yoktu; bu sistemler sayfayı varsayılan olarak sunucuda üretiyor. React ya da Vue kullanmak tek başına sorun değil; sorun, sayfanın ilk HTML'inin boş gönderilmesi.
Bu isimler bir suçlama değil, Eylül 2026'da tek bir iç sayfa üzerinden ölçülmüş teknik bir durum; kurumların render tercihleri sonradan değişebilir.
JavaScript ile eklenen JSON-LD AI botlarına görünür mü?
Hayır. JavaScript çalıştırmayan bir tarayıcı, DOM'a sonradan yazılan şemayı hiç görmez. Eylül 2026 ölçümünde render edilmiş DOM'unda JSON-LD bulunan 219 iç sayfanın 9'u (%4,1) şemasını yalnızca JavaScript ile ekliyordu; bu 9 sayfa dahil 12 sayfada render sonrasındaki JSON-LD blok sayısı ham HTML'dekinden fazlaydı.
Google Tag Manager ya da istemci tarafı kodla eklenen JSON-LD, JavaScript çalıştırmayan AI tarayıcıları için yoktur. Ölçümdeki örnekler somut: kanald.com.tr ve korkusuz.com.tr'nin ölçülen iç sayfalarında NewsArticle, sozcu.com.tr'de NewsMediaOrganization ve WebPage, migros.com.tr'de FAQPage, mediamarkt.com.tr'de BreadcrumbList şeması yalnızca render sonrasında ortaya çıktı. Sonuçta AI tarayıcılarının en çok işine yarayacak makale ve SSS bilgisi, tam da bu tarayıcılara ulaşmıyor.
Google tarafında durum farklı. Google'ın JavaScript ile yapılandırılmış veri oluşturma belgesi (son güncelleme 10 Aralık 2025), Google Arama'nın sayfayı render ettiğinde DOM'daki yapılandırılmış veriyi işleyebildiğini söylüyor. Aynı belge iki uyarı da içeriyor: Google Tag Manager ile şema eklemek sayfa ile şema arasında uyuşmazlık riskini artırıyor ve e-ticarette dinamik olarak üretilen işaretleme alışveriş taramalarını daha seyrek ve daha az güvenilir hâle getirebiliyor. Yani bu kurulum Google için bile ideal değil; AI tarayıcıları için ise hiç çalışmıyor.
Sheltron'un kendi sitesinde de bu dersi yaşadık. SSS cevaplarımız FAQPage JSON-LD'sinde vardı ama cevaplar istemci tarafında açılan bir akordeonun içinde olduğu için DOM'da yoktu. Bu dönemde FAQPage şemasının atıfla korelasyonu ρ = −0,061, yani fiilen sıfırdı. Akordeon sunucu tarafında render edilecek şekilde düzeltildiğinde SSS sayfamızda görünür soru sayısı 5'ten 41'e çıktı. Düzeltmenin yayına alındığı 23 Temmuz 2026'daki ölçümde 10 marka dışı sorgunun hiçbirinde AI Overview kaynağı değildik; 9 Ağustos 2026 ölçümünde AI Overview çıkan 16 sorgunun 6'sında kaynak gösterildik. Sorgu setleri farklı olduğu için bu değişimi tek bir düzeltmeye bağlamak kesin bir sonuç değil; ama yön tutarlı.
Pratik kural basit: JSON-LD, sunucunun gönderdiği ilk HTML'de yer almalı ve sayfada görünen metinle aynı şeyi söylemeli. Şema tiplerinin seçimi için Schema.org JSON-LD rehberimize, şemanın Next.js gibi yapılarda sunucu tarafında nasıl basılacağı için schema markup ve llms.txt teknik altyapı yazımıza, SSS işaretlemesinde doğru tip için FAQ ve QA schema karşılaştırmamıza bakabilirsiniz. Mevcut şemanızın ham HTML'de olup olmadığını Schema Markup Doğrulayıcı ile kontrol edebilirsiniz.
Asıl engel JavaScript değil, bot koruması
Türk sitelerinde AI tarayıcılarının içeriğe ulaşmasını JavaScript'ten çok bot koruması engelliyor. GPTBot kullanıcı ajanıyla gönderilen iç sayfa isteklerinin %15,1'i (57/377) 403, Cloudflare doğrulaması ya da güvenlik duvarı ret sayfasıyla sonuçlandı. Sayı olarak bu, JavaScript'e bağımlı kabuk dönen 10 iç sayfanın beş katından fazla.
Paydadaki 377, GPTBot kimliğiyle iç sayfada ya gerçek HTML ya da koruma yanıtı alan sitelerdir. Bu oran iç sayfaya ve koruma imzalarına dayanır; ana sayfada robots.txt ya da sunucu yanıtı taramasından farklı bir ölçüdür. 57 koruma yanıtının 34'ü doğrudan 403 durum kodu, 12'si Cloudflare engelleme ya da doğrulama ekranı, 4'ü yanıtsız kesilen bağlantı, 2'si 429 (çok fazla istek) yanıtıydı; kalan 5'i Access Denied, Turnstile, PerimeterX, F5 ve CloudFront sayfalarıydı.
Sektörlere göre bakıldığında e-ticarette 103 sitenin 19'u (%18,4), içerik ve topluluk sitelerinde 28 sitenin 7'si (%25,0) GPTBot kimliğine iç sayfada koruma yanıtı verdi. Kamu sitelerinde bu oran yalnızca %2,1. Kaba bir özetle, kamu sitelerinde engel render katmanında, e-ticaret ve topluluk sitelerinde ise güvenlik katmanında toplanıyor.
Koruma sayfaları her zaman hata koduyla gelmiyor. todtv.com.tr ve beinconnect.com.tr GPTBot kullanıcı ajanına F5'in "Request Rejected" sayfasını, dergipark.org.tr Cloudflare Turnstile doğrulamasını, letgo.com Akamai'nin ara doğrulama sayfasını gösterdi; bu yanıtların bir kısmı 200 durum koduyla döndü. Yalnızca durum koduna bakan bir izleme aracı bu sayfaları "açık" sayar.
Bu rakamı doğru okumak için önemli bir sınır var: ölçtüğümüz şey, GPTBot'un kullanıcı ajanı dizesine verilen tepki. İstekler OpenAI'nin IP bloklarından gelmedi. Doğrulanmış bot listeleriyle çalışan güvenlik duvarları gerçek GPTBot'u farklı karşılayabilir; kimliği taklit eden bir isteği engellemek de meşru bir güvenlik tercihi. Dolayısıyla "bu siteler GPTBot'u engelliyor" denemez. Söylenebilecek olan, bu sitelerin AI tarayıcısı gibi görünen isteklere katı kurallar uyguladığı; kuralların gerçek botlara nasıl işlediğini ancak site sahibi kendi loglarından doğrulayabilir.
Sitenizin robots.txt dosyasında hangi AI tarayıcılarına izin verdiğinizi Robots.txt AI Bot Kontrolü ile görebilirsiniz. Ancak robots.txt izni tek başına yetmez: güvenlik duvarı ya da CDN kuralı aynı tarayıcıyı kapıda durduruyorsa, izin kâğıt üzerinde kalır. AI tarayıcılarının sitelere ne sıklıkla geldiğini ve karşılığında ne kadar trafik gönderdiğini AI crawler ekonomisi yazımızda ele aldık.
Sitenizin ham HTML'ini nasıl test edersiniz?
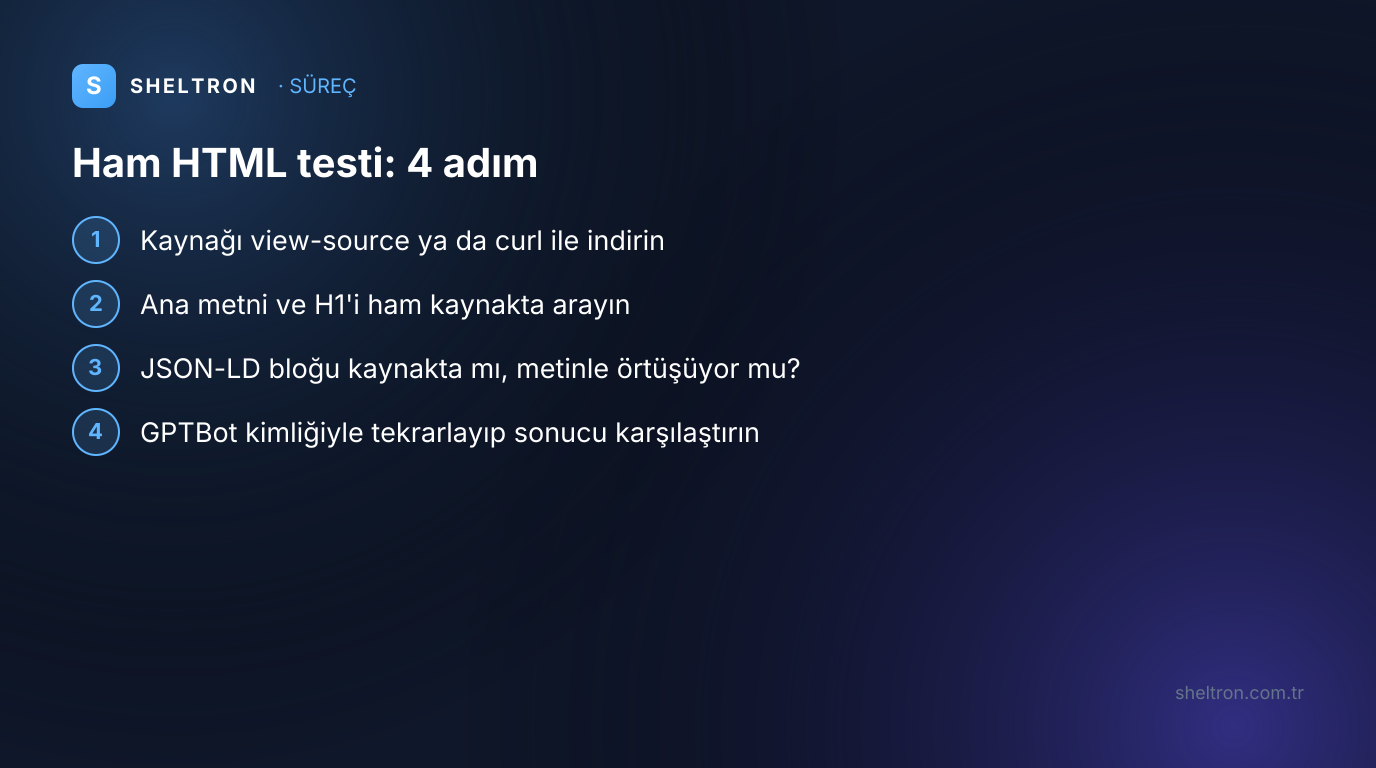
En hızlı yol, sayfanın kaynağını JavaScript çalışmadan görmek: tarayıcıda view-source: ile açın ya da curl ile GPTBot kullanıcı ajanıyla indirin. Ana metin, H1 ve application/ld+json bloğu bu kaynakta yoksa, JavaScript çalıştırmayan AI tarayıcıları da onları görmüyor demektir. Test birkaç dakika sürer ve özel bir araç gerektirmez.
Dört adımlık bir kontrol yeterli:
- Ham HTML'i indirin. Geliştirici araçlarındaki öğe paneli render edilmiş DOM'u gösterdiği için yanıltıcıdır;
view-source:ya da komut satırı kullanın. - Metni ve başlığı arayın. Ana paragraftan bir cümle ve H1 ham kaynakta yoksa içerik istemci tarafında oluşuyor.
- Şemayı kontrol edin.
application/ld+jsonbloğu ham kaynakta mı ve sayfadaki metinle örtüşüyor mu? - GPTBot kimliğiyle tekrarlayın. Durum kodunu ve içeriği tarayıcı kimliğiyle aldığınız sonuçla karşılaştırın.
Komut satırında bu işlem birkaç satır tutar:
UA="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"
curl -sL -A "$UA" -o ham.html -w "%{http_code}\n" https://siteniz.com.tr/sayfa/
grep -c "<h1" ham.html
grep -c "application/ld+json" ham.html
Durum kodu 200 olsa bile dosyanın içine bakın; boş bir kök öğe ya da koruma sayfası da 200 ile dönebiliyor. Testi yalnızca ana sayfada yapmayın: Migros örneğindeki gibi bir iç şablon istemci tarafında kalabiliyor. Kategori, ürün, makale ve SSS şablonlarının her birinden en az bir URL deneyin.
Komut satırı kullanmayan ekipler için Sheltron'un ücretsiz araçları aynı kontrolü yapar. İçerik Denetimi başlık hiyerarşisini, SSS yapısını ve şemayı, Schema Markup Doğrulayıcı ise JSON-LD bloklarını denetler. İki araç da sayfayı JavaScript çalıştırmadan çektiği için sonuç, AI tarayıcılarının aldığı ham yanıta yakındır. Markanızın AI yanıtlarındaki durumuna hızlı bir bakış için AI Görünürlük Spot Check da var.
SSR, statik render ya da ön render: hangisi seçilmeli?
İçerik sayfaları için sunucu tarafı ya da statik render; giriş, sepet ve form gibi uygulama ekranları için istemci tarafı render yeterli. Google dinamik render'ı artık önerilen bir çözüm değil, geçici bir çare olarak tanımlıyor. Karar framework'e göre değil, her sayfa şablonunun ilk HTML'de ne gönderdiğine göre verilmeli.
| Render modu | İlk HTML'de metin var mı? | JS çalıştırmayan AI tarayıcısı içeriği görür mü? | Uygun olduğu sayfalar |
|---|---|---|---|
| İstemci tarafı render (CSR) | Hayır, boş kök öğe | Hayır | Giriş, sepet, hesap, başvuru formu |
| Sunucu tarafı render (SSR) | Evet | Evet | Ürün, kategori, haber, sık güncellenen içerik |
| Statik render / ön render (SSG) | Evet | Evet | Blog, rehber, SSS, kurumsal sayfa |
| SSR + hydration | Evet, sonra etkileşim eklenir | Evet | Etkileşimli ama içerik taşıyan sayfalar |
| Dinamik render (botlara ayrı HTML) | Yalnız bot için | Bot tanınırsa evet | Google'a göre geçici çözüm; önerilmiyor |
Google'ın dinamik render belgesi bu yöntemi açıkça "önerilen bir çözüm değil, geçici bir çare" olarak nitelendiriyor ve yerine sunucu tarafı render, statik render ya da hydration öneriyor. AI tarayıcıları açısından dinamik render'ın ek bir zayıflığı var: bot listesini güncel tutmanız gerekir. Yeni bir AI tarayıcısı tanınmadığında boş kabuğu alır.
Geçiş çoğu zaman sanıldığı kadar büyük bir proje değil: Next.js ve Nuxt zaten sunucu tarafı render destekliyor; kabuk dönen sitelerde sorun çoğunlukla belirli şablonların istemci tarafına bırakılması. Kontrol listesi:
- Alıntılanması istenen her blok (tanım, SSS cevabı, tablo, fiyat, stok bilgisi) ilk HTML'de olmalı.
- Sekme ve akordeonlar kapalıyken içerik DOM'dan çıkarılmamalı; görsel olarak gizlemek yeterli.
- JSON-LD sunucu tarafında basılmalı; Tag Manager ile eklenen şema yalnız Google içindir.
- Her dağıtımdan sonra kritik şablonlar ham HTML testinden geçirilmeli; bir bileşen güncellemesi düzeltmeyi sessizce geri alabilir.
Düzeltmelerin AI yanıtlarına etkisini zaman içinde izlemek için Sheltron'un AI görünürlük platformu kullanılabilir. Konunun eğitim tarafı için GEO Akademi, kavramsal arka plan için The GEO Authority, genel çerçeve için GEO nedir rehberimiz, e-ticaret siteleri için e-ticaret AI görünürlük rehberimiz iyi başlangıç noktaları.
Bu ölçüm neyi söylemiyor?
Bu ölçüm, gerçek AI tarayıcılarının ne gördüğünü değil, GPTBot kullanıcı ajanıyla JavaScript kapalıyken yapılan isteklere ne döndüğünü gösteriyor. Botların JavaScript çalıştırmadığı varsayımı Vercel'in Aralık 2024 analizine dayanıyor; bu çalışmada ayrıca ölçülmedi. Ayrıca kelime sayısı ana içerik ölçüsü değildir ve her siteden yalnızca tek iç sayfa ölçüldü.
Dört sınır akılda tutulmalı:
- Kullanıcı ajanı taklidi gerçek bot değildir. %15,1'lik koruma oranı, OpenAI IP'lerinden gelmeyen isteklerde kullanıcı ajanı dizesine verilen tepkidir.
- Her siteden tek iç sayfa ölçüldü. Sitemap'teki ilk uygun URL, sitenin tipik sayfası olmayabilir; bazı sitelerde bu bir arama ya da giriş sayfasına denk geldi.
- Kelime sayısı ana içerik ölçüsü değildir. Menü, altbilgi ve çerez bandı metni de sayıldı. Render tarafındaki sayılar sonsuz kaydırma akışlarıyla şişebiliyor.
- Tek zaman kesiti. Veri Eylül 2026'da toplandı. Hem sitelerin render tercihleri hem de platformların tarayıcı davranışı sonradan değişebilir.
Bu sınırlar içinde bile bulgunun özü sağlam: popüler Türk sitelerinin büyük çoğunluğu metnini ham HTML'de taşıyor. Sorun küçük bir grupta, özellikle kamu sitelerinde ve yalnızca JavaScript ile eklenen şemalarda yoğunlaşıyor. Daha büyük ve daha az konuşulan kayıp ise AI tarayıcısı gibi görünen isteklere uygulanan koruma kurallarında.
Sitenizin hangi şablonlarının AI tarayıcılarına boş ya da kapalı göründüğünü bilmiyorsanız, işe tek bir sayfa listesiyle başlayabilirsiniz. Sheltron'un hızlı değerlendirmesi sitenizin ChatGPT ve Gemini'de nasıl göründüğünü test eder; bu sonucu ham HTML kontrolünüzle yan yana koyduğunuzda, görünmemenin içerikten mi yoksa erişimden mi kaynaklandığını ayırmak kolaylaşır.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- AI Botları JavaScript Okuyabilir mi? 432 Türk Sitesinin Ham HTML Ölçümü
- TL;DR
- Vercel'in Aralık 2024 analizine göre GPTBot, ClaudeBot ve PerplexityBot JavaScript çalıştırmıyor. Sheltron, Eylül 2026'da 432 popüler Türk sitesini JavaScript kapalıyken ölçtü: gerçek HTML dönen iç sayfaların %92,8'i metnini ham HTML'de taşıyor, 20 site (%4,6) boş kabuk dönüyor ve bunların 7'si kamu kurumu. Daha büyük engel bot koruması: GPTBot kullanıcı ajanıyla yapılan iç sayfa isteklerinin %15,1'i 403 ya da doğrulama ekranına düştü.
- Ana Çıkarımlar (7)
- Vercel'in Aralık 2024 analizine göre GPTBot, ClaudeBot ve PerplexityBot JavaScript dosyalarını indiriyor ama çalıştırmıyor; Eylül 2026 itibarıyla platform belgelerinde aksi yönde bir beyan yok.
- GPTBot kullanıcı ajanına gerçek HTML dönen 320 iç sayfanın %92,8'i ham HTML'de 150 kelimeden fazla metin taşıyor; medyan 723,5 kelime.
- 432 popüler Türk sitesinin 20'si (%4,6) iç ya da ana sayfasında JavaScript'e bağımlı boş kabuk dönüyor; 7'si kamu kurumu, kamu örnekleminde oran %14,6.
- GPTBot kullanıcı ajanıyla yapılan iç sayfa isteklerinin %15,1'i (57/377) 403, doğrulama ekranı ya da güvenlik duvarı sayfasıyla karşılaştı; bazı koruma sayfaları 200 koduyla dönüyor.
- Render edilmiş DOM'unda JSON-LD bulunan 219 iç sayfanın 9'u (%4,1) şemasını yalnızca JavaScript ile ekliyor; NewsArticle ve FAQPage örnekleri var.
- WordPress, T-Soft ve Ticimax sitelerinde kabuk çıkmadı; belirleyici olan framework değil, şablonun ilk HTML'de ne gönderdiği.
- Ham HTML testi dört adım: kaynağı indir, metni ve H1'i ara, JSON-LD'yi kontrol et, GPTBot kimliğiyle tekrarla.
- Kaynaklı Veriler
- %92,8 — GPTBot kullanıcı ajanına gerçek HTML dönen 320 iç sayfanın 297'si ham HTML'de 150 kelimeden fazla metin taşıyor (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %4,6 — 432 sitenin 20'si iç ya da ana sayfasında JavaScript'e bağımlı boş kabuk döndürüyor (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %14,6 — 48 kamu sitesinin 7'si JavaScript'e bağımlı kabuk dönüyor; e-ticaret ve haberde oran %1,0 (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %15,1 — GPTBot kullanıcı ajanıyla yapılan iç sayfa isteklerinin 57/377'si 403, doğrulama ekranı ya da güvenlik duvarı sayfasıyla karşılaştı (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %4,1 — render edilmiş DOM'unda JSON-LD bulunan 219 iç sayfanın 9'u şemasını yalnızca JavaScript ile ekliyor (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %79,4 — gerçek HTML dönen iç sayfaların ham HTML'inde H1 bulunma oranı; JSON-LD oranı %56,9 (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- 0,96 — 362 iç sayfada ham HTML ile render edilmiş sayfa arasındaki medyan kelime oranı (Sheltron ölçümü (432 popüler Türk sitesi, Eylül 2026), 2026)
- %11,50 — ChatGPT isteklerinin JavaScript dosyalarına giden payı; Claude'da %23,84. Dosyalar indiriliyor ama çalıştırılmıyor (Vercel, The rise of the AI crawler, 2024)
- 569 milyon — GPTBot'un Vercel ağındaki aylık istek sayısı; Claude'un tarayıcısında 370 milyon (Vercel, The rise of the AI crawler, 2024)
- %34,82 — ChatGPT isteklerinin 404 sayfasına gitme oranı; Googlebot'ta %8,22 (Vercel, The rise of the AI crawler, 2024)
- 10 saniye — Googlebot render gecikmesinin medyanı; 99. yüzdelikte yaklaşık 18 saat (Vercel ve MERJ, How Google handles JavaScript throughout the indexing process, 2024)
- %13,6 — web genelinde ana sayfalarda ham ve render edilmiş kelime sayısı arasındaki medyan fark (mobil); masaüstünde %17,5 (HTTP Archive Web Almanac 2024, SEO, 2024)
- %41 — web genelinde JSON-LD kullanan sayfa oranı (HTTP Archive Web Almanac 2024, Structured Data, 2024)
- Arama Niyetleri
- ai botları javascript okuyabilir mi
- gptbot javascript render
- client side rendering ai görünürlük
- javascript ile eklenen json-ld okunur mu
- react site chatgpt içerik görmüyor
- ssr csr geo farkı
- ham html nedir
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz