
Sahte GPTBot'u Nasıl Ayırt Edersiniz? AI Botlarını IP Aralığı ve Reverse DNS ile Doğrulama
User-agent taklit edilebildiği için log'da GPTBot, ClaudeBot ya da PerplexityBot görmek kanıt değildir. OpenAI, Perplexity, Anthropic, Google, Bing ve Apple'ın resmî IP listeleri, reverse DNS testi, eşleştirme betiği ve en sık yapılan doğrulama hataları.
💡Kısa Özet
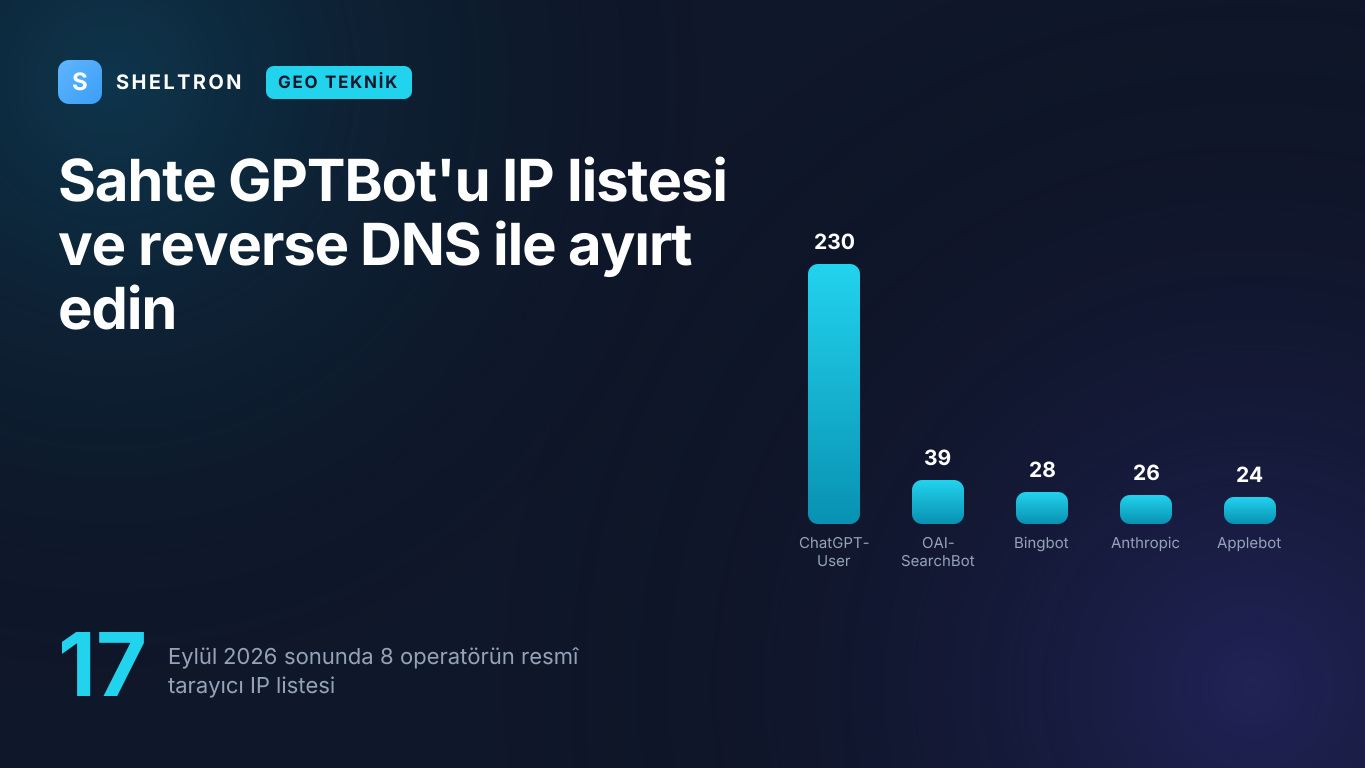
Log'da GPTBot yazması isteğin OpenAI'dan geldiğini kanıtlamaz. 29 Eylül 2026 indirmesine göre 8 operatör 17 resmî tarayıcı IP listesi yayımlıyor. Operatör başına 1-2 örnek IP ile yaptığımız testte reverse DNS Google, Bing, Apple ve Common Crawl'da çalıştı; OpenAI IP'lerinde PTR kaydı yoktu; Anthropic ve Perplexity IP'leri ya kayıt vermedi ya da yalnız genel bir bulut adı döndürdü. PerplexityBot listesinin tamamı 18 adres, Bingbot listesi 3 Ocak 2024 tarihli.
Ana Çıkarımlar
- •User-agent istemcinin kendi beyanıdır; Thales/Imperva'ya göre 2024'te otomatik trafik tüm web trafiğinin %51'ine ulaştı ve bu ortamda bot adı tek başına kimlik kanıtı değildir.
- •29 Eylül 2026 indirmesine göre 8 operatör 17 resmî tarayıcı IP listesi yayımlıyor: Google 5, OpenAI 4, Perplexity 2, DuckDuckGo 2, Bing, Anthropic, Apple ve Common Crawl birer.
- •Reverse + forward DNS testi Google, Bing, Apple ve Common Crawl'da çalıştı; test edilen OpenAI IP'lerinde ve Anthropic'in 216.73.216.0/22 bloğundaki IP'de PTR kaydı yoktu; Anthropic'in Google Cloud IP'si yalnız genel googleusercontent.com, Perplexity ise genel bir AWS adı döndürdü (operatör başına 1-2 örnek IP).
- •Listeler çok farklı ölçekte: PerplexityBot 18 adres, GPTBot 2.704 adres, ChatGPT-User 36.432 adres; Bingbot listesi 3 Ocak 2024, PerplexityBot listesi 7 Şubat 2025 tarihli.
- •OpenAI, Perplexity, Anthropic, Bing, Apple ve DuckDuckGo listelerinde IPv6 blok yok; IPv6'dan gelen ve bu botları iddia eden istek listeyle doğrulanamaz.
- •Reverse DNS'te googleusercontent.com görmek yetmez: Anthropic listesindeki bir Google Cloud IP'si tam olarak bu adı döndürdü; bu sonuç Google'ın fetcher listeleriyle çapraz kontrol edilmelidir.
- •Google-Extended ve Applebot-Extended birer robots.txt token'ıdır; log'da bu adla gelen istek tanımı gereği Google ya da Apple değildir.
- •AWS WAF Bot Control'ün CategoryAI kuralı, Web Bot Auth imzası doğrulananlar dışında, doğrulanmış olsun olmasın eşleşen tüm AI botlarını varsayılan olarak engeller; varsayılan eylem bilinçli olarak seçilmelidir.
Sunucu log'unuzda "GPTBot" yazan bir satır, isteğin OpenAI'dan geldiğini kanıtlamaz. User-agent başlığını istemci kendisi yazar ve herkes kopyalayabilir. Thales/Imperva'nın 2025 Bad Bot Report bültenine göre 2024'te otomatik trafik tüm web trafiğinin %51'ine ulaştı; kötü niyetli botların payı da %37'ye çıktı (2023'te %32). Bu kalabalıkta bir AI botunun kimliğini kanıtlamanın iki yolu var: operatörün yayımladığı resmî IP listesiyle eşleştirme ve reverse + forward DNS kontrolü.
Sheltron'un 29 Eylül 2026'da indirdiği resmî dosyalara göre Eylül 2026 sonu itibarıyla 8 operatör, 17 makinece okunur tarayıcı IP listesi yayımlıyor. Aynı gün operatör başına 1-2 örnek IP ile yaptığımız DNS testinde OpenAI IP'lerinde PTR kaydı yoktu; Anthropic ve Perplexity IP'leri ise ya kayıt vermedi ya da yalnız genel bir bulut adı döndürdü. Bu üç operatörde pratikteki tek doğrulama yolu IP listesidir. Listeler sık güncellendiği için yazıdaki tüm liste rakamları 29 Eylül 2026 indirmesine aittir.
Log'da "GPTBot" görmek neden OpenAI'ın sitenizi taradığını kanıtlamaz?
User-agent, isteği gönderen istemcinin kendi beyan ettiği bir metin alanıdır ve sunucu bu beyanı doğrulamaz. Bir betiğe tek satır ekleyen herkes kendini GPTBot, ClaudeBot ya da Googlebot olarak tanıtabilir. Kimliği kanıtlayan şey IP adresidir: adres ya operatörün yayımladığı listede olmalı ya da operatörün alan adına çözülen bir DNS kaydına sahip olmalıdır.
Taklit iki yönde işler. Birincisi bilinen durumdur: engellenmemek için tanınmış bir bot adını kullanan veri kazıma botları. Common Crawl, CCBot sayfasında kendini yanlışlıkla CCBot olarak tanıtan tarayıcılardan haberdar olduğunu açıkça yazıyor; CCBot artık reverse DNS kaydı olan ayrılmış IP aralıklarından çalışıyor.
İkinci yön daha az konuşulur: bir operatörün kendi botunu gizlemesi. Cloudflare'in 4 Ağustos 2025 tarihli incelemesine göre Perplexity'nin beyan edilen tarayıcısı günde 20-25 milyon istek yaparken, beyan edilmemiş bir tarayıcı macOS üzerinde Chrome kılığında günde 3-6 milyon istek daha yaptı. Bu isteklerin geldiği IP'lerin bir kısmı Perplexity'nin resmî IP aralığında değildi. Cloudflare sonuçta Perplexity'yi doğrulanmış bot listesinden çıkardı. Aynı testte ChatGPT robots.txt dosyasını okudu ve tarama yasaklanınca durdu.
İki durumun GEO açısından sonucu aynıdır: bot adına göre yapılan her hesap kirlenir. AI crawler ekonomisi yazımızda anlattığımız crawl-to-refer oranı da, bir botu engelleme kararı da taklit trafik içeren bir paydaya dayanıyorsa yanlış sonuç üretir.
User-agent bir iddiadır, kanıt değildir; bir AI botunun kimliğini yalnız IP listesi, reverse DNS ya da kriptografik imza kanıtlar.
Hangi AI şirketleri resmî IP listesi yayımlıyor?
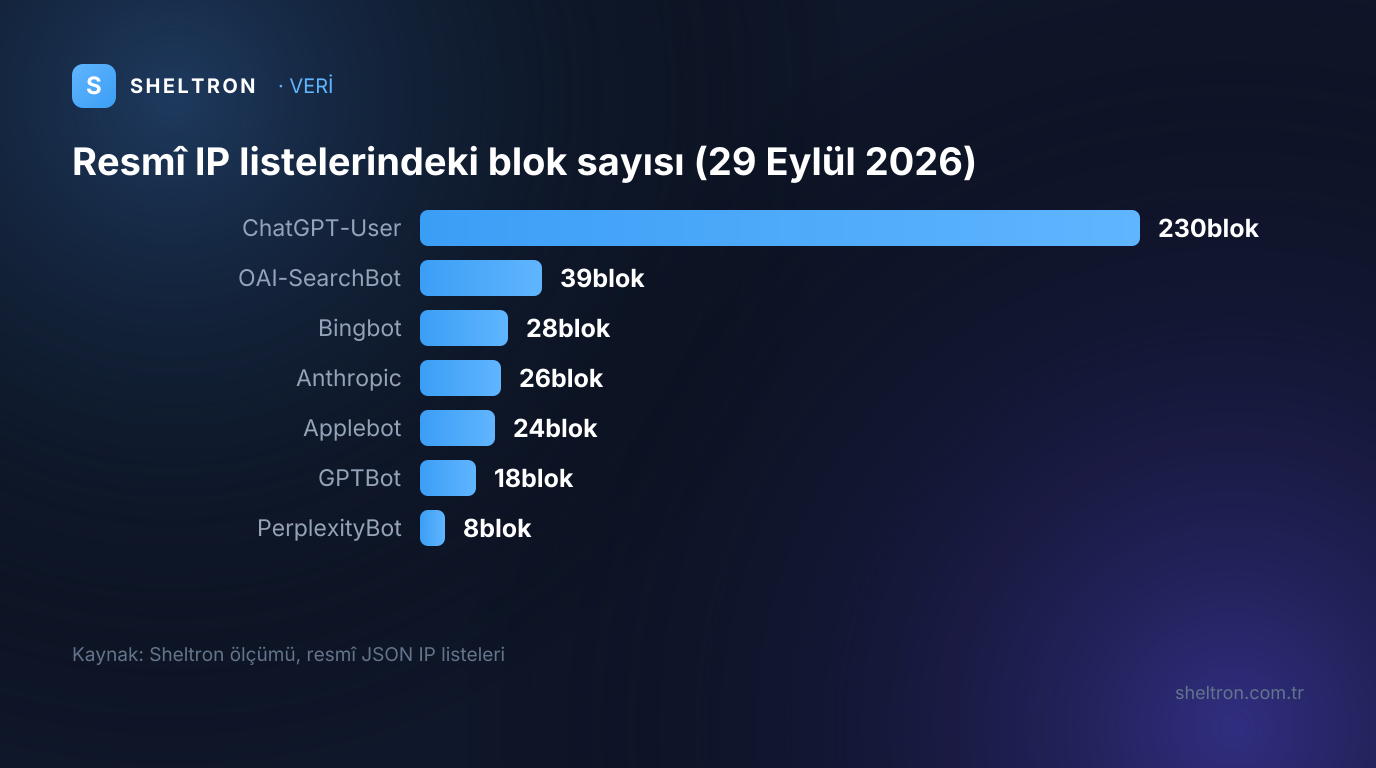
Eylül 2026 sonu itibarıyla Google, OpenAI, Perplexity, Anthropic, Microsoft Bing, Apple, Common Crawl ve DuckDuckGo tarayıcı IP'lerini JSON formatında yayımlıyor; toplam 17 liste var. Listeler boyut ve tazelik bakımından çok farklı: PerplexityBot listesinin tamamı 18 adres, ChatGPT-User listesi 36.432 adres; Bingbot listesinin oluşturulma tarihi ise 3 Ocak 2024.
Aşağıdaki tablo Sheltron ölçümüdür: 17 dosya 29 Eylül 2026'da curl ile indirildi, prefixes dizisindeki bloklar sayıldı, IPv4 adres sayısı blok maskelerinden hesaplandı. rDNS sütunu, aynı gün her operatörün listesinden alınan 1-2 örnek IP ile yapılan testin sonucudur.
| Operatör | Bot / liste | Blok (IPv4 + IPv6) | IPv4 adres | Liste tarihi (creationTime) | rDNS testi |
|---|---|---|---|---|---|
| Googlebot (common-crawlers.json) | 170 + 147 | 5.088 | 28 Eylül 2026 | Çalıştı (googlebot.com) | |
| Özel tarayıcılar ve kullanıcı tetiklemeli fetcher/ajan listeleri (4 dosya) | 1.850 blok | liste bazında değişir | 28 Eylül 2026 | Test edilmedi | |
| OpenAI | GPTBot | 18 + 0 | 2.704 | 22 Eylül 2026 | PTR kaydı yok |
| OpenAI | OAI-SearchBot | 39 + 0 | 2.560 | 2 Ocak 2026 | Test edilmedi |
| OpenAI | ChatGPT-User | 230 + 0 | 36.432 | 25 Eylül 2026 | PTR kaydı yok |
| OpenAI | OAI-AdsBot | 2 + 0 | 256 | 12 Mayıs 2026 | Test edilmedi |
| Perplexity | PerplexityBot | 8 + 0 | 18 | 7 Şubat 2025 | Genel AWS adı |
| Perplexity | Perplexity-User | 4 + 0 | 14 | 17 Ekim 2025 | Genel AWS adı |
| Anthropic | ClaudeBot, Claude-User, Claude-SearchBot (tek dosya) | 26 + 0 | 1.094 | 18 Ağustos 2026 | PTR yok; bir IP'de googleusercontent.com |
| Microsoft | Bingbot | 28 + 0 | 4.736 | 3 Ocak 2024 | Çalıştı (search.msn.com) |
| Apple | Applebot | 24 + 0 | 4.752 | 15 Eylül 2026 | Çalıştı (applebot.apple.com) |
| Common Crawl | CCBot | 4 + 1 | 28 | 11 Ağustos 2026 | Çalıştı (crawl.commoncrawl.org) |
| DuckDuckGo | DuckDuckBot ve DuckAssistBot (2 dosya, içerik aynı) | 486 + 0 (her biri) | 486 | 1 Eylül 2026 | Test edilmedi |
Tablodan dört pratik sonuç çıkıyor:
- Listelerin ölçeği birbirinden çok farklı. ChatGPT-User listesi GPTBot listesinin 13 katından fazla adres içeriyor ve bu adreslerin 32.768'i, yani yaklaşık %90'ı, tek bir /17 bloğunda (9.129.0.0/17). Google'ın 5 listesi toplam 2.167 blok tutuyor.
- IPv6 büyük ölçüde boş. OpenAI, Perplexity, Anthropic, Bing, Apple ve DuckDuckGo listelerinde 0 IPv6 blok var. IPv6 adresinden gelip "GPTBot" ya da "ClaudeBot" diyen bir istek bu listelerle doğrulanamaz. Google'ın Googlebot listesinde 147 IPv6 blok, Common Crawl'da 1 IPv6 blok var.
- Bazı listeler uzun süredir aynı tarihli. Bingbot 3 Ocak 2024, PerplexityBot 7 Şubat 2025, OAI-SearchBot 2 Ocak 2026 tarihli. Eski tarih listenin yanlış olduğunu göstermez; ama o tarihten sonra devreye giren bir IP listede yoksa gerçek bot "doğrulanamadı" sınıfına düşer.
- Bazı botlar IP ile birbirinden ayrılamaz. DuckDuckBot ve DuckAssistBot dosyaları byte düzeyinde aynı. Anthropic'in üç botu da tek dosyada. Bu operatörlerde IP yalnız "hangi şirket" sorusunu cevaplar; "hangi bot" sorusu için user-agent'a bakmak gerekir.
PerplexityBot'un resmî IP listesinde Eylül 2026 sonu itibarıyla toplam 18 adres var; bu 18 adresin dışından gelip "PerplexityBot" diyen bir istek, listeye göre doğrulanamaz.
Google'ın eski dosya yolu (/static/search/apis/ipranges/googlebot.json) 29 Eylül 2026'da hâlâ yeni common-crawlers.json ile aynı 317 bloğu veriyordu. Resmî sayfa ise yalnız yeni yolu gösterdiği için betikleri yeni yola taşımak doğru olur.
Reverse DNS doğrulaması nasıl yapılır ve hangi botlarda işe yarar?
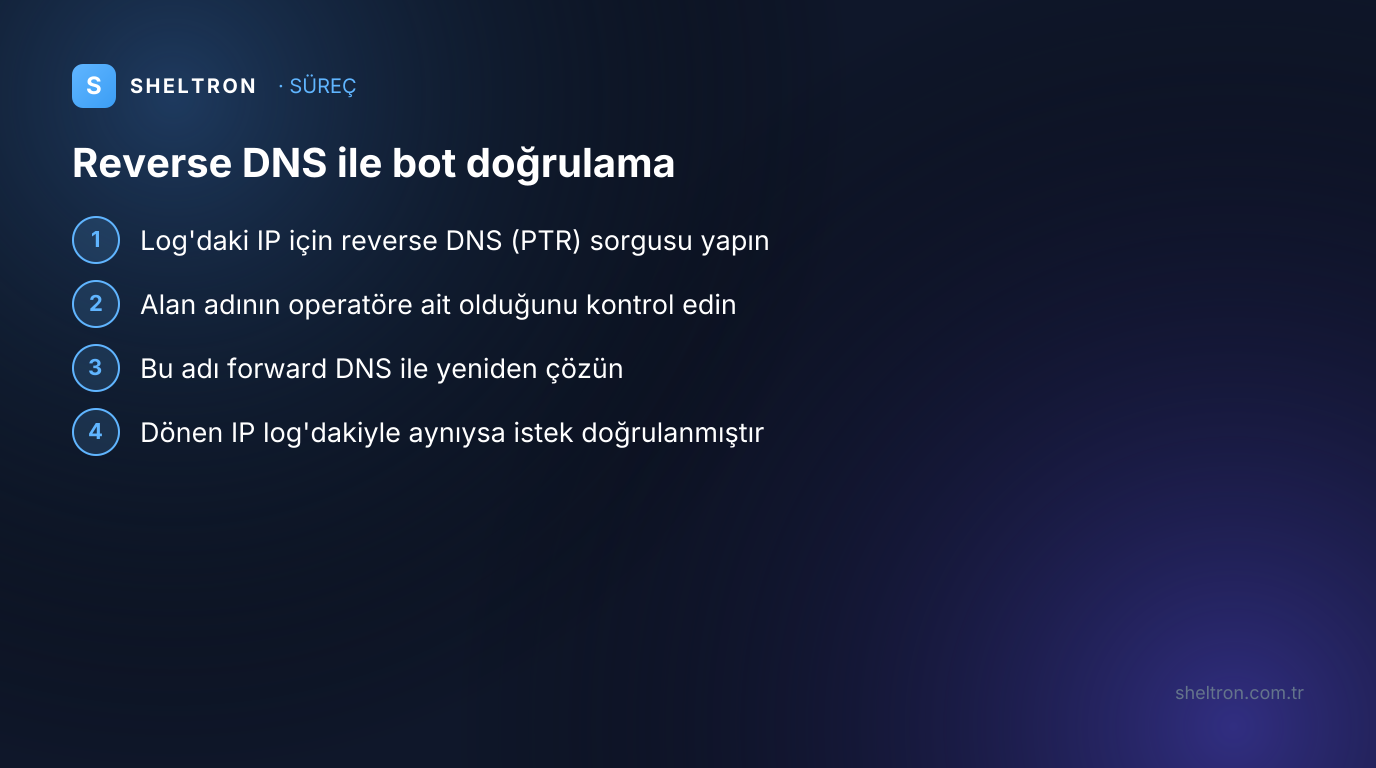
Reverse DNS doğrulaması üç hamleden oluşur: log'daki IP'nin PTR kaydını sorgularsınız, dönen alan adının operatöre ait olduğunu kontrol edersiniz, sonra o adı ileri yönde çözüp aynı IP'ye döndüğünü görürsünüz. 29 Eylül 2026 testimizde bu yöntem Google, Bing, Apple ve Common Crawl'da çalıştı; OpenAI, Anthropic ve Perplexity'de çalışmadı.
Yöntemin resmî tarifini en açık Google veriyor. Google tarayıcılarını doğrulama sayfası Türkçe olarak da yayında ve dört adım sayıyor: IP için ters DNS araması yapın, alan adının googlebot.com, google.com ya da googleusercontent.com olduğunu doğrulayın, bu alan adı için ileri DNS araması yapın, dönen IP'nin log'daki IP ile aynı olduğunu kontrol edin. Google'ın örneği şöyle:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Windows'ta aynı işi nslookup görür. Bing için nslookup 157.55.39.1 komutu msnbot-157-55-39-1.search.msn.com adını döndürdü, bu adın ileri çözümü de yine 157.55.39.1 oldu. Microsoft'un Bingbot doğrulama yazısı alan adının search.msn.com ile bitmesini şart koşuyor; tek bir IP'yi elle kontrol etmek için Bing'in Bingbot'u Doğrula aracı da var.
İleri DNS adımı atlanmamalıdır. PTR kaydını IP bloğunun sahibi yazar; kendi sunucusuna "crawl-…googlebot.com" gibi bir ad atayan biri ilk kontrolü geçebilir. İleri çözümleme ise alan adının sahibinin DNS'inden gelir; googlebot.com altındaki bir ad, sahte sunucunun IP'sine çözülmez.
Testimizin sonuçları şöyle:
| Operatör | Örnek IP (resmî listeden) | Reverse DNS sonucu | İleri DNS | Sonuç |
|---|---|---|---|---|
| 66.249.66.1 | crawl-66-249-66-1.googlebot.com | Aynı IP | FCrDNS çalışıyor | |
| Microsoft Bing | 157.55.39.1 | msnbot-157-55-39-1.search.msn.com | Aynı IP | FCrDNS çalışıyor |
| Apple | 17.241.208.161 | 17-241-208-161.applebot.apple.com | Aynı IP | FCrDNS çalışıyor |
| Common Crawl | 18.97.9.169 | 18-97-9-169.crawl.commoncrawl.org | Aynı IP | FCrDNS çalışıyor (IPv4) |
| OpenAI | 20.171.206.1 (GPTBot), 9.129.0.1 (ChatGPT-User) | Kayıt yok (NXDOMAIN) | — | Yalnız IP listesi |
| Anthropic | 216.73.216.1 | Kayıt yok (NXDOMAIN) | — | Yalnız IP listesi |
| Perplexity | 107.20.236.150, 44.208.221.197 | ec2-…compute-1.amazonaws.com | — | Yalnız IP listesi |
Test operatör başına yalnız 1-2 IP ile yapıldı; bu yüzden tüm adresler için genelleme yapmıyoruz. Test ettiğimiz OpenAI ve Anthropic IP'lerinde PTR kaydı yoktu, Perplexity IP'leri ise herhangi bir AWS müşterisinin alabileceği genel bir ad döndürdü. OpenAI'ın tarayıcı dokümanı da doğrulama için yayımlanan IP listelerini gösteriyor. Apple için Applebot sayfası hem applebot.apple.com alanını hem de JSON listesini resmî yol olarak sayıyor. Common Crawl ise IPv6 üzerinde reverse DNS'in henüz desteklenmediğini belirtiyor; IPv6'dan gelen CCBot için liste kullanılmalı.
IP listesiyle doğrulama adım adım nasıl kurulur?
IP listesiyle doğrulama, operatörün JSON dosyasını düzenli olarak çekip log'daki IP'yi dosyadaki CIDR bloklarıyla karşılaştırmaktır. Eşleşme tek başına yetmez; isteğin user-agent'ı da aynı botu göstermelidir. Perplexity de bot dokümanında güvenlik duvarı kurallarında user-agent ile IP'nin birlikte eşleştirilmesini öneriyor.
Uygulama beş adımda kurulur:
- Aday IP'leri log'dan çıkarın. Combined log formatında satırın ilk alanı istemci IP'sidir. Siteniz bir CDN ya da yük dengeleyicinin arkasındaysa bu alan CDN'in adresini gösterir; gerçek istemci IP'si
X-Forwarded-Forya da CDN'in kendi başlığındadır. - Resmî listeleri çekip saklayın. Her dosya
creationTimealanı veipv4Prefixya daipv6Prefixiçeren birprefixesdizisinden oluşur. Listeleri günlük çekip önceki sürümle birlikte saklamak, geçmiş log'ları o günün listesiyle kontrol etmenizi sağlar. - CIDR eşleştirmesi yapın. Her IP'yi, iddia ettiği botun listesindeki bloklarla karşılaştırın.
- User-agent ile listeyi çapraz kontrol edin. GPTBot diyen isteğe gptbot.json, ChatGPT-User diyen isteğe chatgpt-user.json uygulanır. Anthropic'te tek dosya var; üç bot da aynı listeye bakar.
- Sonucu üç sınıfa yazın. Doğrulandı, doğrulanamadı, yöntem yok. Üçüncü sınıf, listesi ya da reverse DNS alanı bulunmayan operatörler içindir.
Aday IP'leri çıkarmak için genel bir örnek (log formatı sunucuya göre değişir):
grep -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|PerplexityBot' access.log \
  | awk '{print $1}' | sort | uniq -c | sort -rn | head -50
Eşleştirme için bağımlılık gerektirmeyen bir Node.js betiği yeterli. Aşağıdaki örneği Node 18 ve üzerinde, 29 Eylül 2026'da çalıştırdık: 20.171.206.1 adresi gptbot.json içinde bulundu, 1.2.3.4 bulunmadı.
// dogrula.mjs — IPv4 adresini OpenAI'ın GPTBot listesiyle eşleştirir
const toInt = (ip) => ip.split(".").reduce((a, o) => (a << 8n) + BigInt(o), 0n);
const inCidr = (ip, cidr) => {
  const [base, bits] = cidr.split("/");
  const mask = bits === "0" ? 0n : ((1n << 32n) - 1n) ^ ((1n << BigInt(32 - +bits)) - 1n);
  return (toInt(ip) & mask) === (toInt(base) & mask);
};
const list = await (await fetch("https://openai.com/gptbot.json")).json();
for (const ip of ["20.171.206.1", "1.2.3.4"]) {
  const ok = list.prefixes.some((p) => p.ipv4Prefix && inCidr(ip, p.ipv4Prefix));
  console.log(ip, ok ? "gptbot.json içinde" : "listede yok");
}
Betik yalnız IPv4 bloklarına bakar; Google listelerindeki IPv6 blokları için IPv6 destekli bir IP kütüphanesi gerekir.
Her isteği gerçek zamanlı kontrol etmek gerekiyorsa bu iş CDN ya da güvenlik duvarı katmanına taşınır; raporlama için günlük toplu kontrol çoğu zaman yeterlidir. Bu adımın ölçüm mimarisindeki yerini GEO ölçüm rehberi gösteriyor.
Hangi bot için hangi doğrulama yolu seçilmeli?
Kural basittir: operatör bir reverse DNS alan adı yayımlıyorsa ve test ettiğiniz IP bu ada çözülüyorsa FCrDNS yeterlidir; yayımlamıyorsa tek yol IP listesidir. Google, Bing, Apple ve Common Crawl ilk gruba, OpenAI, Anthropic ve Perplexity ikinci gruba giriyor. Meta için Eylül 2026 itibarıyla resmî sayfada iki yöntemi de göremedik.
| Operatör / botlar | Resmî IP listesi (Eylül 2026) | Reverse DNS alanı | Önerilen yol |
|---|---|---|---|
| Google (Googlebot, özel tarayıcılar, kullanıcı tetiklemeli fetcher ve ajanlar) | Var, 5 JSON | googlebot.com, google.com, googleusercontent.com | googlebot.com ve google.com için FCrDNS; googleusercontent.com çıkarsa JSON ile çapraz kontrol şart |
| Microsoft Bing (Bingbot) | Var, 1 JSON | search.msn.com | FCrDNS ya da "Bingbot'u Doğrula" aracı |
| OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User, OAI-AdsBot) | Var, 4 JSON | Testte kayıt yok | IP listesi + user-agent |
| Perplexity (PerplexityBot, Perplexity-User) | Var, 2 JSON | Testte genel AWS adı | IP listesi + user-agent |
| Anthropic (ClaudeBot, Claude-User, Claude-SearchBot) | Var, tek JSON | Testte kayıt yok ya da genel googleusercontent.com adı | IP listesi; bot ayrımı user-agent ile |
| Apple (Applebot) | Var, 1 JSON | applebot.apple.com | FCrDNS ya da JSON |
| Common Crawl (CCBot) | Var, 1 JSON | crawl.commoncrawl.org (IPv6'da yok) | IPv4'te FCrDNS, IPv6'da JSON |
| DuckDuckGo (DuckDuckBot, DuckAssistBot) | Var, 2 JSON (aynı içerik) | Test edilmedi | JSON; bot ayrımı user-agent ile |
| Meta (Meta-ExternalAgent ve diğerleri) | Resmî sayfada görülmedi | Resmî sayfada görülmedi | Sınırlı: user-agent ve davranış |
En kritik satırlar ortadaki üçüdür. OAI-SearchBot, Claude-SearchBot ve PerplexityBot marka görünürlüğü açısından en önemli botlar arasında; üç operatörde de testimizde reverse DNS yolu kapalı çıktı. Bu botları doğrulamadan raporlayan bir log panosu, taklit trafiği gerçek ilgi gibi gösterebilir.
Kullanıcı tetiklemeli ajanlar ayrı bir dikkat ister. OpenAI, ChatGPT-User için robots.txt kurallarının uygulanmayabileceğini, Perplexity de Perplexity-User'ın robots.txt kurallarını genellikle dikkate almadığını yazıyor. Bu ajanlar bir kullanıcının sorusu üzerine sayfanızı açar ve ayrı IP listelerinden gelir; onları GPTBot gibi arka planda tarayan botlarla aynı sepette saymamak gerekir. Ajan tarayıcı çağında marka görünürlüğü yazımız bu trafiğin neden analytics'te değil sunucu log'unda arandığını anlatıyor.
Doğrulamada en sık yapılan hatalar nelerdir?
En pahalı hata, reverse DNS sonucunda googleusercontent.com gördüğünüzde isteği Google'a ait saymaktır. 29 Eylül 2026 testimizde Anthropic listesindeki bir Google Cloud IP'si tam olarak bu alan adını döndürdü. Diğer sık hatalar goog.json'u Googlebot listesi sanmak, IPv6'yı atlamak, bayat listeyle yanlış pozitif üretmek ve CDN'in IP'sini istemci IP'si sanmaktır.
Tuzağın ayrıntısı şöyle: Anthropic'in resmî listesindeki 34.162.230.222 adresinin reverse DNS sonucu 222.230.162.34.bc.googleusercontent.com. Adres Google'ın genel goog.json ve cloud.json listelerinde de yer alıyor, ama Google'ın tarayıcı ve fetcher listelerinde yok. Google'ın ikinci adımı googleusercontent.com'u kabul ettiği için, alan adına bakıp duran bir kontrol bu isteği Google sayar. Google Cloud'da sanal makine çalıştıran herhangi biri aynı kontrolü geçebilir.
Reverse DNS'te googleusercontent.com görmek isteğin Google'dan geldiğini kanıtlamaz; Sheltron'un Eylül 2026 testinde Anthropic'in Google Cloud'daki bir IP'si tam olarak bu alan adını döndürdü.
| Hata | Belirti | Düzeltme |
|---|---|---|
| googleusercontent.com'u yeterli saymak | Başka bir şirketin bulut IP'si "Google" olarak raporlanır | Bu alan çıkarsa Google'ın user-triggered-fetchers listeleriyle çapraz kontrol yapın |
| goog.json'u Googlebot listesi sanmak | Google Cloud müşterilerinin trafiği Googlebot sayılır | Googlebot için common-crawlers.json kullanın; goog.json yalnız Google'ın genel adres alanıdır |
| IPv6'yı atlamak | IPv6'dan gelen gerçek Googlebot "doğrulanamadı" görünür ya da sahte istekler hiç kontrol edilmez | IPv6 destekli eşleştirme kurun; OpenAI, Perplexity ve Anthropic listelerinde IPv6 blok olmadığını kayda geçin |
| Bayat liste kullanmak | Gerçek bot yeni bir IP'den gelir ve sahte sayılır | Listeleri günlük çekin, creationTime değişimini izleyin, "doğrulanamadı" sınıfını "sahte" diye adlandırmayın |
| CDN IP'sini istemci sanmak | Tüm botlar CDN'in birkaç IP'sinden geliyor görünür | Doğrulamayı gerçek istemci IP'si üzerinde yapın |
| IP ile bot ayırmaya çalışmak | DuckDuckBot ile DuckAssistBot ya da Anthropic'in üç botu karışır | Aynı havuzdaki botlarda IP şirketi, user-agent botu belirler |
| IP engelini opt-out sanmak | Bot robots.txt'yi okuyamaz, tercih kaydedilmez | Tercihi robots.txt'de belirtin, engeli ek önlem olarak düşünün |
Tablonun son satırı ayrıca açıklanmalı. Anthropic, tarayıcı sayfasında IP engellemenin robots.txt dosyasının okunmasını engellediği için opt-out'u her zaman garanti etmeyebileceğini yazıyor. Öte yandan robots.txt de bir erişim denetimi değildir: RFC 9309 bu kuralların bir yetkilendirme biçimi olmadığını açıkça söylüyor. İki araç birbirinin yerini tutmaz. robots.txt tercihinizi beyan eder, IP doğrulaması kimin geldiğini ölçer. robots.txt dosyanızın AI botlarına ne söylediğini Sheltron'un ücretsiz robots.txt AI bot kontrolü aracıyla birkaç saniyede görebilirsiniz.
Yanlış engellemenin de bedeli var: doğrulama hatası gerçek Googlebot'u engellerse dizine ekleme de etkilenir. Tarama sorunlarının indekse yansımasını taranmış ama dizine eklenmemiş sayfalar yazımızda anlattık.
Google-Extended ve Applebot-Extended log'da neden hiç görünmez?
Google-Extended ve Applebot-Extended tarayıcı değil, robots.txt kontrol token'ıdır. Google, Google-Extended'ın ayrı bir HTTP user-agent'ı olmadığını; Apple da Applebot-Extended'ın sayfa taramadığını ve yalnız Applebot'un topladığı verinin nasıl kullanılacağını belirlediğini yazıyor. Log'da bu adla gelen bir istek varsa, tanımı gereği Google ya da Apple'dan gelmiyordur.
Google'ın ortak tarayıcılar sayfası bunu açıkça söylüyor: tarama mevcut Google user-agent'larıyla yapılır, Google-Extended token'ı yalnız robots.txt'de kontrol amacıyla kullanılır. Yani robots.txt'ye User-agent: Google-Extended yazmak bir tercihi beyan eder, ama log'da "Google-Extended" diye bir ziyaretçi hiç belirmez.
Google-Extended ve Applebot-Extended birer robots.txt token'ıdır; sunucu log'unda bu adla gelen her istek, tanımı gereği Google ya da Apple değildir.
Bu ayrımı bizim ölçümümüzde de düzeltmemiz gerekiyor. Sheltron'un bot ölçümü, Ağustos 2026 tarihli iç playbook'umuza göre 13 user-agent pattern'ine dayanıyor ve IP doğrulaması içermiyor; Eylül 2026 itibarıyla pattern listemizde Google-Extended ve Applebot-Extended hâlâ bulunuyor. Crawl-to-refer yazımızdaki log imzası listesi de bu iki adı sayıyor. Bu satırlar gerçek bir tarayıcıyı değil, en fazla bir taklidi yakalayabilir.
Pratik sonuç: Google-Extended tercihinizin uygulanıp uygulanmadığı log'dan okunamaz; log yalnız mevcut Google tarayıcılarından birinin sayfayı taradığını gösterir. Bir adı ölçüm tablosuna eklemeden önce, o adın gerçekten istek gönderip göndermediğini operatörün dokümanından kontrol edin. Log'larla "bot okuyor mu" sorusunu cevaplamanın bir örneği llms.txt gerçeği yazımızda.
WAF ve bot yönetimi araçları doğrulamayı sizin yerinize yapar mı?
Kısmen yapar. AWS WAF Bot Control ve Cloudflare, kimliğini doğrulayabildikleri botları ayrı etiketler; ama varsayılan ayarlar GEO hedefinizle çelişebilir. AWS'nin CategoryAI kuralı, doğrulanmış olsun olmasın eşleşen tüm AI botlarına (Web Bot Auth imzası doğrulanan istekler hariç) varsayılan olarak Block uygular. Bu tek ayar, AI arama tarayıcılarının sitenize erişimini sessizce kesebilir.
AWS WAF Bot Control dokümanı botlara iki temel etiket veriyor: bot:verified ve bot:unverified. Doğrulanmamış bot, kendini tanıtan ama kimliğini bağımsız olarak doğrulamaya yetecek bilgi yayımlamayan bottur; dokümana göre bu tür imzalar taklit edilebilir. Dokümandaki ikinci önemli ayrıntı: Bot Control isteğin geldiği kaynak IP'yi kullanıyor ve iletilen IP (forwarded IP) ayarıyla çalıştırılamıyor. WAF'ın önünde başka bir proxy varsa doğrulama bu proxy'nin adresine bakar.
AWS WAF Bot Control'ün CategoryAI kuralı, Web Bot Auth imzası doğrulananlar dışında, doğrulanmış olsun olmasın eşleşen tüm AI botlarını varsayılan olarak engeller; AI aramalarında görünmek isteyen bir sitenin bu kuralı açık bir kararla yapılandırması gerekir.
Cloudflare tarafında ölçüt, doğrulanmış bot politikasında tanımlı. Bir operatörün doğrulanmış bot sayılması için kimliğini 3 yoldan biriyle kanıtlaması gerekiyor: kriptografik Web Bot Auth imzası, sabit bir user-agent ile yayımlanmış IP listesi ya da reverse DNS. Bunlara ek olarak robots.txt'ye uymak ve makul istek hızında kalmak da şart.
Bu araçların yapamayacağı iş, neyin izinli olacağına karar vermektir. Doğrulanmış GPTBot'u engelleyip OAI-SearchBot'a izin vermek ya da doğrulanmış tüm AI botlarını açıp doğrulanmamışları kısıtlamak bir iş kararıdır. Bu kararın altyapı tarafını CTO'lar için AI arama altyapı kararları yazımızda ele aldık. Pratik öneri şu: kuralların doğrulanmış etiketine mi yoksa yalnız bot adına mı baktığını kontrol edin ve AI kategorisindeki varsayılan eylemi bilinçli olarak seçin.
Liste yayımlamayan botlarda ne yapılabilir, Web Bot Auth neyi değiştirecek?
Resmî IP listesi ya da reverse DNS alan adı bulunmayan bir operatörde kesin doğrulama yapılamaz. Bu durumda trafik user-agent, istek hızı ve davranışla izlenir ve raporda "doğrulanamadı" diye ayrı tutulur. Uzun vadeli çözüm kriptografik imzadır: Web Bot Auth'u Cloudflare ve AWS destekliyor, ama IETF'deki çalışma Eylül 2026 itibarıyla bir standart değil, çalışma grubu taslağı aşamasında.
Meta bu gruba örnektir. Meta'nın tarayıcı sayfası beş tarayıcıyı listeliyor ve bunlardan Meta-ExternalFetcher'ın kullanıcı isteğiyle çalıştığı için robots.txt'yi atlayabileceğini belirtiyor. Eylül 2026 itibarıyla aynı sayfada bir IP listesi ya da reverse DNS yöntemi göremedik. ByteDance (Bytespider), xAI ve Mistral'ın resmî sayfalarını bu araştırmada kontrol etmedik; bu operatörler için "liste yok" değil, "kontrol edilmedi" diyoruz.
Doğrulama yolu olmayan botlar için makul yaklaşım üç maddedir:
- Ayrı sınıfta tutun. Bu trafiği doğrulanmış trafikle toplamayın.
- Davranışa bakın. robots.txt'yi okuyup okumadığı ve istek hızı, user-agent'tan daha çok bilgi verir.
- Oran sınırı uygulayın. Kimliği kanıtlanamayan istemciye sınırsız erişim vermek zorunda değilsiniz.
Web Bot Auth, bu sorunu kaynağında çözmeyi hedefliyor. Cloudflare'in 15 Mayıs 2025 tarihli yazısı IP'ye dayalı kimliğin sınırlarını açıkça sayıyor: aynı IP birden fazla kullanıcı, hizmet ya da şirket tarafından paylaşılabilir ve IP adresleri değişebilir. Önerilen yol, botun her isteği HTTP Message Signatures (RFC 9421) ile imzalaması ve sunucunun bu imzayı operatörün yayımladığı anahtarla doğrulaması. IETF'de Web Bot Auth çalışması, webbotauth çalışma grubunun 1 Eylül 2026 tarihli draft-ietf-webbotauth-httpsig-protocol-00 taslağıyla sürüyor; Eylül 2026 itibarıyla bir standart değil. AWS WAF da web_bot_auth etiketleriyle imzalı istekleri ayırt edebiliyor ve imzası doğrulanan istekler CategoryAI dahil kategori kurallarına takılmıyor.
Testimizdeki googleusercontent.com örneği imzanın neden gerekli olduğunu gösteriyor: paylaşılan bulutta IP ve DNS, "hangi şirket" sorusuna bile her zaman net cevap vermiyor. İmzanın ödeme tarafındaki karşılığını Pay Per Crawl ve Türk siteleri yazımızda, ajanların siteyle konuşma standartlarını ise WebMCP yazımızda anlattık. Ajan trafiğinin genel çerçevesi için otonom ajanlar ve AEO rehberine bakabilirsiniz. İmza yaygınlaşana kadar ise IP listesi ve reverse DNS, elimizdeki en güvenilir iki araç olarak kalıyor.
Doğrulanmış bot trafiği GEO ölçümünü nasıl değiştirir?
Bot analitiği, crawl-to-refer oranı ve güvenlik duvarı kararları ancak doğrulanmış trafikle anlamlıdır. Doğrulanmamış GPTBot satırlarını paydaya koyan bir oran, OpenAI'ın sitenize gösterdiği ilgiyi değil, taklitçilerin ilgisini ölçer. Doğrulama bu yüzden bir güvenlik ayrıntısı değil, AI görünürlük ölçümünün ön koşuludur.
Asgari düzen üç parçadır: bot satırlarını doğrulandı, doğrulanamadı ve yöntem yok diye ayıran bir sınıflandırma; resmî listeleri günlük çeken küçük bir iş; doğrulanmış tarama verisini AI kaynaklı ziyaretlerle yan yana okumak. Talep tarafının ölçümünü GA4 ve GSC ile AI referral modeli yazımızda anlattık; iki taraf birleşince hangi botun gerçekten ziyaretçi getirdiği görünür.
Doğrulanmış tarama yine de yalnız bir girdidir; botun sayfayı okuması, sayfanın bir cevapta kaynak gösterileceği anlamına gelmez. Sheltron'un AiSEO platformu bu yüzden tarama tarafına değil, sitenizin ChatGPT ve Gemini gibi AI platformlarında nasıl göründüğüne ve hangi kaynak atıflarını aldığına bakar. GEO'nun teknik temellerini ekibinizle öğrenmek isterseniz GEO Akademi iyi bir başlangıç noktası.
Log'larınızdaki bot trafiğini doğruladıktan sonra sıradaki soru, bu taramanın AI cevaplarında görünürlüğe dönüşüp dönüşmediğidir. Markanızın AI platformlarında nerede durduğunu görmek için Sheltron'un hızlı değerlendirmesiyle başlayın; diğer ücretsiz kontroller araçlar sayfasında.
Ajans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
Sıkça Sorulan Sorular
SHELTRON Insight Summary
LLM-Readable- Konu
- Sahte GPTBot'u Nasıl Ayırt Edersiniz? AI Botlarını IP Aralığı ve Reverse DNS ile Doğrulama
- TL;DR
- Log'da GPTBot yazması isteğin OpenAI'dan geldiğini kanıtlamaz. 29 Eylül 2026 indirmesine göre 8 operatör 17 resmî tarayıcı IP listesi yayımlıyor. Operatör başına 1-2 örnek IP ile yaptığımız testte reverse DNS Google, Bing, Apple ve Common Crawl'da çalıştı; OpenAI IP'lerinde PTR kaydı yoktu; Anthropic ve Perplexity IP'leri ya kayıt vermedi ya da yalnız genel bir bulut adı döndürdü. PerplexityBot listesinin tamamı 18 adres, Bingbot listesi 3 Ocak 2024 tarihli.
- Ana Çıkarımlar (8)
- User-agent istemcinin kendi beyanıdır; Thales/Imperva'ya göre 2024'te otomatik trafik tüm web trafiğinin %51'ine ulaştı ve bu ortamda bot adı tek başına kimlik kanıtı değildir.
- 29 Eylül 2026 indirmesine göre 8 operatör 17 resmî tarayıcı IP listesi yayımlıyor: Google 5, OpenAI 4, Perplexity 2, DuckDuckGo 2, Bing, Anthropic, Apple ve Common Crawl birer.
- Reverse + forward DNS testi Google, Bing, Apple ve Common Crawl'da çalıştı; test edilen OpenAI IP'lerinde ve Anthropic'in 216.73.216.0/22 bloğundaki IP'de PTR kaydı yoktu; Anthropic'in Google Cloud IP'si yalnız genel googleusercontent.com, Perplexity ise genel bir AWS adı döndürdü (operatör başına 1-2 örnek IP).
- Listeler çok farklı ölçekte: PerplexityBot 18 adres, GPTBot 2.704 adres, ChatGPT-User 36.432 adres; Bingbot listesi 3 Ocak 2024, PerplexityBot listesi 7 Şubat 2025 tarihli.
- OpenAI, Perplexity, Anthropic, Bing, Apple ve DuckDuckGo listelerinde IPv6 blok yok; IPv6'dan gelen ve bu botları iddia eden istek listeyle doğrulanamaz.
- Reverse DNS'te googleusercontent.com görmek yetmez: Anthropic listesindeki bir Google Cloud IP'si tam olarak bu adı döndürdü; bu sonuç Google'ın fetcher listeleriyle çapraz kontrol edilmelidir.
- Google-Extended ve Applebot-Extended birer robots.txt token'ıdır; log'da bu adla gelen istek tanımı gereği Google ya da Apple değildir.
- AWS WAF Bot Control'ün CategoryAI kuralı, Web Bot Auth imzası doğrulananlar dışında, doğrulanmış olsun olmasın eşleşen tüm AI botlarını varsayılan olarak engeller; varsayılan eylem bilinçli olarak seçilmelidir.
- Kaynaklı Veriler
- %51 — 2024'te otomatik (bot) trafiğin tüm web trafiği içindeki payı (Thales / Imperva 2025 Bad Bot Report, 2025)
- %37 — kötü niyetli botların tüm internet trafiğindeki payı (2023'te %32) (Thales / Imperva 2025 Bad Bot Report, 2025)
- 17 — Eylül 2026 sonunda 8 operatörün yayımladığı resmî tarayıcı IP listesi sayısı (29 Eylül 2026 indirmesi) (Sheltron ölçümü — resmî JSON IP listeleri, 2026)
- 18 — PerplexityBot resmî listesindeki toplam IPv4 adres (8 blok, liste tarihi 7 Şubat 2025) (Perplexity perplexitybot.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 2.704 — GPTBot resmî listesindeki IPv4 adres (18 blok, IPv6 yok) (OpenAI gptbot.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 36.432 — ChatGPT-User resmî listesindeki IPv4 adres; 32.768'i tek bir /17 bloğunda (OpenAI chatgpt-user.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 1.094 — Anthropic'in ClaudeBot, Claude-User ve Claude-SearchBot için yayımladığı tek listedeki IPv4 adres (26 blok) (Anthropic bots.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 317 — Googlebot listesindeki blok sayısı (170 IPv4 + 147 IPv6) (Google common-crawlers.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 4.736 — Bingbot resmî listesindeki IPv4 adres (28 blok, liste tarihi 3 Ocak 2024) (Microsoft Bing bingbot.json (Sheltron indirmesi, 29 Eylül 2026), 2026)
- 20-25 milyon — Perplexity'nin beyan edilen tarayıcısının günlük isteği; beyan edilmemiş tarayıcı günde 3-6 milyon istek yaptı (Cloudflare Blog, 2025)
- 3 — Cloudflare'de doğrulanmış bot sayılmak için kimliği kanıtlama yolu: Web Bot Auth imzası, yayımlanmış IP listesi, reverse DNS (Cloudflare Verified bots policy, 2026)
- Arama Niyetleri
- ai bot doğrulama ip aralığı
- gptbot ip adresleri
- perplexitybot ip listesi
- sahte googlebot tespiti
- reverse dns bot doğrulama
- user agent taklidi bot trafiği
- claudebot ip listesi
- Yayıncı
- Sheltron Teknoloji · Türkiye'nin İlk GEO Teknoloji Şirketi
Eren Çöp
Kurucu & GEO Stratejisti
Dijital pazarlama ve SEO alanında 5 yıllık uygulayıcı deneyimini, 2024'ten itibaren Generative Engine Optimization (GEO) disiplinine taşıdı. Sheltron Teknoloji'yi TÜBİTAK BİGG desteğiyle kuran Eren Çöp, Türkiye'nin ilk GEO teknoloji şirketini Yıldız Teknopark'ta faaliyete geçirdi. Edtech, kurumsal itibar yönetimi ve iş geliştirme geçmişiyle, işletmelerin ChatGPT, Perplexity ve Gemini'de görünür olma stratejilerini şekillendiriyor. 146+ firmada AI görünürlük testi ve optimizasyon yürüttü.
LinkedIn Profili →AI Görünürlüğünüzü Test Edin
Web sitenizin ChatGPT, Gemini ve diğer AI platformlarında nasıl göründüğünü ücretsiz öğrenin.
Ücretsiz Analiz AlAjans desteği mi arıyorsunuz? Partner GEO ajansımız Lein Digital.
İlgili Yazılar
Bu yazıyla başlayın
Konuyla ilgili ücretsiz araçlarımız ve kapsamlı rehberlerimiz